
Product
1. OpenAI把GPT-5.6 Sol降价超20%
OpenAI 官号宣布:在继续推能力边界、同时压成本的前提下,未来三个月把 GPT-5.6 Sol 的 API 和 credit 定价下调超过 20%。这不是新模型发布,而是对已上线档位做限时降价,直接改调用账单。官方把降价和「更强也更便宜」绑在一起讲,说明他们在用价格守住 Sol 的用量,而不是只靠评测榜。三个月窗口意味着这是促销窗口,不是永久价目表。企业如果把 Sol 当默认推理档,这窗口里换路由或锁用量会立刻反映到成本。帖里没有给出新旧单价和是否覆盖批量档。
来源:@OpenAI
2. Claude安全扫描换上Mythos 5
Claude 官号称:Claude Security 扫描现已跑在 Claude Mythos 5 上,对所有 Claude Enterprise 客户做公开测试。卖点是把他们最强的安全模型直接接到代码库扫描,不必再单独开通另一个模型。这是把安全能力从「另买一只模型」收进企业套餐默认路径。公开测试意味着配额、误报率和覆盖范围都还可能改。对企业的实际含义是:安全扫描开始跟旗舰模型同代,而不是长期停在旧档。帖里没有给检出率、语言覆盖或和旧扫描器的对照数字。

来源:@claudeai
3. Claude Code露出self-hosted runner
非官方变更追踪写到 Claude Code 2.1.241:CLI 模型列表新增 claude-self-hosted-runner。距离 2.1.240 只隔约 17 小时 39 分,包体积大约多 97KB,提示词文件加 3 个、token 加约 1.2 万。官方 changelog 同期只写了 bug 修复和稳定性。名字本身比官方说明更有信息量:他们在把自托管 runner 当成一等模型入口往 CLI 里塞。这还不是发布说明里的功能介绍,只是表面暴露。是否对所有账号可见、跑的是谁的权重,追踪帖没有证实。
来源:GitHub
4. Pi官方包支持本地语音输入
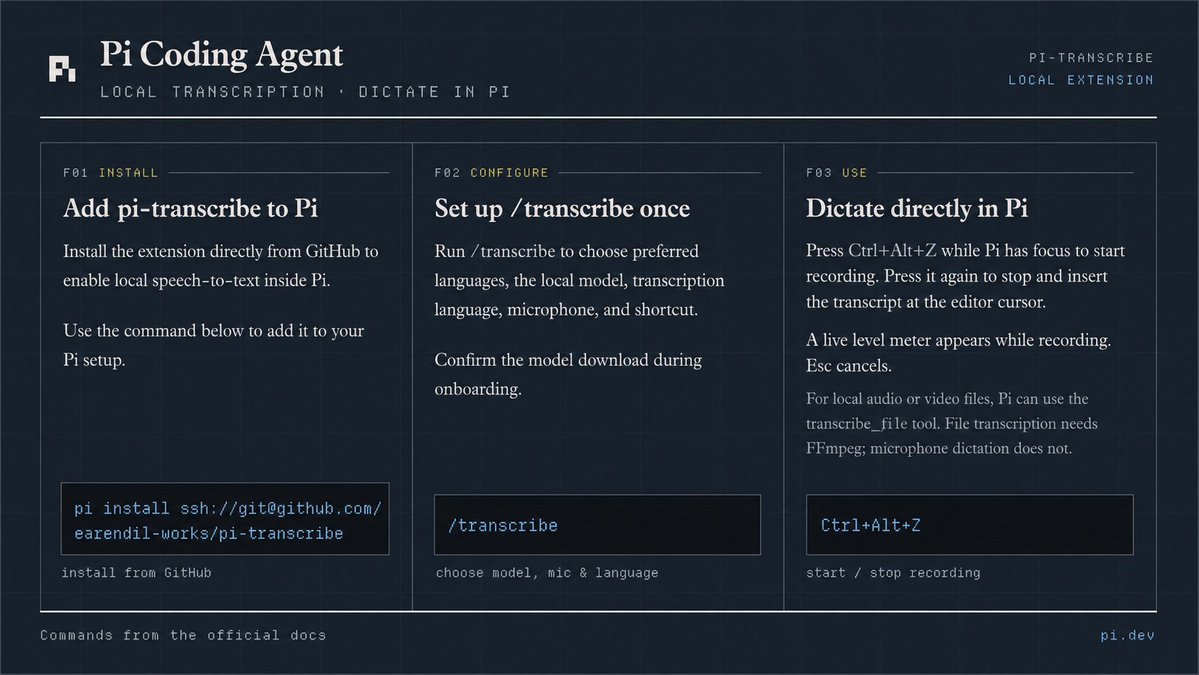
Pi 官方介绍 pi-transcribe:在 Pi 里做本地语音转写。安装后用 /transcribe 选本地模型和语言,默认 Ctrl+Alt+Z 开始或结束口述,音频在本地转写并插入光标。扩展还注册 transcribe_file,让 agent 转写本地音视频;任务共用一个已加载模型。快捷键是终端绑定,不是系统全局热键。这是把「会打字的编码 agent」补上本地听写,且不把声音送上云。仓库写明取消录音用 Esc,未选模型前配置不变。
来源:GitHub
Tutorial
1. Anthropic内部常用的ELI5技能
AIGCLINK 介绍 Anthropic 内部最近常用的技能 ELI5:输入一个主题,模型生成 HTML 页面,大图少字,小白也能看懂,交付物是可打开、可滚动的网页。原始说法来自 Anthropic 的 Thariq:把对象设定成「对这题一无所知的人」,并用 HTML artifact 呈现。这和普通「讲简单点」不同,它规定了媒介和版式,而不是只改语气。DAIR 同期也在 playground 里用 Pi 和 Ox Alpha 试这个技能。技能开始从提示词变成可展示的教具。效果取决于图是否真在解释,而不是装饰。
来源:@aigclink
2. Raschka拆解Claude文本水印怎么做
Sebastian Raschka 放出 48 分钟讲解、50 多页幻灯和逐字稿,讲 Claude 如何给生成文本加水印。他从常规采样讲起:水印不是另做昂贵后处理,而是在采样时用密钥和前文推出随机种子,让近乎可互换的词选择变得可复现,从而留下只有持有密钥的人能检出的统计痕迹。课也覆盖水印如何失败、如何被去掉,以及这会不会让文本变差。动机是事后指认某段话是否来自某个 Claude 模型,对用户不可见。这是目前对官方概念文最完整的从零讲解。
来源:How Claude Watermarks AI-Generated Text
Opinions/Thoughts
1. Harness会收进权重,剩下的是人
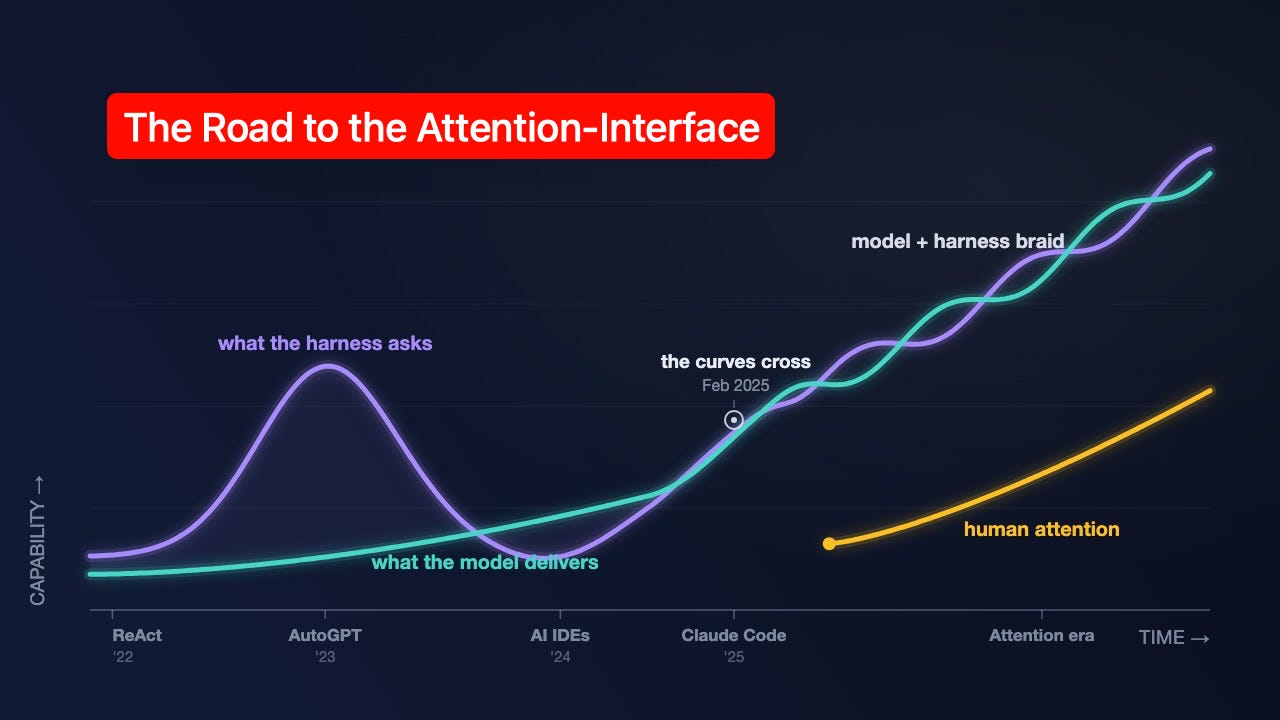
Latent.Space 用两条曲线解释 2025 圣诞前后 agent 突然能用:harness 要求和模型能力终于交叉。ReAct 只是纸上的环,AutoGPT 过早自治,IDE 退回人在环内,Claude Code 在交叉点把环交回模型。同一模型在不同 harness 上可差 23.8 分;只加保留推理和压缩,GPT-5.6 Sol 的 ARC-AGI-3 从 13.3% 到 38.3%。RL 已经在 harness 里训,模型开始把压缩等能力吸进权重,团队就可以删脚手架——有人称删了 Claude Code 系统提示的 80%。删到最后剩下权限、身份、信任和可理解性:harness 从给模型的身体,变成给人的注意力接口。
来源:Latent.Space
2. RSI论文解释模型为何还不能自改进
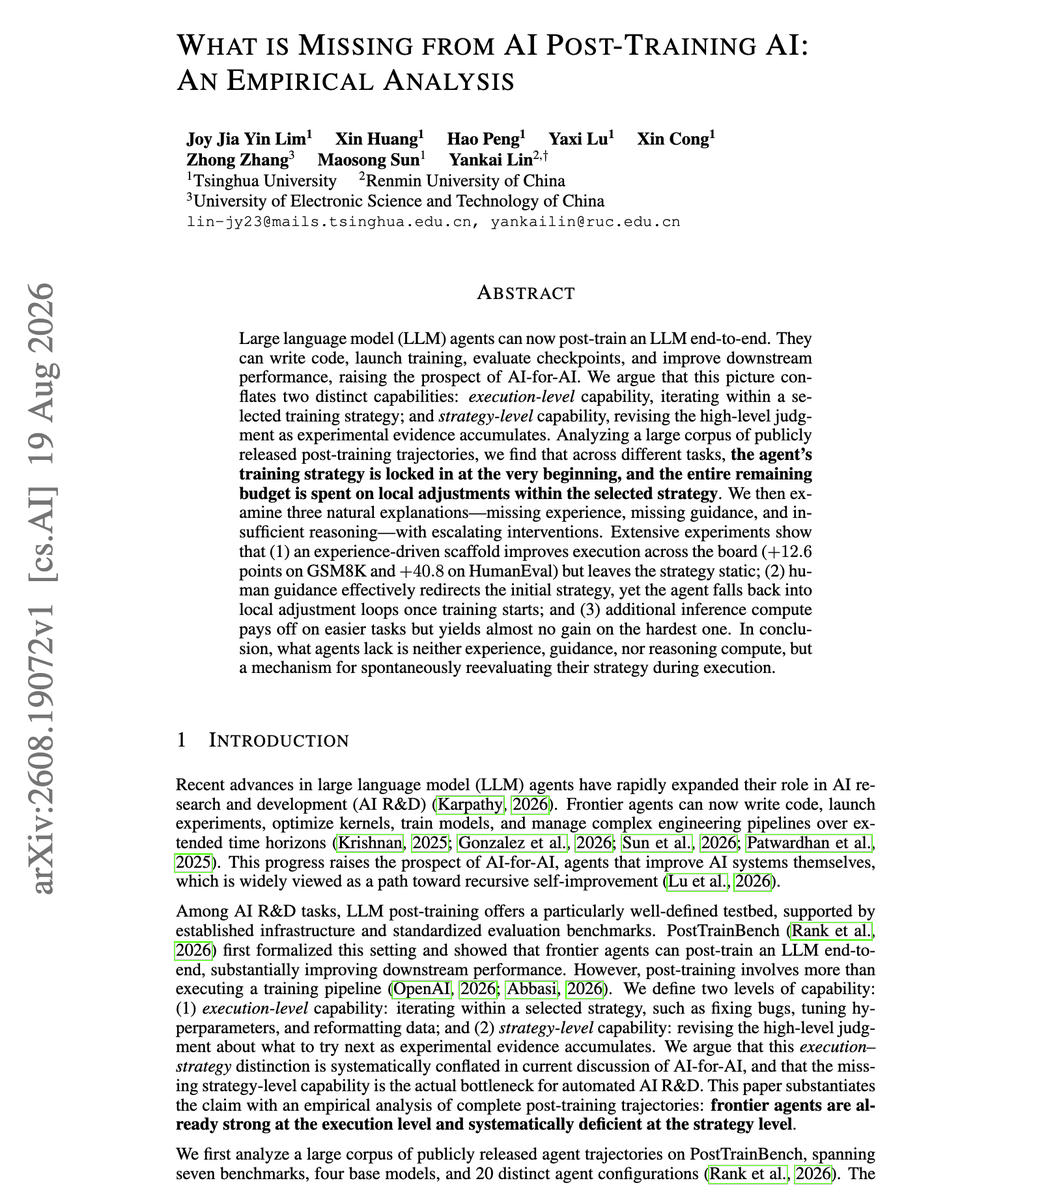
Elvis 推荐一篇追踪递归自我改进(RSI)的论文,理由是这题炒得太热,更该看清当前模型为什么还做不好。他提到的问题从模型「缺乏创造力」开始,后半被截断,因此不能把未写出的机制写成事实。推荐本身的立场很清楚:先理解失败模式,再听自治研究闭环的故事。RSI 若只靠模型自评,很容易变成自我确认;若有编译器或测试等外部判据,改进是有界的。这篇作为阅读入口有价值,细节要以论文为准,不能从一条截断帖还原实验设置。
来源:@omarsar0
3. Agent故障往往始于模型的错误假设
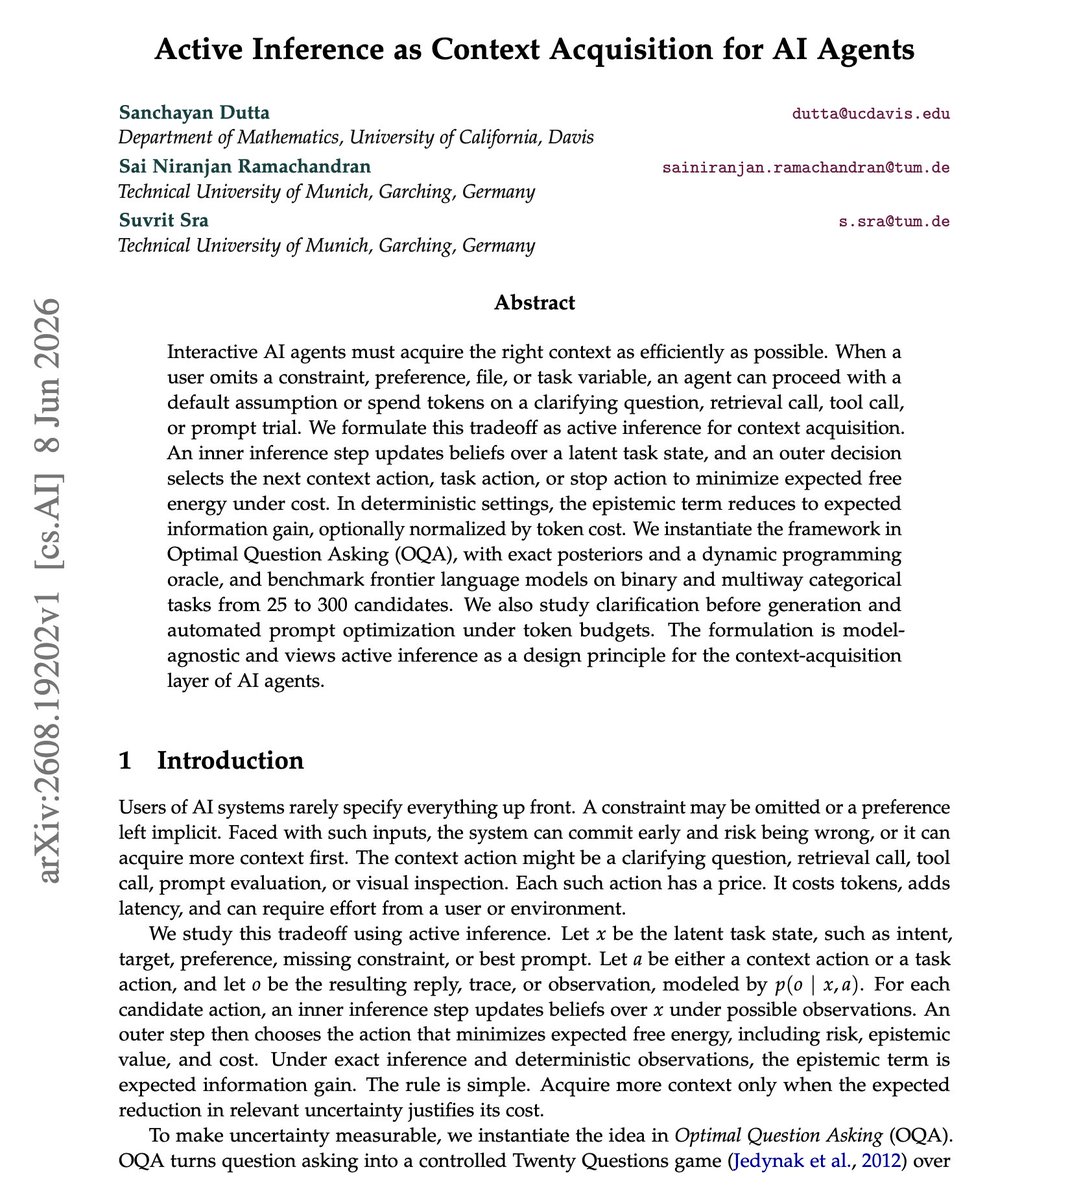
Elvis 推荐一篇关于 AI agent 的论文,核心判断是:今天很多故障来自 LLM 做出的错误假设,并由此走向幻觉、成本浪费和不可靠的工具调用。他认为若能解决假设问题,后续一串症状才会松。帖文在「如果我们能解决」处截断,没有给出方法名或数字。有用的是问题定位:把 agent 失败从「模型不够聪明」改写成「它在错误前提下继续行动」。这比再加一层重试更接近根因。具体算法和基准要以原论文为准。
来源:@omarsar0