
Product
1. Nowledge Mem让各Agent共用记忆
向阳乔木推荐安装 Nowledge Mem,说它能接 Codex 等 agent,用得越多上下文越稳,Vibe Coding 更准。他举的例子是自用 iOS RSS 阅读器:agent 会找回上次交付状态,而不是每次重讲项目。官方 101 页把它定位成跨工具的长期知识层,Codex、Claude Code、Cursor 读同一份记忆。教程从第一条 memory 练起,跨工具工作流还标着即将推出。这是「把你已经知道的事留给未来的自己和 AI」,不是又一个聊天摘要开关。跨工具一致性仍取决于各客户端怎么接,帖里没有对照评测。

2. Is Agentic给网站打Agent友好分
Ding 推荐一个扫描器:输入网址,给站点打「对 agent 是否友好」的分,再把修复建议复制给 agent 去改。站点 Is Agentic 说分数看公开页能否被发现、抓取、理解和操作;必要项覆盖服务端渲染、HTTP 行为、文档结构和可恢复错误。推荐项只在扫到 API、OAuth、GraphQL、MCP 或开发者门户时才计入,没有的接口不算失败。报告提供稳定 URL、Markdown 和 JSON,并有只读 MCP。这是把 llms.txt 之后的「机器可读网站」做成可执行清单。一次扫描不能代表所有模型和登录态。
来源:@dingyi
3. 商汤开源SenseNova-U1.5绘画模型
Gorden Sun 评测商汤开源的 SenseNova-U1.5-8B-MoT。Hugging Face 集合把它标成 Any-to-Any,页面显示约 18B,另有 SFT、LoRA 和 Preview 变体。作者结论是「还差点意思」:汉字只能写对很少,其他方面尚可,并给了模型和在线体验链接。这是开源图像/任意模态模型在中文文字渲染上仍未过关的现场记录,不是官方发布稿。集合页没有在摘要里给出对照榜和许可细节。汉字失败说明「能画」和「能进中文设计稿」仍是两件事。

来源:SenseNova-U1.5 - a sensenova Collection
4. 本周论文把Harness写成一等训练对象
DAIR.AI 汇总 8 月 17–23 日论文,主线是 harness 不再只是外壳。Microsoft 的 Agent Lightning v1.0 用约 3500 行代理,让现有 agent 不用重写就能接 RL,6K 样本把 Qwen3.5-9B 的 SWE-bench Verified 从 41.8% 拉到 56.4%。Skill Trigger Bottleneck 统计公开技能已有 56804 个,却挤在不到 100 个可靠触发位。Harness-Level Forgetting 给「只改提示/工具、模型没动却退步」命名。Control-Plane Tax 测了 10 个应用,一半延迟不在主模型。共同结论:该训练和治理的是整条系统,不只是权重。这是一周论文的编辑综述,不是单篇论文本身。
Tutorial
1. 推测解码笔记:草稿校验且不掉质
Leonie 放出推测解码学习笔记。核心是 draft-then-verify:小草稿机制先提出 3–12 个候选 token,大模型一次前向并行校验,用拒绝采样保住目标分布,所以加速但不降质。直觉是很多 token 很好猜,难的才需要大模型。若整段通过,校验还能顺手产一个奖励 token;中途拒绝则丢掉后面草稿,并从残差分布重采样。文章还串了 Medusa、EAGLE、DFlash、DSpark。这对实时对话和多轮 agent 的延迟瓶颈是正题。笔记是综述,不是新算法发布。

2. Netflix写生产级LLM Judge怎么保真
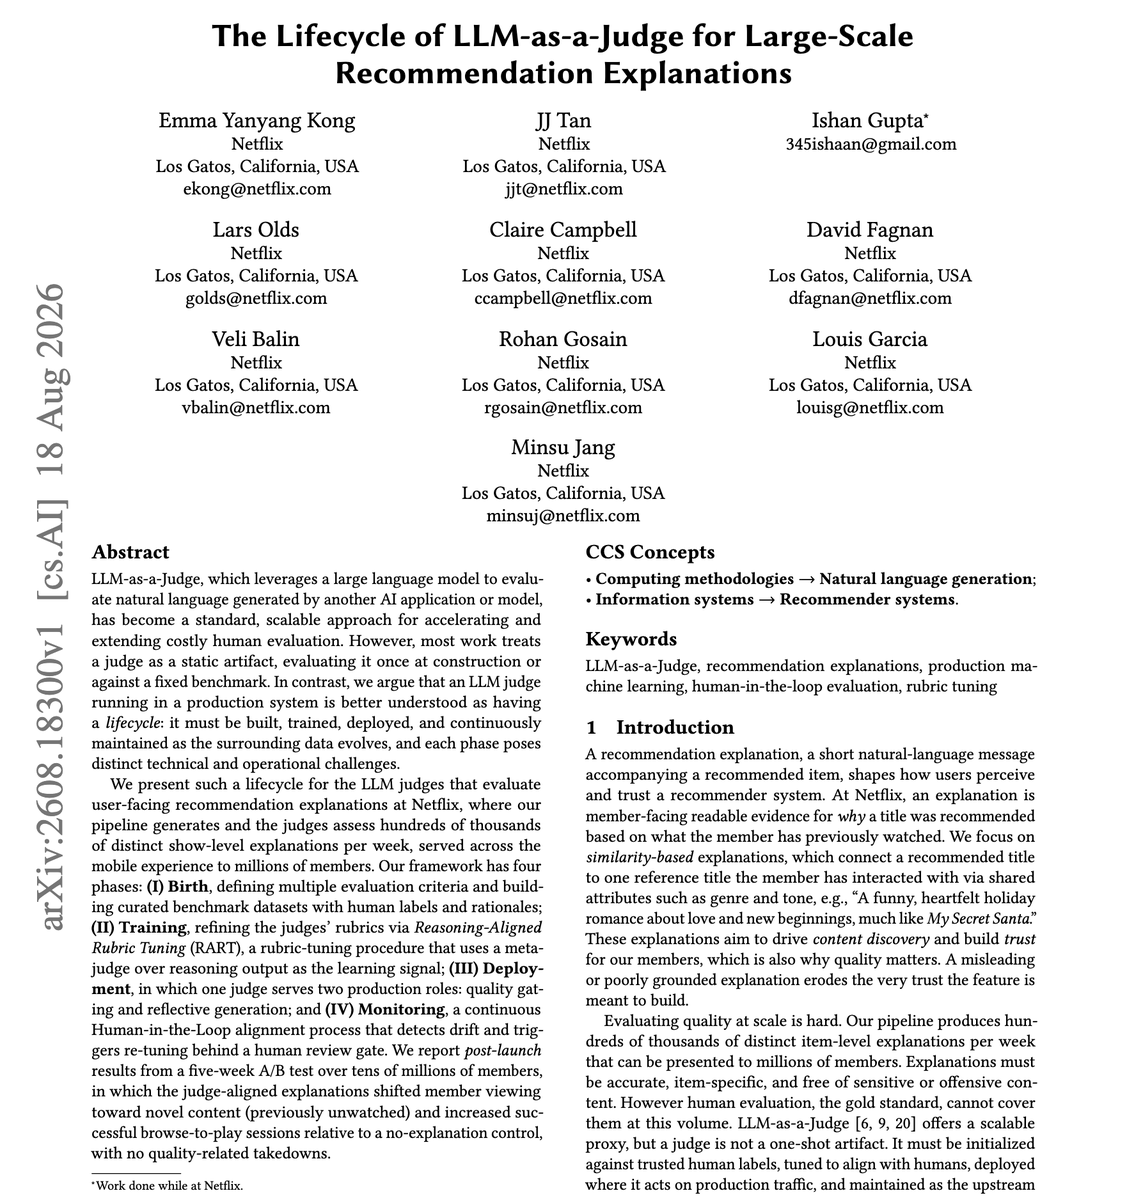
elvis 称这是他见过最有用的生产 LLM judge 笔记。Netflix 每周对几十万条剧集级推荐解释跑 judge,结果送到移动端百万级用户。帖子在「他们描述了……」处截断,所以方法细节不能脑补。能确定的是:judge 已经从评测集走到了每周线上解释的质检,而且规模大到必须谈漂移和维护,而不是一次性打分脚本。对做评估平台的人,价值在「线上解释也要被模型审」。完整做法以原文为准,推文本身不是操作手册。
来源:@omarsar0
3. 代码评审多智能体加人也有收益递减
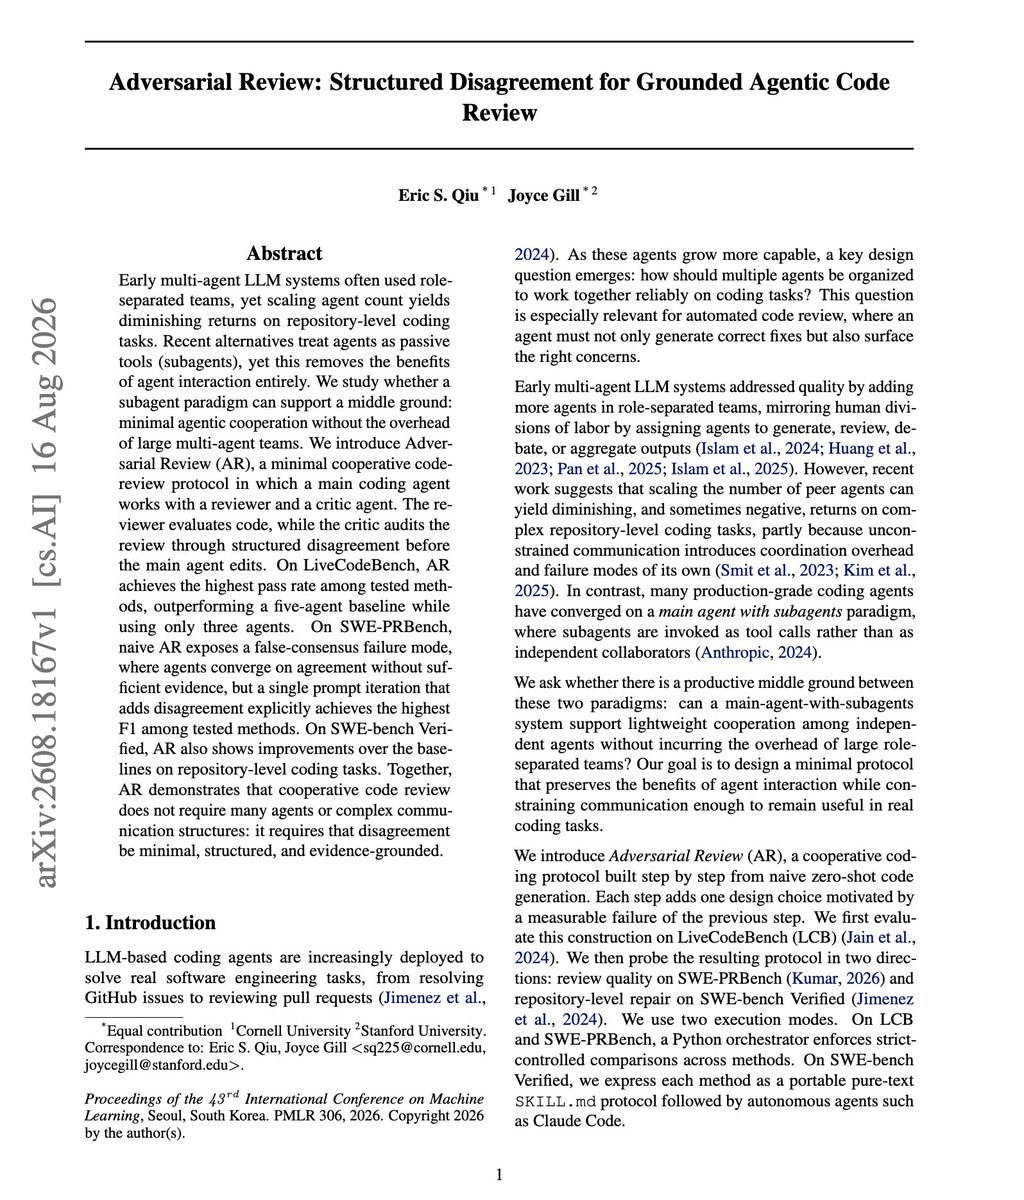
elvis 推荐一篇多智能体代码评审论文。默认补救是评审不行就再加 agent,但扩到很大数量后收益递减。难点正在于:面对一个问题,你不知道该派几个编码 agent。这直接打中现在的「再开一个 subagent」习惯。论文名和具体拐点数字推文里没有给出,不能编造。能用的结论只有方向:评审质量的瓶颈未必是人手不够,而可能是协调和重复劳动。把它当对盲目堆 agent 的警告,而不是一张最优人数表。
来源:@omarsar0
Opinions/Thoughts
1. Codex增长最快的是法律不是科技
a16z 周报写:AI 重度用户已经出现在科技圈外。若用 Codex 采用衡量,今年 2 月以来法律涨 108 倍,销售和招聘 41 倍,市场 26 倍,医疗 24 倍。他们也提醒这可能叠了 Codex 更广的放开。OpenRouter 数据显示 agent 人均 token 约是人类的 5 倍,2 月以来用量约 14 倍,超过 85% 的 agent token 来自缓存前缀。Similarweb 上 n8n、Zapier、Make 访问在掉,Gumloop 在涨。这是主题轮动图,不是审计过的产品数据。法律 108 倍尤其要当成方向,而不是精确市场份额。

来源:Charts of the Week: Winds of Thematic Change
2. Agent让人开始选又快又硬的语言
Armin Ronacher 写:对 agent 来说,人熟不熟悉一门语言不再那么重要,语言选择开始被营销和「要快要小」推动。于是更多人交出 Rust,甚至 Zig——尽管 Zig 社区部分敌视 AI。Cloudflare Artifacts 的纯 Zig Git 协议引擎打成约 100KB Wasm,Vercel 的 fx 也是 Zig 写的小而快编码 agent,这些项目大体是 LLM 辅助。人们还开始碰 DWARF、eBPF、自定义网卡和密码学。Mario 转发时补充:以前硬活要自己做,现在可以只掌舵。这是文化判断,不是基准测试。