
Product
1. Anthropic开预览Model Hardware Standard
Anthropic 开放 Model Hardware Standard(MHS)研究预览:让 AI agent 安全操作实验室和先进制造设备。首批对象是科研实验室和制造商。MHS 可并行控制显微镜、液体处理仪、机械臂等,覆盖从常规药物筛选到量子计算机激光校准。它与 HHMI Janelia 合作起步,目标是把通常要数周到数月的硬件对接压到数小时或数分钟。Agent 可逐步推理实验、实时改参数,有时还能在无人干预下从硬件错误中恢复。官方同时与科学、机器人、电子和制造伙伴一起做安全评估。
来源:Previewing the Model Hardware Standard
2. Pipecat开源语音模型PhoneLLM
Pipecat 放出开源语音 agent 模型 PhoneLLM。作者称,在典型语音 agent 任务上接近 GPT 5.6 Terra,延迟约三分之一,成本约十八分之一。语音 agent 同时要极低延迟、会调工具、能跟指令。模型页在 Hugging Face:pipecat-ai/phonellm-alpha-1。页面抓到的主要是 chat template,评测集和权重细节这里看不到。
来源:pipecat-ai/phonellm-alpha-1 · Hugging Face
3. Vercel开源面向Agent的WebGPU库vgpu
Vercel 开源 vgpu:给 agent 用的精简 WebGPU 库。同一套 API 覆盖浏览器画布、无头 Node 和 serverless。可在 CPU 沙箱和 CI 里渲染,并复用 .wgsl 模块。仓库在 vercel-labs/vgpu,npm 包名 vgpu。Agent 可直连只读 MCP;人也可用 npx vgpu examples。站点还提供 agents.md、llms.txt 和 examples 发现接口。它是为了在 v0 上稳定出 shader 才长出来的。
来源:vgpu.sh
4. Hermes Agent可按你的Chrome登录态浏览
Nous Research 让 Hermes Agent 打开 real-profile browsing。它不直接动你的日常浏览器,而是用现有 Chrome 配置的托管副本,带着你的登录态去点网页。文档还列出 Browser Use、Browserbase、Firecrawl、Camofox、Lightpanda 和本地 CDP 等多种后端。页面以无障碍树表示,交互元素带 @e1 这类 ref。这意味着 agent 能进已登录后台,也把 cookie 和会话风险一起带进了代理层。
5. Pollen Robotics开放Microduck预购
Pollen Robotics 的 Microduck 是约 25 厘米开源双足机器人:15 个电机、相机、LiDAR 和可抓取的喙。开箱可玩,也可在仿真里用强化学习训新行为再部署到真机。8 月 27 日开预购,标价 399 美元(税和运费另计),宣称圣诞节前发货。Thomas Wolf 展示了用图像检测跟着激光笔走的实验。强调点是传感器够多之后,新行为可以 vibe-code 出来。
6. Taste Skill用81.5K星打Anti-Slop
Taste Skill 自称给 AI agent 的 Anti-Slop 前端框架,GitHub 星标约 8.15 万。仓库把 13 个 skill 分成代码实现和图像生成两类,用来改布局、字体、动效和间距,而不是再出一套套模板。也包含网页、移动和品牌参考板的生图 skill,生成后再交给 Codex、Cursor 或 Claude Code 落地。安装走 npx skills add。作者声明没有官方代币。同窗口还有专门做老项目 redesign 的子 skill。

来源:GitHub
7. Skild S1声称一条视频就能教机器人
Ben’s Bites 记到:Skild 的 S1 能从一条视频教会机器人新任务。本条没有成功率、任务类型和要不要额外标注。若属实,示范数据从「大量轨迹」降到「一段视频」。独立评测和失败案例这里都没有,只能当产品主张。
8. 智谱揭晓GLM-5.3-Flash就是Ox Alpha
Ben’s Bites 记到:GLM-5.3-Flash 揭晓了 Ox Alpha 的身份,并称它是 GPT-5.6-Luna 的很好开源替代。本条只有这一句,没有参数、价格和评测表。昨日已有第三方智力-成本曲线;今天这条指向智谱自己的博文。具体数字要以 z.ai 原文为准,这里不补。
Tutorial
1. 一篇把LLM推理拆成Prefill和Decode
Avi Chawla 的 X 长文把一次 generate() 拆成两段:prefill 吃 prompt,受算力限制;decode 逐 token 生成,受显存带宽限制。优化要对准瓶颈,而不是两边一起拧。文内从 BPE、RoPE、注意力和 FFN 走到最后投影。推文另外给出量化入口:70B 的 FP16 权重约 140GB,4-bit 约 35GB;但大模型上傻四舍五入会失败,大约 0.1% 的隐层维度能到 20 倍大。量化技巧列表在帖里被截断。
来源:How LLM Inference Works, Clearly Explained.
2. AddyOsmani教你审计Agent配置文件
Addy Osmani 写:编码 agent 的配置有半衰期。模型、harness 和仓库都在变,旧指令会留下并伤害质量。他建议每隔几周跑 Claude 的 /doctor,记忆用 /memory 另审,让每条指令重新证明自己该留下。一项 100 个热门仓库的研究里,lint 泄漏 62%,上下文膨胀 42%,skill 泄漏 35%。另一项 288 次、17 个真实任务的实验里,AGENTS.md/CLAUDE.md 没有明显提高正确率,但会改变怎么跑测试。个性化 skill 也不如更泛的社区 skill 稳。官方建议隔几个月删掉重建;他的办法是先归档,硬约束写进测试、hook 或权限。
来源:Elevate
3. Taste Skill拆出老项目Redesign流程
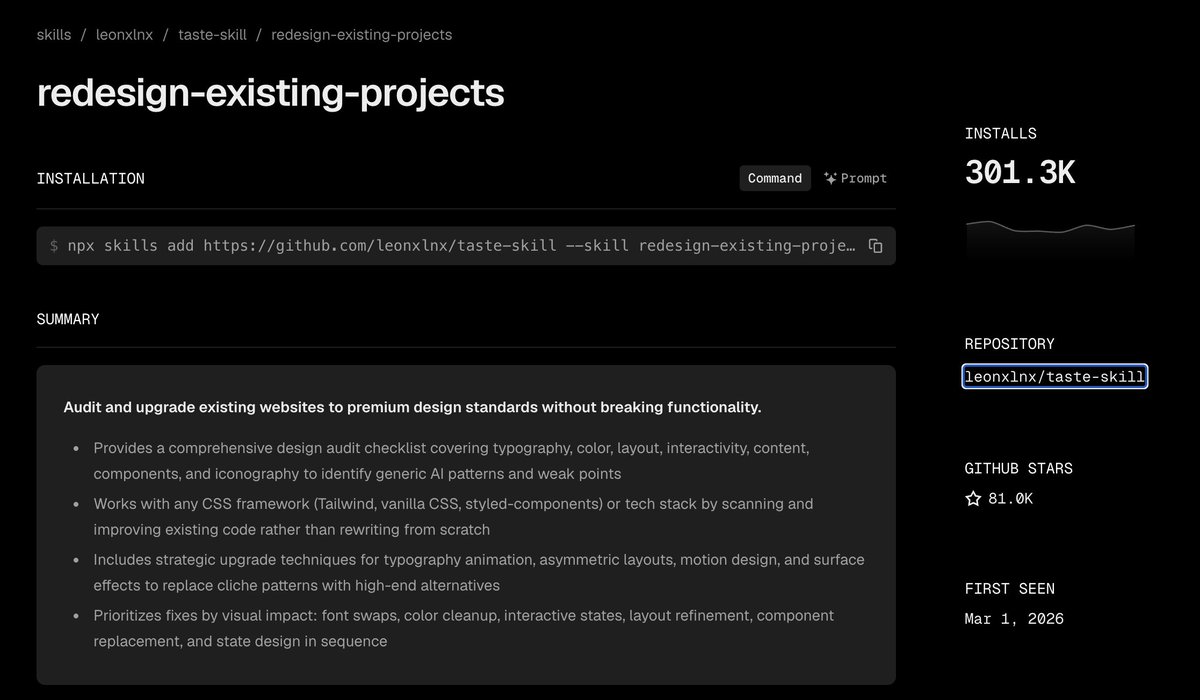
taste-skill 的 redesign-existing-projects 专门改已有站点,而不是重写。三步是 Scan、Diagnose、Fix:先认框架和样式方案,再按字体、颜色、布局、交互和组件做审计,最后在现有栈上打补丁。安装:npx skills add 该仓库并指定这个 skill。作者在一个项目上试过,觉得可用,还要再深用。它针对的是 AI 站点的套模板痕迹,而不是从零生成新视觉。
来源:redesign-existing-projects — leonxlnx/taste-skill
Opinions/Thoughts
1. Linear用1000多个PR迁到StyleX
Linear 工程师 Kenneth Skovhus 写:他们花了 1000 多个 PR,把 React 应用从 styled-components 迁到 StyleX。灵活曾经是优点,后来变成可从外部改样式的负债;改版后留下一长串 UI 回归。他们要给人和 agent 都更清楚的样式边界。另一条原因是性能:CSS-in-JS 在渲染时生成并注入规则,升级 React 18 并发后回归更明显。这不是一篇 CSS 教程,而是在说:agent 会写代码时,组件合约必须先变硬。