
Product
1. OpenAI 大幅下调 GPT-5.6 价格,Luna 降价 80%
OpenAI 宣布全线下调 GPT-5.6 系列定价,以推动模型前沿在成本效率、能力与速度上的整体进步。其中 Luna 输入价降至每百万 token 0.20 美元、输出 1.20 美元,降幅约 80%;Terra 降价 20%(输入 2 美元、输出 12 美元)。Sol 在 API 中新增 Fast 模式,速度最高提升 2.5 倍、单价翻倍,智能水平保持不变。订阅权益与配额预算不变,同等额度可调用更多次,相当于变相扩容。此举意在把 GPT-5.6 系列推上性价比的帕累托前沿,进一步压低多 Agent、大规模调用的成本门槛。

来源:@OpenAI
2. Google DeepMind 发布具身推理模型 Gemini Robotics ER 2
Google DeepMind 推出迄今最强具身推理模型 Gemini Robotics ER 2,作为机器人的“高层大脑”直连 Gemini Live API。它不仅在前沿模型的具身推理基准上领先,还能在执行当前动作的同时思考并规划下一步,支持亚秒级双向实时机器人视频流。在成功/失败检测上,ER 2 改为处理连续原始视频流而非静态快照,可捕捉泼洒、滑移、错位等执行中途的失败;相关基准达到约 91.3%。模型还支持通用仪表读取、工具调用与网页搜索等能力。这标志着具身智能从“单步操作”走向“持续感知—规划—纠错”的闭环。
来源:@_philschmid
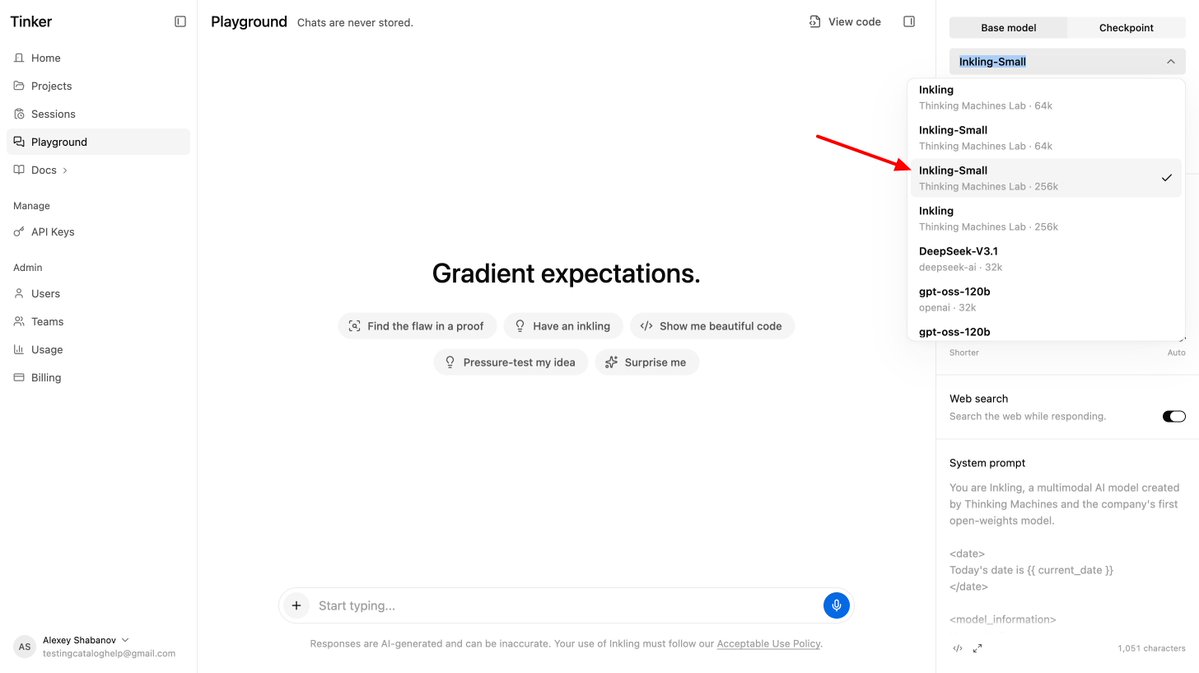
3. Thinking Machines Lab 发布开源权重模型 Inkling-Small
Thinking Machines Lab 发布开源权重模型 Inkling-Small,总参数量约 276B、激活参数约 12B,属稀疏 MoE 架构。模型已在 Hugging Face 与 Tinker Playground 上线,并强调推理速度可观。在中大规模开源模型阵营中,这一规格定位介于轻量与旗舰之间,兼顾容量与单次推理成本。对自托管与研究者而言,它提供了一个可本地、可控成本部署的前沿开源选项。其实测性能与生态适配仍有待社区验证。
4. FLUX 3 预览版上线,可一条提示生成完整短片
Black Forest Labs 发布 FLUX 3 预览版,先在 Nous Research 的 Hermes Agent 上开放 48 小时。Hermes 可把多个镜头串成完整短片,实现“一条提示端到端”的生成流程。双方同步发起短片创作比赛,最佳作品可获得一年免费 FLUX 3 等奖励;FLUX 3 还将在旧金山的线下活动中现场演示。这显示文生视频正从“单段素材”走向“多镜头叙事编排”的 Agent 化工作流。正式版的性能与开放范围尚未完全公布。
来源:@bfl_ai
5. MiniMax 发布 H3 全模态视频模型,字节 Seedance 2.5 同日上线
MiniMax 发布视频模型 H3,定位全模态:可输入文本、图像、视频、声音,输出原生双声道音视频,最高 15 秒 2K 分辨率。作者将其视为 Seedance 的直接竞争者,并指出字节同日上线的 Seedance 2.5 仍领先一大步。值得关注的是,MiniMax H3 后续将开源,有望显著提升可玩性与生态参与度。这反映出国产视频模型正进入“全模态 + 高分辨率 + 开源”的密集竞争阶段。实际生成质量与开源条款仍待发布后检验。
来源:@Gorden_Sun
6. 阿里开源实时语音 Harness:Qwen-Audio-Agent
阿里最新开源了实时语音 Harness Qwen-Audio-Agent,让 Agent 能像打电话一样与人对话——用户边说边想,它边听边执行。其定位是给 OpenCode、OpenClaw、Codex 等编码/Agent 工具“加上耳朵和嘴巴”,从而以通话方式驱动 AI 协作。这把实时语音交互从“独立语音助手”推进到“与现有 Agent 工具链打通”的工程化阶段。对希望用语音操控编码 Agent 的开发者,它提供了一个可直接接入的开源方案。实际延迟与多轮稳定性需在真实场景中验证。
来源:@aigclink
7. Conductor Cloud 上线:云端多人协作 Agent 工作区
charlieholtz 推出 Conductor Cloud,主打用云端多人协作工作区取代本地 worktree。用户可携带自己的订阅、邀请队友、启动 Agent,然后合上笔记本由其在云端继续运行,并通过 iPhone 与 API 进行指挥。这把“本地单人 + 多 worktree”的 Agent 协作模式升级为“云端常驻 + 多人 + 移动端遥控”。产品方向切中了 Agent 长任务需要持续运行、且团队需共享上下文的真实痛点。稳定性与企业级权限等细节仍有待观察。
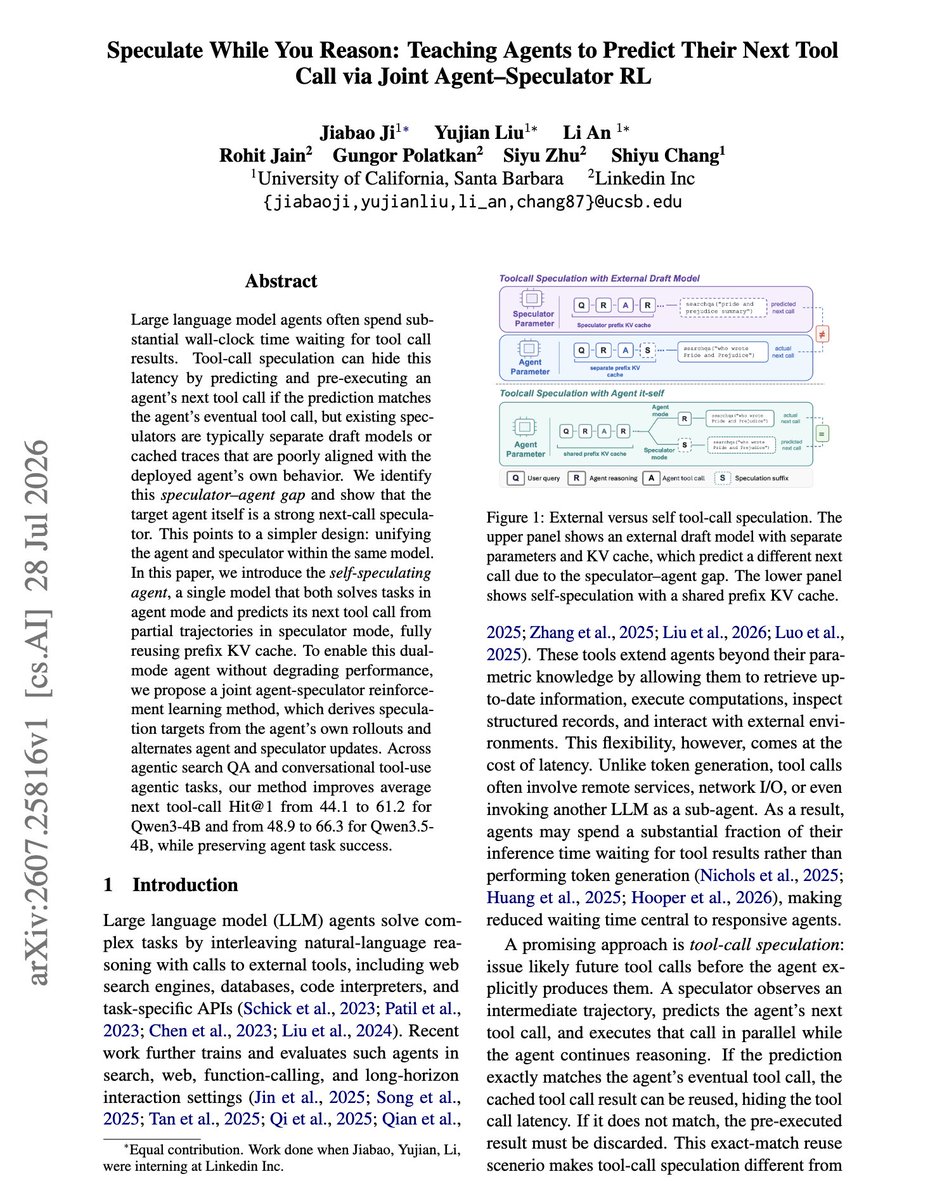
8. 论文:Agent 用“自我推测”隐藏工具调用延迟
一篇新论文提出,Agent 在墙钟时间中很大一部分都耗在等待工具返回结果,而传统的外部草稿模型或缓存轨迹是在“建模另一套策略”,难以有效预执行下一步。研究指出“Agent 自身就是最好的推测器”,即用 Agent 自己预测并预先执行下一个工具调用来掩盖等待延迟。这一思路把推测执行从“模型层”迁移到“Agent 工作流层”,直击 Agent 长时等待这一核心延迟来源。其有效性取决于预测命中率与回滚成本之间的权衡。论文为 Agent 延迟优化提供了新方向。
来源:@dair_ai
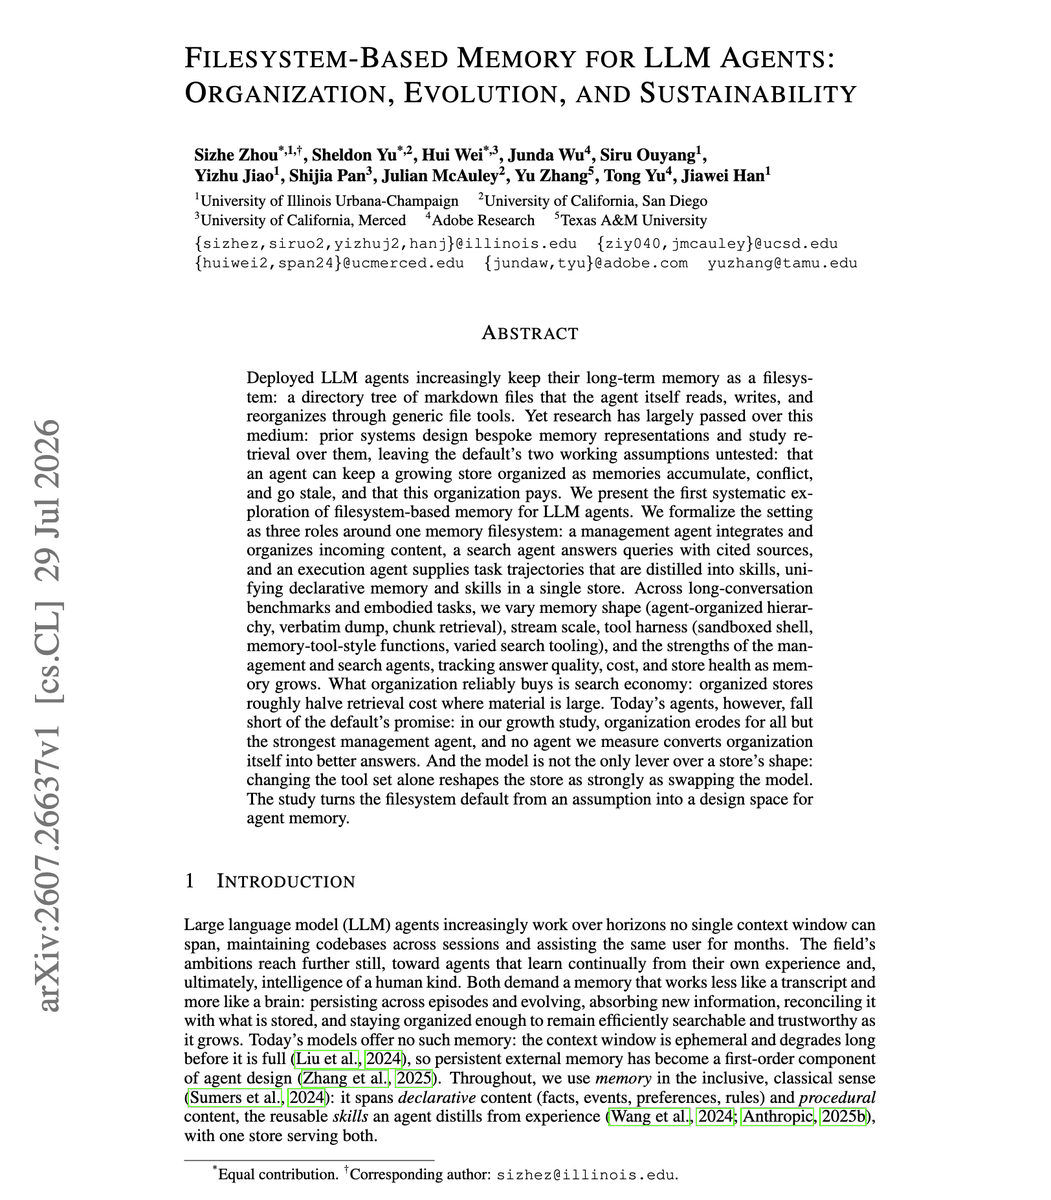
9. 论文:基于文件系统的 Agent 长期记忆到底值不值
一篇新论文系统检验了“用文件系统作为 Agent 长期记忆”这一流行做法——即部署中的 Agent 把长期记忆存为一文件夹 Markdown 文件,再用普通文件工具读取与重整。研究首次实证检验了两个此前从未被验证的假设:这种记忆是否真能提升任务表现,以及其组织与维护开销是否划算。这类工作难得地把“业界默认采用”的 Agent 记忆范式放上实验台审视。结论将直接影响 Agent 记忆系统的设计取舍,为“文件式记忆”提供了首个严肃的评估框架。
来源:@dair_ai
10. Vercel Sandbox:单沙箱内运行多个相互隔离的 Agent
Vercel 推出可在单一沙箱中运行多个相互隔离 Agent 的能力,强调“默认隔离”,并通过 npm i @vercel/sandbox 接入。这让开发者在同一运行环境中并行跑多个 Agent,而不必为每个 Agent 单独 provisioning 独立沙箱。其价值在于降低多 Agent 编排的基础设施复杂度与成本,同时保留隔离安全性。对构建多 Agent 应用的团队,这是一个更轻量的执行底座。资源限额与隔离强度等细节以官方文档为准。

来源:Vercel
11. /wayfinder:让 Agent 规划最宏大项目的探索式工作流
Matt Pocock 介绍 /wayfinder,一种用于规划“最宏大项目”的 Agent 工作流:给定一个目的地后,它会判断当前可决定事项的“前沿”,随推进逐步揭开后续路线,与你共同研究、原型与讨论,并把整体地图维护在一个 issue 跟踪器中。其思路与传统“一次性拆解全部任务”不同,强调在不确定性中边走边规划、只决策当下能决策的部分。这为长周期、高不确定项目的 Agent 编排提供了一种可借鉴的模式。具体实现与所依附产品以作者说明为准。
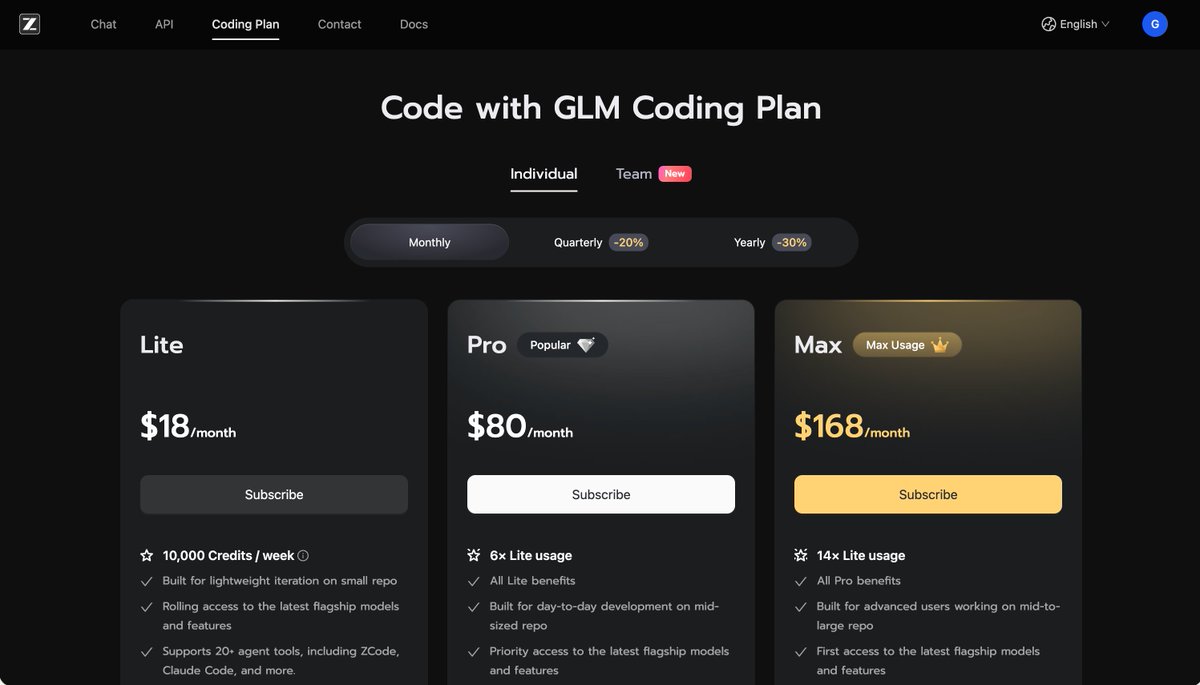
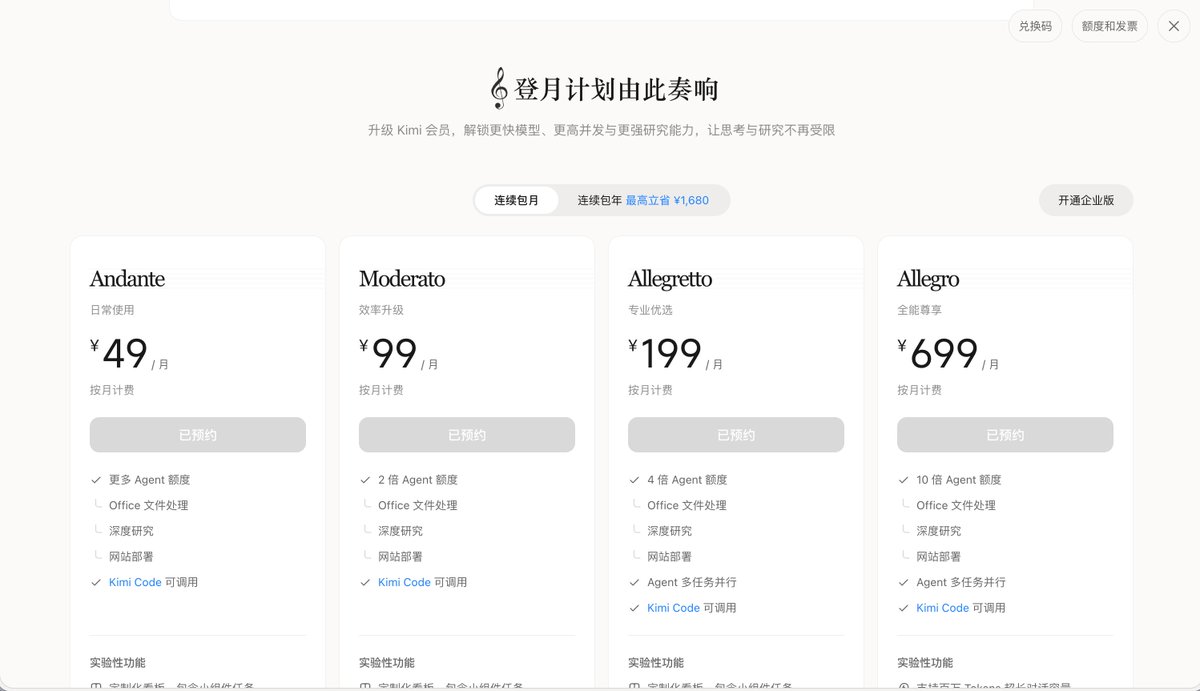
12. 智谱 Coding Plan 开放订阅,但价格全面追平海外版
作者注意到智谱的 Coding Plan 终于可以订阅了,但价格全线上涨,基本与海外版持平,质疑其性价比。对国内开发者而言,这削弱了国产编码 Agent 订阅在此前价格上的吸引力,可能促使部分用户转向 Kimi K3 等其他选项。这也折射出国内编码 Agent 市场正从“低价抢量”走向与海外持平的定价阶段。具体档位与额度以智谱官方为准。

来源:@yanhua1010
Tutorial
1. 两万字长文:Agent Team 的分化逻辑与最佳实践
这是一篇约两万字的 Agent Team 最佳实践长文。文章先回答“一个 Agent 如何变成多个 Agent”:解释真实工作为何把 Task Agent 推向 Long-running Agent,为何一个越来越好用的 Agent 最终必须分化,以及多 Agent 出现后瓶颈为何转移到人。随后展开多 Agent 协作的编排、分工与人在回路等实践。对正在从单 Agent 走向多 Agent 团队的团队,这是一份体系化的实操参考。其结论来自作者半年的 agent team 实践。

来源:@yan5xu
Opinions/Thoughts
1. Luna 降价后输入价已低于 DeepSeek V4 Pro
作者指出,GPT-5.6 Luna 降价 80% 后输入价低至每百万 token 0.20 美元,甚至低于 DeepSeek V4 Pro 的 0.435 美元,但输出与缓存价格仍更贵。这意味着此前分享的 Codex 多 Agent 编排工作流可进一步压低成本:在需要大量输入、对延迟敏感的环节优先用 Luna,兼顾性能与预算。作者也提醒,单纯比单价并不全面,输出价、缓存命中率与实际任务吞吐同样决定总开销。整体看,Luna 的定价让“以闭源前沿模型跑大规模 Agent 编排”在经济上变得前所未有地可行。

来源:@yanhua1010
2. 警惕把理解本身外包给 Agent
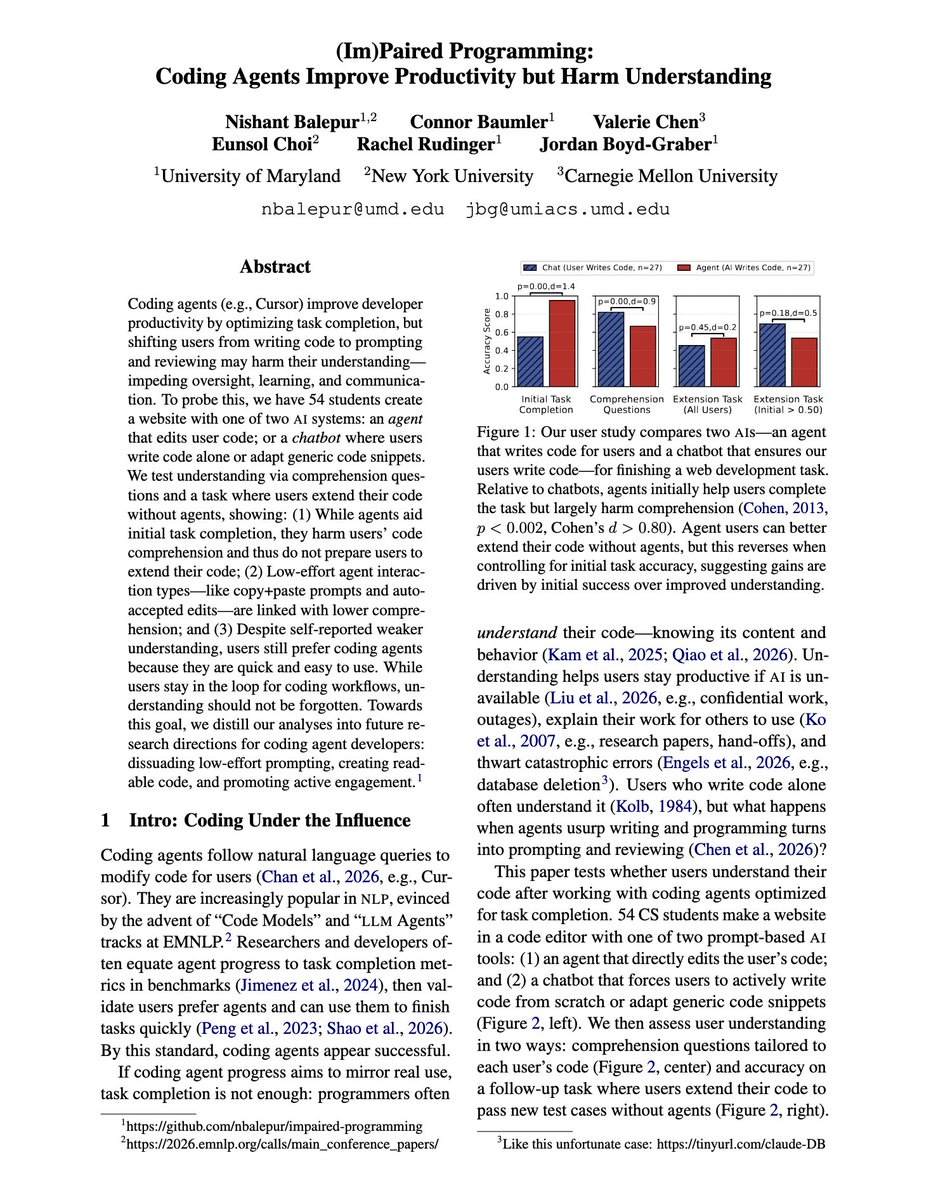
omarsar0 提醒,需要警惕把“理解”本身外包给 Agent。他承认编码 Agent 确实能让开发者更快完成手头任务,但这也可能削弱开发者对系统的深层理解,长期看会侵蚀工程判断力。他同时指出,这恰恰是一个机会:构建那种鼓励更深层理解、而非替代理解的 Agent 应用。这一观点为当下“Agent 提效”的主流叙事提供了一个重要的平衡视角。它关乎工程师能力的长期演化,而非单次效率。
来源:@omarsar0