
Product
1. 字节 Dreamina 将全球发布 Seedance 2.5,面向专业 AI 影像
Hasan Toor 透露字节跳动官方 AI 创作平台 Dreamina 即将全球发布 Seedance 2.5,定位为专业级 AI 影像制作而非常规模型升级。新版本亮点包括:单次生成支持多达 50 个多模态参考素材(图像、视频、音频),面向需要精细控制的专业创作流程。这显示字节在生成式影像赛道正从“通用模型”转向“专业工作流”打法,与国际同类产品在可控性与多模态参考上正面竞争。具体能力与定价以官方发布为准,源帖信息为发布前爆料。
来源:@hasantoxr
2. RunAnywhere:浏览器即推理服务器,零出站字节跑模型
Shubham Malhotra 介绍的 RunAnywhere 把浏览器变成推理服务器:模型在客户端用 WebGPU + WASM SIMD 运行,权重存储在 OPFS(源私有文件系统)中,生成过程零出站字节,无需后端、无需 API key,兼容 Chrome、Safari、Firefox、Edge 并提供 SDK。这对隐私敏感(数据不出端)与离线推理场景意义重大,也代表着“端侧/浏览器内推理”从演示走向可用基建。性能上限受限于设备 GPU,大模型体验仍待验证,项目能力以官方文档为准。
3. 开源 Deer Workflow:在确定性流程与自主 Agent 之间架桥
作者正式开源 Deer Workflow,定位为 Dynamic Workflow 的开源克隆,试图填补传统 Workflow(流程确定、可控)与自主 Agent(灵活但不确定)之间的空白。核心理念是“让代码驱动流程、让 Agent 负责判断”:把可控的编排骨架交给代码,把需要决策的环节交给 Agent,兼顾稳定性与主动性。这类“工作流+Agent”混合范式是当下 Agent 工程的热点,Deer Workflow 提供了一个可自托管的实现,适合想搭建既可控又能自主决策流水线的团队作为研究起点。成熟度与生态仍需观察。
来源:deer-workflow — Let code drive the flow. Agents handle judgment.
4. Cloudflare 开源 Nimbus:为人与 Agent 而生的文档站
RicoUI 推荐 Cloudflare 官方出品的 Nimbus,一个基于 Astro 构建的文档站点方案,定位为“为人类与 Agent 而生(Docs for humans and agents)”。它与 Cloudflare 自家生态高度契合,视觉与体验在同类开源文档模板中表现突出,发帖者表示也会把个人知识库迁移到该模板。在“文档既要给人看、也要被 Agent 检索消费”的趋势下,这类面向 Agent 友好的文档基建开始出现。项目本身偏前端/文档工程,并非模型或 Agent 运行时,具体能力以仓库为准。

来源:GitHub
5. whisper.cpp:零依赖本地运行 OpenAI Whisper 语音识别
Hasan Toor 在工具盘点中推荐 whisper.cpp,它是 OpenAI Whisper 语音识别模型的 C/C++ 移植,可在自有机器上零依赖地运行语音转文字。对需要离线、私有、低延迟语音识别的开发者,whisper.cpp 是成熟且广泛使用的本地方案,支持多平台与多模型规格。此次属“再推荐”,源帖未披露新版本特性,价值在于为关注本地语音方案的读者指明可靠选择,生态与性能细节以仓库为准。
来源:GitHub
6. Rauchg:用 scriptc 把 Vercel CLI 编译成 1.28MB 原生二进制
Guillermo Rauch 演示了用 scriptc 把 Vercel CLI(TypeScript)编译为原生二进制:产物体积约 1.28MB,平均启动开销仅 1.5ms,平均编译耗时 2.94s,用到了 node:http、node:fs、node:path、node:os、node:crypto 等内置模块。这意味着把 Node/TS CLI 打包成轻量、快启动的单文件可执行成为现实,对命令行工具的发布与分发体验是直接提升。对 AI 工具链中大量 TS 编写的 CLI/Agent 入口,这也是一条值得关注的工程路径,数据为发帖者自测,跨项目表现以实测为准。
来源:@rauchg
Tutorial
1. 图解微调(Fine-tuning)工作原理
Amit Shekhar 撰文系统讲解微调(fine-tuning)的工作原理,面向想理解“为什么需要微调、以及它如何一步步改变模型”的读者。文章从“为什么需要微调”切入,用简单示例演示全量微调的逐步过程,并对照说明微调与相关训练范式的差异。对希望把通用大模型适配到特定领域或任务的工程师,这是一篇可上手的入门资料。内容偏教学,未涉及最新研究进展,适合作为概念建立的基础读物,源帖以导读为主,完整论述在博客原文。
来源:Outcome School | Get a High-Paying Tech Job
Opinions/Thoughts
1. 微软论文:用教师轨迹回放蒸馏 Agent,省去环境实时 rollout
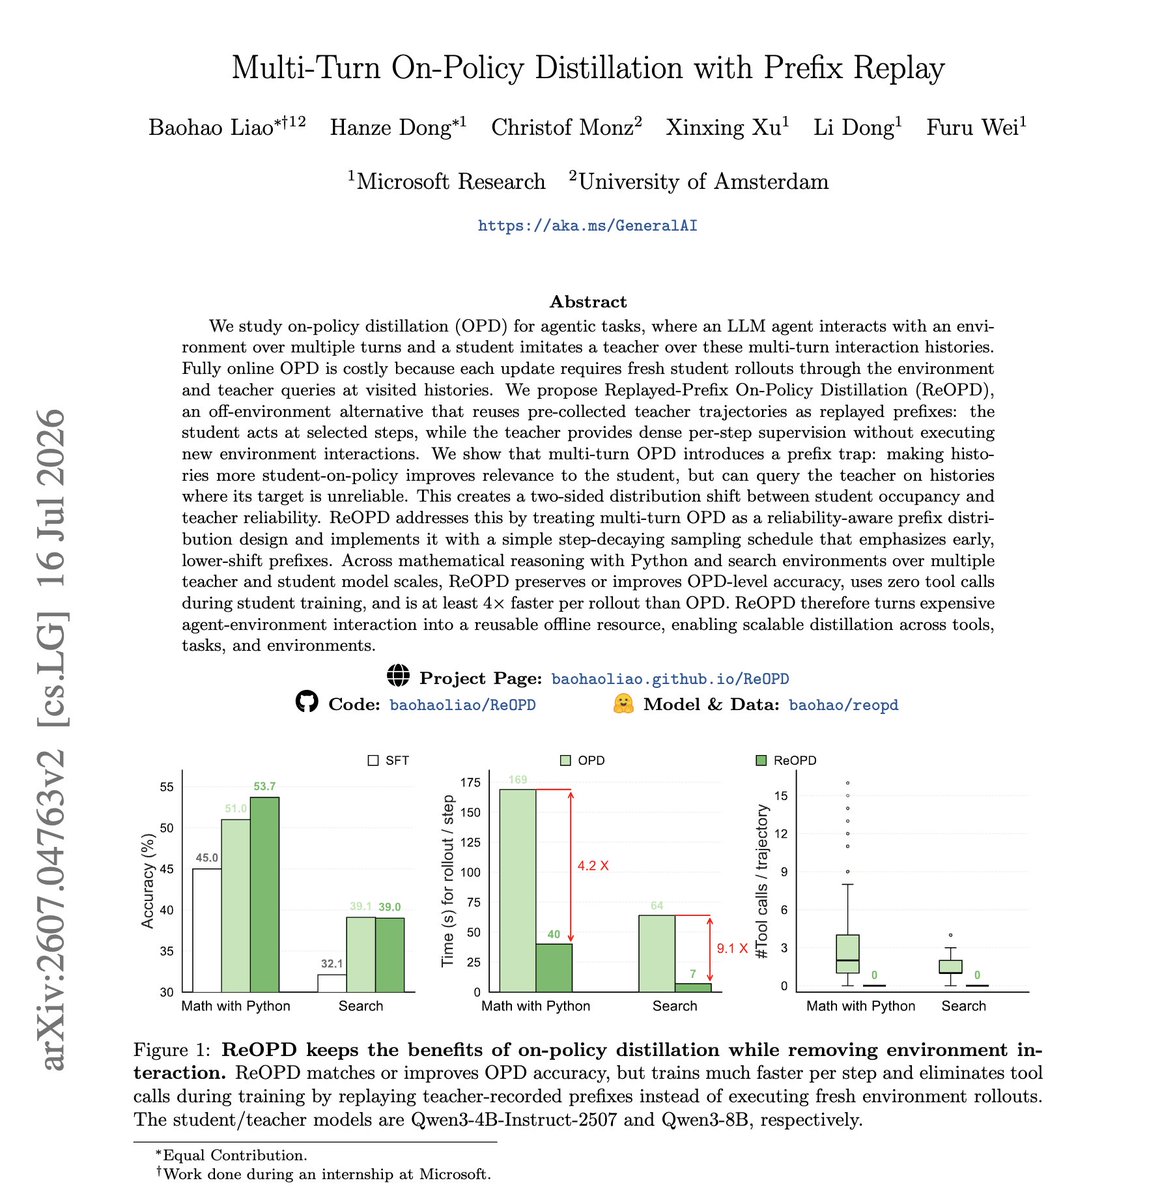
DAIR.AI 介绍了微软一篇新论文,核心思路是用回放的教师轨迹(replayed teacher trajectories)来训练 Agent,而非依赖真实环境中的在线 rollout。背景是:Agent 任务上的 on-policy 蒸馏非常昂贵,因为每一次参数更新都需要学生模型在环境中做全新 rollout,还要额外调用教师模型,成本随训练步数线性放大。改用回放轨迹可以大幅降低对环境交互与教师调用的依赖,从而让 Agent 蒸馏在工程上更可行。这一方向若成立,将显著降低 Agent 训练的算力与 API 成本,具体效果与基准需以论文为准。
来源:@dair_ai
2. Taelin 的极简 Agent 记忆方案:追加日志 + 即时压缩
VictorTaelin 表示市面上的记忆方案都不好用,于是自建了一套“即插即用”的 Agent 记忆方案。设计要点是:底层为 append-only 日志,写入时即时压缩(“nap, don’t sleep”),任何内容都不会真正删除;记忆上下文保持常量大小,细节随时间自然淡出。这套思路用极简结构兼顾了“不丢信息”与“上下文可控”,直指 Agent 长期记忆的核心矛盾——既要记得久,又不能让上下文无限膨胀。源帖为概念陈述加演示,尚未提供完整实现细节与基准,落地效果待验证。
3. DAIR.AI:本周值得读的 AI 论文精选
DAIR.AI 整理了“本周 Top AI 论文”合集(以 X article 形式发布),为读者提供一周研究热点的快速索引。这类周更合集的价值在于降低追踪前沿的边际成本——把分散在 arXiv 与各实验室的研究按主题与影响力做了筛选,适合作为研究者的“每周必读清单”与产业读者的趋势雷达。需要注意的是,合集为链接索引,每篇的深度结论仍需回到原论文,具体入选论文与排序以合集为准。
4. Sebastian Raschka:开源权重模型为何对 AI 生态至关重要
Sebastian Raschka 阐述了开源/开放权重模型对健康 AI 生态的重要性。他的核心论点是:只有开放权重,我们才能核实声明、检验结论,让闭源实验室之外的社区跟上进展;同时它赋予人们在自有硬件上运行 AI 的自由,不必把个人数据与 IP 交给第三方。这一定调与本周 Vercel、微软等围绕开放权重的密集表态形成呼应,共同强化了“开放权重”作为产业共识议题的地位。论述偏原则倡导,未涉及具体模型对比。

来源:@rasbt