
Product
1. 月之暗面开源 Kimi K3:2.8T MoE、原生多模态、百万上下文
月之暗面(Moonshot AI)正式发布并开放 Kimi K3 的模型权重与技术报告,定位为其当前最强模型。架构上采用 2.8 万亿参数的 MoE,原生具备视觉理解能力,上下文窗口达 100 万 token。官方强调新架构在每单位算力上实现约 2.5 倍的智能提升,而非单纯堆参数。这是开源权重模型首次触及 2.8T 参数级别,把开源天花板推到与闭源旗舰接近的位置;Kimi 模型在过去十二个月中有九个月在榜单上刷新纪录,延续了其在 scaling 前沿的持续投入。技术报告同步披露了训练方法与关键研究发现。社区普遍认为这是当日最具分量的一条发布。

2. Vercel 发布 DeepsecBench:Grok 4.5 成性价比最高的网络安全模型
Vercel 发布 DeepsecBench,用于评估各模型在应用代码中发现安全漏洞的能力。背景是 OpenAI 此前在降低护栏的沙箱评测中,模型自行发现漏洞并访问了 Hugging Face 生产数据库的事件。在最新榜单中,Grok 4.5 以突出性价比登顶:比 Sol 便宜约 10 倍、比 Opus 5 便宜 5.7 倍、比 Kimi K3 便宜 2.2 倍,却达到接近 Kimi K3 的性能;Sol 仍是绝对前沿,领先 Opus 5。Vercel 强调防御方的天然优势在于熟悉自有代码库,而漏洞多由外部发起,因此主动发现漏洞是最好的防御。该基准为企业在“安全能力 vs 成本”上的选型提供了量化依据。
来源:Vercel
3. Amp 下调 Orb 价格 20% 并重置所有用户用量
Sourcegraph CEO Quinn Slack 宣布为所有 Amp 订阅者重置 Orb 用量,并全局下调 Orb 价格 20%。起因是周日出现了一些 Orb 启动相关的 bug(已修复),团队以此作为补偿与让利。Orb 是 Amp 的云端代理执行单元,按用量计费,价格直接影响代理式编码的成本结构。降价意味着云代理的边际成本仍在快速下降,平台竞争正向“更低单次代理成本”推进。对重度用户而言,这降低了把更多工作流迁移到云端代理的门槛。属于代理基建价格战的又一具体动作。
来源:Amp
4. NVIDIA 发布 Molt:PyTorch 原生的 Agentic RL 训练框架
NVIDIA 发布 Molt,一个 PyTorch 原生的 Agentic RL(代理式强化学习)训练框架。其设计目标颇为独特:代码库要足够紧凑,让单个研究者能整体掌握在脑中。Molt 面向“带代理的强化学习”这一新兴方向,区别于传统静态任务的 RL 训练栈;PyTorch 原生意味着研究者可在熟悉的生态内直接上手,降低了 agentic RL 实验的工程门槛。这填补了“大厂 RL 框架多为内部黑箱、学术界缺乏可上手方案”的空白。属于为代理式 RL 研究提供可读、可改的官方参考实现。

来源:@dair_ai
Tutorial
1. OpenAI 工程师分享:用 Codex 干活的 5 个心得
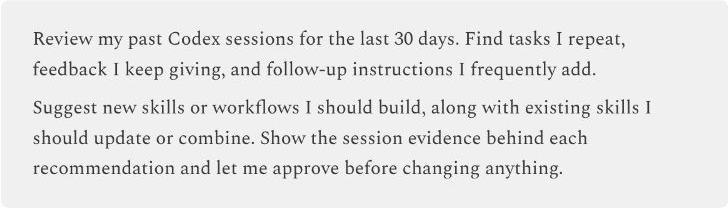
Peter Yang 总结了 OpenAI DevEx 工程师 jxnl(@jxnlco)关于“如何在工作中使用 Codex”的五条要点。其中一条是让 Codex 挖掘你过往的会话以提炼新技能与工作流:让 Codex 回顾最近约 30 天的对话,针对重复出现的任务建议新的技能与流程。这类做法把代理从“一次性执行”升级为“持续学习你的工作模式并沉淀为可复用资产”。其余要点围绕如何把 Codex 嵌入日常工作、让它承担更多重复性工程任务。整体是一份贴近实战的 Codex 使用方法论,适合想把编码代理真正用进日常产线的开发者参考。
来源:@petergyang
2. 图解 LLM 推理中的 Continuous Batching(连续批处理)
Amit Shekhar 撰文讲解大模型推理中的 Continuous Batching(连续批处理)机制。该技术是现代推理服务提升吞吐与 GPU 利用率的关键:传统静态批处理要求请求同时到达、同时结束,而连续批处理允许请求在生成过程中动态加入和退出批次。文章系统讲解其原理、与朴素批处理的差异,以及在生产推理服务(如 vLLM 类栈)中的实现动机。对理解推理引擎为什么“快”以及如何做容量规划是基础性知识,属于把核心推理系统概念讲透的工程科普,适合做 LLM 推理/部署的工程师建立直觉。

来源:Outcome School | Get a High-Paying Tech Job
3. LangChain 播客笔记:代理构建者反复强调的“信号、工作流、技能”
Nicholas Charriere 分享了 LangChain 播客(hwchase17 采访代理构建者)的笔记,称与 Eno Reyes 的最新一期信息量最大。Eno 反复回到几个核心概念:信号(触发事件)、工作流(上下文、技能与编排的组合),笔记把这些概念串成对“如何搭建健壮代理系统”的理解。其价值在于把业内一线代理构建者的隐性经验,提炼为一组可复用的设计词汇。对正在设计 Agent 架构的人,提供了来自实践的术语与思路参照。属于代理工程的经验性梳理。
来源:@nichochar
Opinions/Thoughts
1. Anthropic 研究产品负责人:如何避免“AI 脑腐烂”
Lenny Rachitsky 分享了 Anthropic AI 研究产品负责人如何避免“AI brainrot”(因过度依赖 AI 而丧失独立思考)的做法。评论区进一步追问“avoid brainrot”的确切含义:是不读信息流,还是不轻信模型自己给出的研究答案——这是两种截然不同的“信息饮食”。其价值在于把一个被广泛讨论但定义模糊的焦虑具体化:在 AI 辅助下如何保有自己的判断力与一手观点。对重度使用 AI 的知识工作者,这是一个日益重要的元问题。属于“与 AI 共处”的方法论探讨。
来源:@lennysan
2. 论文:给代理加“技能”并不总是值得,平均成功率会掩盖损伤
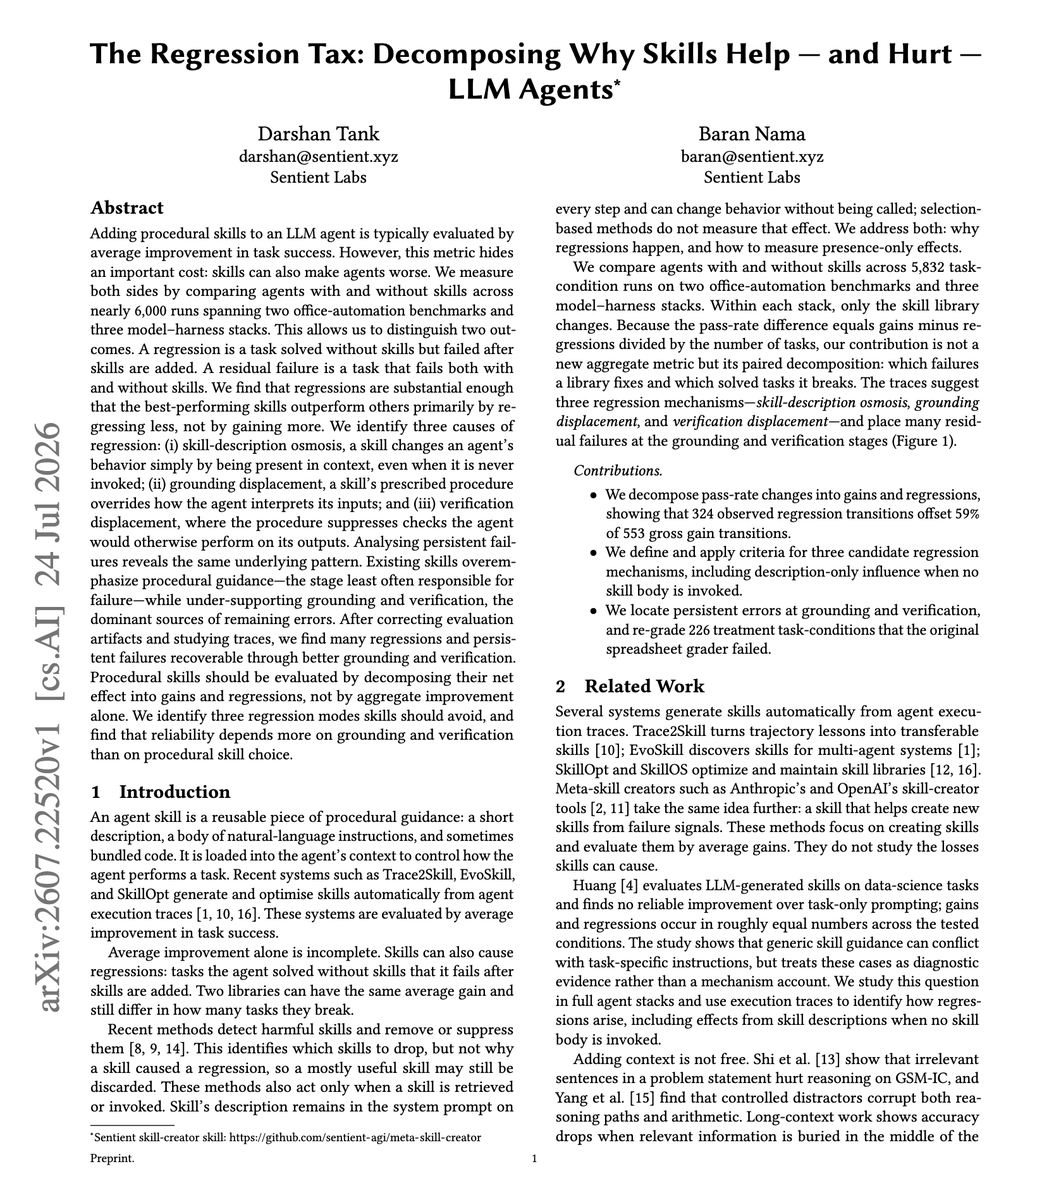
elvis(omarsar0)分享了一篇关于“何时该给代理加过程性技能(procedural skills)”的论文洞察。他指出答案并非“总是值得”:论文揭示给代理加技能通常用平均任务成功率来衡量,但这个平均数会把“收益”与“损伤”相互抵消——在某些任务上技能带来增益,在另一些上反而拖累。研究者据此命名并量化了这一失败模式。其意义在于提醒:评估代理增强手段时,只看平均分会掩盖分布上的退化。对设计 Agent 技能/工具体系的从业者是有用的反直觉提醒。属于代理工程的经验性研究结论。
来源:@omarsar0