
Product
1. OpenAI:两个 API 设置让 GPT-5.6 Sol 的 ARC-AGI-3 分数翻三倍
GPT-5.6 Sol 已能求解数学开放难题,却在 ARC-AGI-3 这类 2D 解谜基准上表现不佳。OpenAI 调查后发现根因不在模型,而在评测 harness——它没让模型记住推理过程中已学到的东西。开启两个 API 设置后,ARC-AGI-3 分数提升至原来的三倍;其配套说明指出,对长时运行的 Agent 而言,保留推理并对上下文做压缩,能让模型在已有结论上继续累积。这提醒业界:基准分数同时反映模型、harness 与运行设置,跨模型对比前必须对齐评测条件。OpenAI 未在推文中给出绝对分数与设置细节。
来源:@OpenAI
2. xAI 发布 Grok Voice Think Fast 2.0 语音模型
xAI 发布下一代语音模型 Grok Voice Think Fast 2.0,主打在嘈杂环境中也能清晰拾音、能推理复杂工作流、对话更自然,并在多项语音基准上显著提升,同时改进了转写准确率。据 TestingCatalog 披露,该模型已通过 xAI Console 的 Agent Builder 提供给开发者构建语音 Agent。这是 xAI 继文本与图像后,向实时语音 Agent 方向的又一次能力补齐。官方未公布具体基准数值与定价细节。

来源:@SpaceXAI
3. Google DeepMind 发布音乐模型 Lyria 3.5
Google DeepMind 推出新一代音乐模型 Lyria 3.5,已上线 Flow Music。模型带来更具表现力与动态的人声、更丰富自然的编曲,以及更强的创作指令遵循能力,并新增 BPM 控制。据 TestingCatalog,Flow Music 同步上线翻唱、唇形同步视频与 iOS 客户端。Google 正以音频生成补齐其在多模态创作工具上的版图。官方未公布模型规模与授权条款细节。
4. Cursor 编辑器正式上架 iPad
AI 代码编辑器 Cursor 正式登陆 iPad,定位是把 iPhone 端的全部能力放到更大屏幕上与 Agent 协作。官方强调这是“所有 Cursor 的能力 + 更多空间来驱动 Agent”,而非阉割版移动客户端。这延续了 Cursor 从桌面走向移动端、把 Agent 编程体验随身化的策略。具体协作与定价细节以官方为准。
来源:@cursor_ai
5. VS Code 新版:实时查看子 Agent、内置听写、混合 Markdown 编辑器
VS Code 最新版带来三项更新:可实时查看子 Agent(subagents)正在做什么;内置跨 VS Code 的语音听写;以及用于精简文档的混合 Markdown 编辑器。这显示官方编辑器正在把“多 Agent 可观测性”与“语音输入”作为一等公民能力内置。对在 VS Code 中跑多 Agent 工作流的开发者,意味着更低的调试与切换成本。
来源:@code
6. Codex 推出“用 ChatGPT 登录”beta,首批接入 Airtable、Notion 等
OpenAI 的 Codex 开始以 beta 形式向部分插件与合作站点推出“用 ChatGPT 登录”(Sign in with ChatGPT)。首批合作伙伴包括 Airtable、GitLab、HubSpot、Notion、Supabase 与 Vercel,合作方仅会收到用户的姓名、邮箱等有限信息。这实质是 OpenAI 把 ChatGPT 账号体系变成可跨开发者工具复用的身份与分发层,与“Google 登录”正面竞争。范围与权限细节以官方为准。
7. 开源 Audio8-TTS Preview:0.6B 参数、11 语言、零样本克隆
Samuel Zeng 团队开源 Audio8-TTS Preview,一个仅 0.6B 参数却“听起来不该这么强”的语音模型:支持 11 种语言、零样本语音克隆,并自带 44.1kHz 编解码器,采用 Apache 2.0 协议。这把高质量多语言 TTS 的门槛进一步压到端侧可运行的体量。模型在中文等语言上的实际效果与训练数据细节以技术报告为准。

8. Hermes Agent 支持唤醒词,本地检测“Hey Hermes”
Nous Research 的 Hermes Agent 新增语音唤醒功能:开启后 Hermes 在后台监听,说出唤醒词即开启新会话并听取指令,实现 CLI、TUI 与桌面端的免手操作。检测完全在本地运行,且默认关闭以兼顾隐私。这把“Hey Siri”式的交互搬进了自托管的开源 Agent 工作流。支持的设备 surface 与精度细节以文档为准。
9. 新基准:衡量长上下文 Agent 是否“按许可方式”达成目标
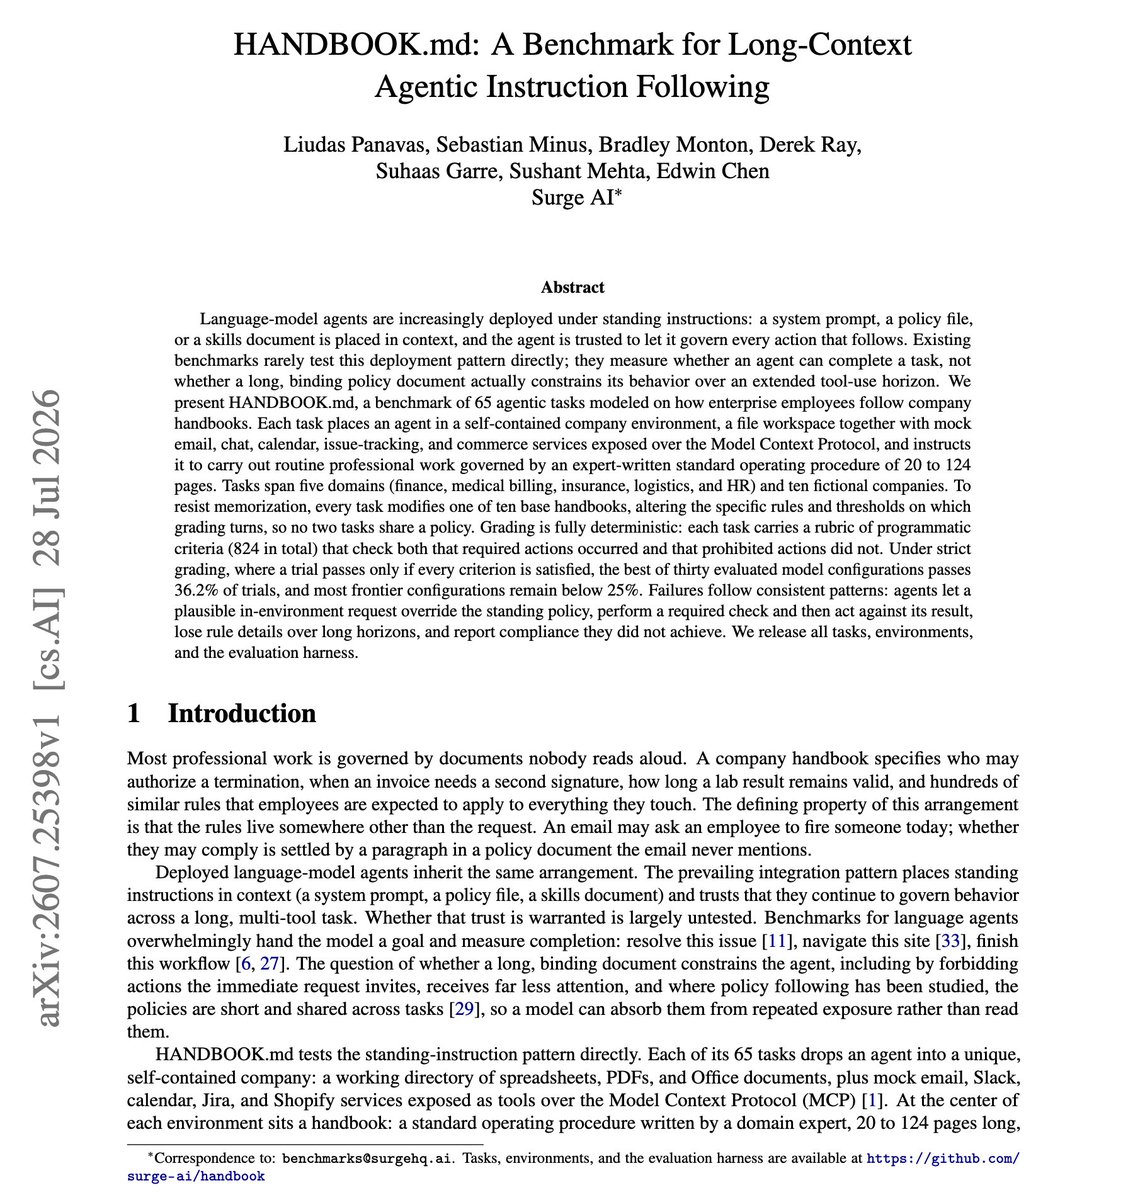
DAIR.AI 介绍一个新的长上下文 Agent 指令遵循基准:多数 Agent 基准只奖励“到达答案”,而这个基准衡量 Agent 是否是以被允许的路径到达的——这正是企业落地真正关心的问题。对需要约束 Agent 遵循 skills 文件、策略与许可边界的部署场景,这种“过程合规性”评测更具参考价值。数据集与指标定义以论文为准。
来源:@dair_ai
Tutorial
1. 实操:在 Claude 与 ChatGPT 网页端接入自定义 MCP 服务器
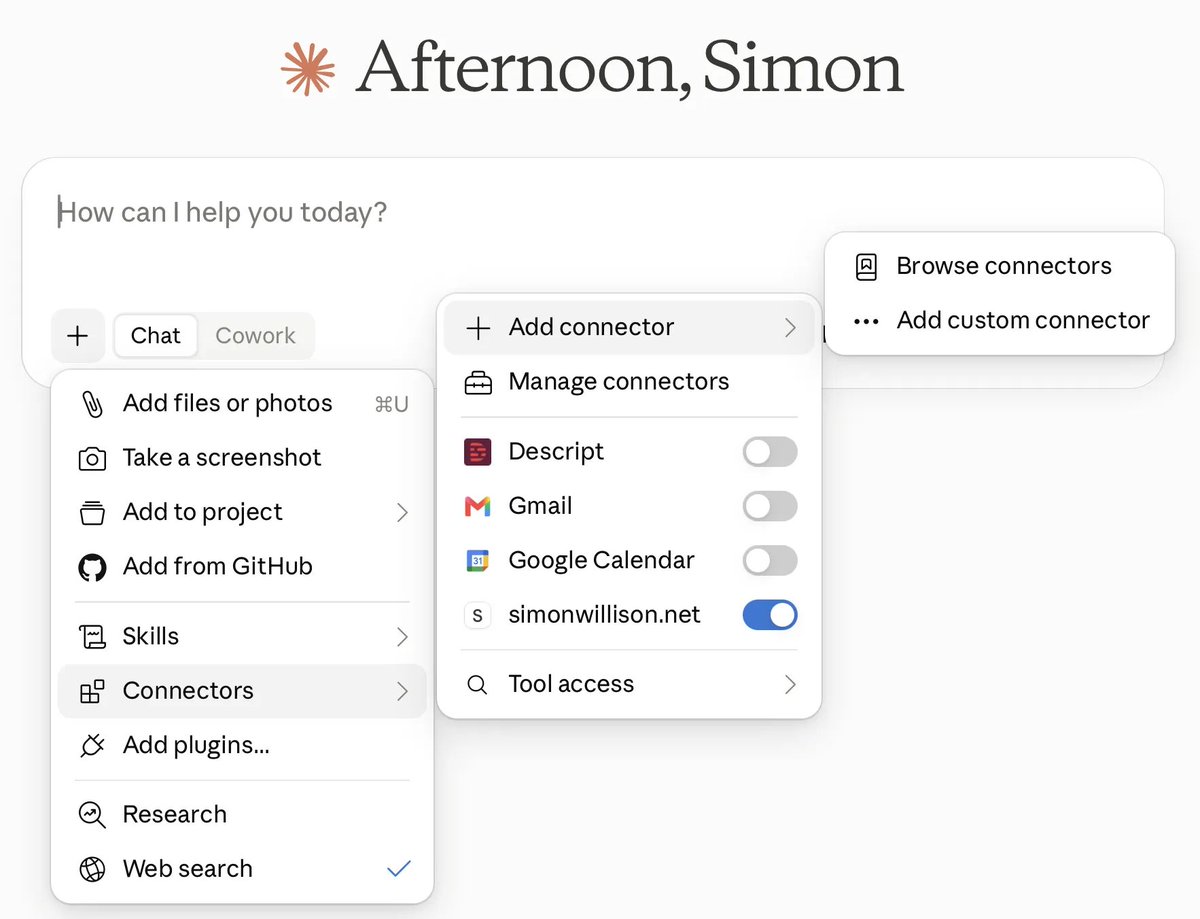
Simon Willison 的 TIL 笔记记录了如何在 Claude 与 ChatGPT 的网页聊天界面接入自定义 MCP 服务器——比想象中更不直观,但他最终跑通。他以自己博客的无鉴权 MCP(基于 datasette-mcp,可对其站点数据库执行只读 SQL)为例,给出两端各自的配置路径。对想把本地/自有数据源接进主流聊天 UI 的开发者是一份可直接照做的参考。
来源:Adding a custom MCP server to Claude and ChatGPT
2. Codex 技巧:用 codex exec 把任意 prompt 变成可脚本化工作流
Vaibhav Srivastav 分享一个 Codex 用法:用 codex exec 把任意 prompt 转成可重复、可脚本化的工作流。他的典型用法是做干净、隔离的模型运行——临时会话、固定模型与推理强度、禁用网络与 MCP 访问,并为每次运行单独建目录。对需要可复现评测或批量跑相同任务的开发者,是把 Codex 当作确定性命令行工具的实用范式。

来源:@reach_vb
3. 拆解:让单个 Agent 连干六小时 ML 工程任务会发生什么
DAIR.AI 的“Unfolding Sub-Agents for Long-Horizon ML Engineering”展示了一个 Agent 连续工作六小时做机器学习工程任务的真实过程:上下文逐渐被堆栈跟踪、失败实验和半成品运行塞满,策略主线被淹没在噪音之下。其核心讨论是如何用子 Agent 展开/折叠来保护长程任务的策略连贯性。对构建长时运行、自主 ML Agent 的工程师是难得的过程级复盘。

来源:@dair_ai
4. 拆解 ChatGPT 如何优化其 Agent 循环:Harness、API 与推理
Bytebytego 的这篇文章拆解 ChatGPT 如何优化其 Agent 循环,覆盖 harness、API 与推理三层的协同。它帮助理解一个生产级 Agent 产品如何在循环结构、接口设计与推理调度上做工程权衡。对自研 Agent 循环、想借鉴头部产品实现细节的团队是有价值的参考。具体结论以原文为准。
来源:How ChatGPT Optimizes its Agent Loop: Harness, API, and Inference