
Product
1. 红皇后 Gödel 机器:让智能体与评估者协同进化
剑桥团队发表 Red Queen Gödel Machine 论文,提出递归自改进智能体不应使用固定评估标准。传统自改进循环中,智能体学会迎合固定评判者而非真正进步,导致奖励破解。该框架将评估者纳入进化循环,每个 epoch 内评估标准固定、epoch 间评估者与智能体共同演化,使标准随能力提升而提高。实验表明,这种共进化方法在多个 agentic 编程基准上持续优于固定评判者的基线系统。论文提供了一种结构性答案,解决了自改进系统中「评判者不再严格则改进停滞」的核心问题。目前该方案仅在受限环境下验证,扩展到通用领域仍待进一步研究。

来源:arXiv.org
2. 推理质量在前一百 token 即已决定,数据筛选可提前中止
UCLA 团队发表论文,发现推理轨迹的质量在很大程度上由开头几个 token 决定,无需完整阅读整条轨迹即可判断其优劣。基于这一点,他们提出只需评估前 100 个推理 token 的损失(在预训练模型随机扰动检查点上计算),就能可靠地识别困难问题;前 1000 token 的损失模式还能预测完整轨迹的梯度行为。该方法将百万级推理轨迹的筛选转化为廉价的早停问题,大幅降低为推理模型构建 SFT 数据的成本。在 Qwen2.5-7B 和 Llama3.1-8B 上的实验验证了该方法有效。这一发现为低成本构建高质量推理 SFT 数据集提供了实用路径。

来源:arXiv.org
3. FreeLLMAPI 聚合 16 家免费 LLM 提供商,每月约 17 亿 Token
FreeLLMAPI 是一个开源代理,将 Google、Groq、Cerebras、NVIDIA、Mistral、OpenRouter、GitHub Models、Cohere、Cloudflare、HuggingFace、Z.ai、Ollama 等 16 家免费 LLM 提供商的免费层聚合到一个 OpenAI 兼容端点下。所有提供商免费层叠加后每月约 17 亿 token。核心功能包括自动故障转移(当前提供商标记用完或速率受限时自动切换到下一个)、按密钥跟踪使用量以确保不超过免费上限、加密存储密钥、完整支持聊天、嵌入、图像、音频、工具调用和流式传输。项目定位为个人实验用途,使用一个统一的 /v1 端点和单一 API 密钥即可访问所有模型。
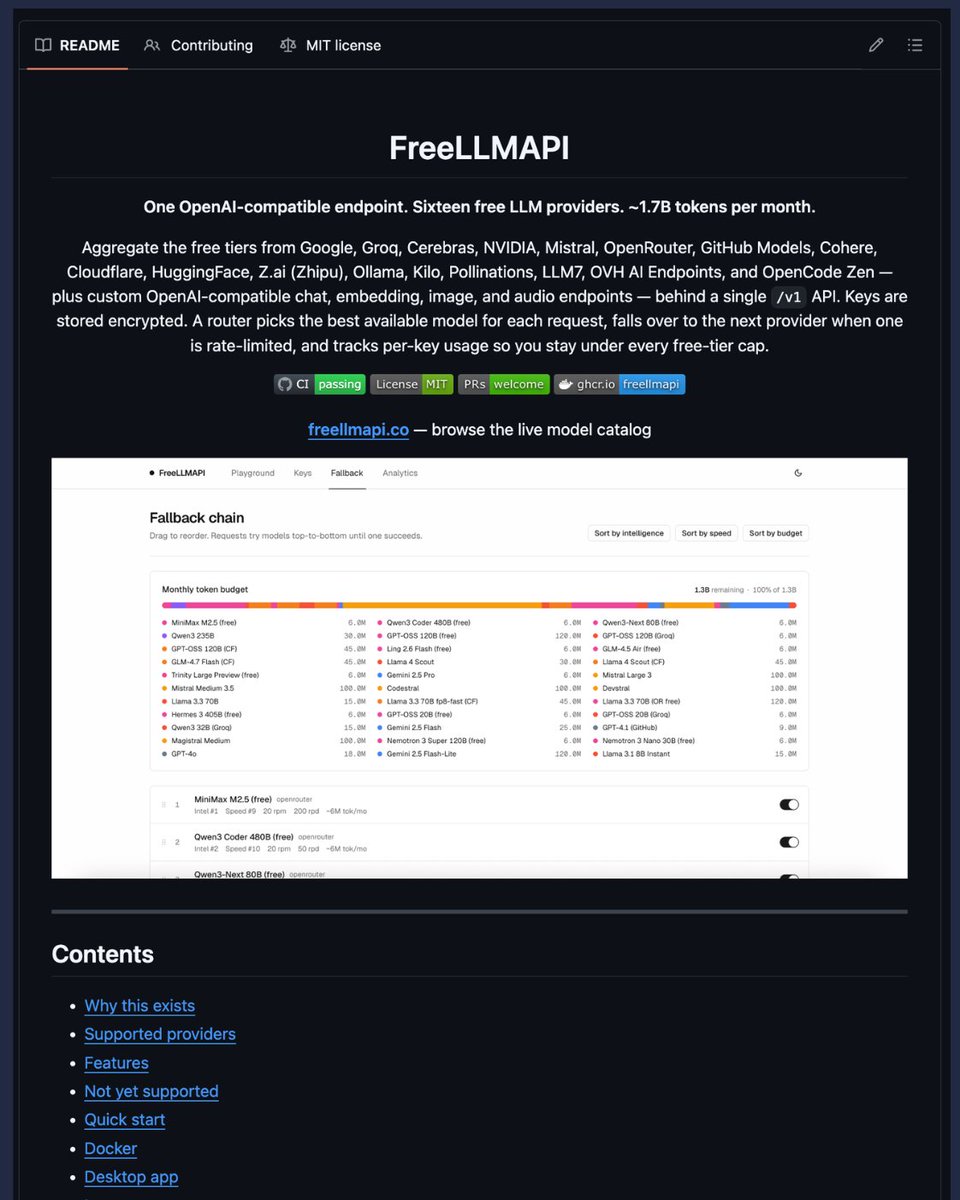
来源:GitHub
4. Tau:一个像教科书一样可读的编码 Agent 教育项目
Tau 是一个小型 Python 编码代理项目,旨在用于教学。它按层次分离,第一层 tau_ai 将模型响应转化为提供者中立的事件流,第二层 tau_agent 实现可复用的 agent 循环(消息、工具调用、记录管理、会话),第三层 tau_coding 提供文件、shell、持久会话、skills、斜杠命令和 Textual TUI 组成的编码环境。核心思想是每层都完全可见,回答教程常常跳过的问题:agent 循环是什么、工具调用从何而来、记录如何增长、会话如何跨进程存活。使用 uv tool install tau-ai 即可安装。
来源:Tau
5. talktui:在终端中演示 Markdown 幻灯片
talktui 是一个基于 OpenTUI 的终端演示工具,读取一个 Markdown 文件即可在终端中显示全屏幻灯片。支持多种布局、主题、渐入效果、代码高亮、表格、标注框、Mermaid 图表和本地终端图片。快捷键包括 n/p 前进后退、f/l 首末页、? 帮助等。可通过 bun install 安装并运行 bun run deck 命令,主题包括 tokyonight、ember、catppuccin 等。

来源:GitHub
Tutorial
1. Google TPU 工作原理详解:从张量到脉动阵列
一篇技术博客详细解释了 Google TPU 的工作方式,覆盖了 TPU 的定义、Google 为何构建它、CPU/GPU 与 TPU 的区别、脉动阵列的核心思想、数据在 TPU 中的流动路径、TPU 为何如此高效节能、TPU 的使用场景和局限性。文章从基础的张量概念讲起,逐步深入到矩阵乘法引擎和脉动阵列架构,帮助读者理解 TPU 如何通过专门化的硬件设计在机器学习推理中获得极高吞吐量。
来源:Outcome School | Get a High-Paying Tech Job
Opinions/Thoughts
1. 本周十大 AI 论文:Sakana Fugu、Agent-Native Memory、Autodata 等
DAIR.AI 发布本周(6月21-28日)十大 AI 论文精选。Sakana Fugu 训练编排器模型动态构建 agentic 脚手架,在 SWE-Bench Pro 等六个基准上达到 SOTA。Agent-Native Memory 从数据管理视角研究了记忆系统的分解与权衡。Autodata 将 AI agent 作为数据科学家并通过元优化持续生成更优数据。Critique of the Agent Model 提出了 agent 的五个维度并区分了 agentic 与 agentive 系统。Agent-as-a-Router 将路由形式化为带有记忆的闭环。Agent Communication Protocols 构建了五维分类法。A Pinch of Human Data 只需 30 分钟人类数据即可正则化自博弈策略。Skill-MAS 将多智能体编排能力作为可进化的元技能。Reliability without Validity 揭示了 LLM-as-a-Judge 在原始一致性与机会校正 Kappa 之间存在 33-41 个百分点的差距。NatureBench 显示最强 agent 在科学发现任务上仅击败 SOTA 17.8%。
2. OpenAI Codex 负责人谈产品工作新形态:品味比技术更重要
在 Lenny 播客中,OpenAI Codex 桌面应用负责人 Andrew Ambrosino 分享了 AI 如何颠覆产品开发流程。他认为品味正成为 AI 优先工作场所中最有价值的技能;Codex 应用如果在 11 月推出会失败,但 2 月推出时(模型能力提升后)获得了成功。OpenAI 的产品经理采用「区域防守」模式而非传统拥有制。他呼吁不要完全取消角色概念,并描绘了 Codex 统一工作台愿景——连接 ChatGPT、Codex 和现有工具的协调中心。目前近 100% 的 OpenAI 员工每周使用 Codex。
3. 未来产品角色的五种原型:当工程、产品、设计融为一体
Boris Cherny 观察 Claude Code 团队后提出了未来角色可能演变为五种原型:原型师(创新)、构建者(快速产品化)、清理者(简化优化)、增长者(迭代 PMF)和维护者(稳定高效)。健康团队需要根据产品阶段混合不同类型。这些角色不绑定特定职能,设计师也可能属于原型师或构建者。
来源:@bcherny