
Product
1. Claude Code 新版本引入 ‘eval’ 命令:支持自动化基准评估
Claude Code 2.1.198 版本引入了全新的 ‘eval’ 命令,这是一项重大 CLI 更新。该命令附带多项相关选项,包括 —ablation, —case, —judge-model, —keep-temp, —no-scaffold 等,允许用户运行自动化的基准评估。此外,还出现了新的模型 ‘claude-eval-’。这表明 Anthropic 正在为开发者提供更强大的内建测试和评估框架,有助于在开发流程中更系统地衡量代理性能。详细的 CLI 表面变更记录在专门的元数据文件中。
来源:GitHub
2. Anthropic 宣布 Claude Fable 5 全球重新上线:附带加强安全分类器和行业框架
Anthropic 官方宣布,Claude Fable 5 在因美国政府出口管制而暂停 19 天后,已于 7 月 1 日面向全球用户恢复。重新部署的模型配备了新的安全分类器,专门用于识别和阻止更多的网络安全任务,短期内可能导致一些常规编码和调试任务回退到 Opus 4.8。Anthropic 还宣布,已开始与亚马逊、微软、谷歌等 Glasswing 合作伙伴共同起草一个评估 AI 越狱严重程度的共识框架。同时,正在扩大与美国政府在模型测试和安全保障方面的合作,包括预发布访问和联合研究。Fable 5 在促销期内(至7月7日)可消耗用户每周50%的订阅额度。
3. Sakana AI 的 Fugu 模型现已在 OpenCode 上可用
Sakana AI 宣布,其多代理编排模型 Fugu 现已集成到开源编码代理工具 OpenCode 中。Sakana AI 团队透露,在开发 Fugu 的多智能体编排能力时,他们本身就是用 OpenCode 来验证其模型的。他们与 OpenCode 团队共享一个核心理念:编码代理的未来应该是一个开放的、集体的生态系统。这一合作强化了开源编码代理生态系统的趋势。
4. Google 发布 Gemini Spark 重大更新:Mac 应用、MCP 支持与 App 生态扩展
Google 宣布对 Gemini Spark 进行大规模更新。除了登陆 macOS,主要更新还包括:支持自定义 Model Context Protocol 以构建更个性化的助手;与 Canva、Dropbox、Instacart、OpenTable 和 Zillow 等应用深度集成;连接 Google Tasks 和 Keep,将头脑风暴转化为待办事项;以及实时追踪体育、股票、新闻等动态话题。这些更新将 Gemini Spark 从一个单纯的对话助手转变为更具主动性和集成能力的 AI 代理,旨在全天候协助用户的数字生活。该功能同样仅限美国地区 Google AI Ultra 订阅者使用。
来源:Google
5. aidex CLI:快速查询 AI 模型信息的终端工具
开源项目 aidex 提供了一个命令行界面工具,帮助开发者快速获取不同 AI 语言模型的详细信息。该工具现已使用 models.dev 数据库作为数据源。开发者可以通过简单的命令列出不同提供商(如 OpenAI、Anthropic、Google)的模型,根据输入输出模态过滤,比较推理型聊天模型,或者按输入成本排序。这个工具解决了持续追踪最新模型价格和能力的痛点,被设计为随时更新的 npm 包。
来源:GitHub
6. summarize.sh:一个 CLI 工具还能变身内容定制化助理
开发者 Peter Steinberger 展示了其开发的一个名为 Summarize 的多功能 CLI 工具(以及 Chrome 侧面板)。它可以干净地提取和总结网页、文件、YouTube 视频甚至播客的内容。其特色在于使用了一个按优先级排序的提取管道:对文章使用 Readability,对文件使用 markitdown,对媒体使用 Whisper,并使用 Firecrawl 作为备用。支持本地、付费和免费等多种模型。作者展示了一个高级用例:指示 Codex 下载并转录整个 AI 工程师大会的所有会议内容,然后再根据他自己的兴趣进行个性化定制总结。这表明该工具可以成为强大的信息管道。
来源:summarize
7. OpenCode 2.0 即将公开测试:主打自建技能热重载以优化缓存
OpenCode 2.0 的开发者 dax 透露,该版本之所以耗时良久,是因为他们重新设计了整个系统以支持热重载。这意味着用户可以请求代理为自己创建一个技能(或者手动创建),该技能会立即被系统识别并生效,且不会破坏缓存。这一设计对于开发者代理的迭代和使用体验至关重要。dax 表示,目标是在本周末发布公开测试版。

来源:@thdxr
Tutorial
1. 我错了:Claude Cowork 的最佳实践是 ‘Skills + Projects’
作者在发布超过 2000 万阅读量的 Claude Cowork 指南后,公开发文纠正了自己之前的建议。他承认之前推荐使用文件和文件夹的设置是错误的,会导致信息泄露和难以维护。他现在强烈推荐仅使用 Skills(通过 /commands 实现的可复用能力)和 Projects(上下文工作区)。他建议关闭大部分设置,对复杂任务使用 Opus 或 Fable,简单任务使用 Sonnet/Haiku。同时推荐了使用 AskUserQuestion 让 Claude 主动收集上下文、结合 Wispr Flow 语音输入优化提示效率、每 20 条消息左右开启新会话以节省令牌等具体技巧。他还强调了在团队间共享 Skills 和 Projects 以实现协作的重要性。
来源:How to AI
2. Theo 分享 Fable 5 省令牌秘籍:不用 xhigh、教会 Fable 用 Codex 打下手
开发者 Theo 分享了他如何在大量使用 Claude Fable 5 的情况下不触发速率限制的实用经验。他的四个技巧包括:只在 ‘高’ 努力程度下使用 Fable,认为更高的设定反而可能输出更差;在 Claude Code 的配置文件中教会 Fable 如何作为编排者,将大量具体实现任务委托给 OpenAI 的 GPT-5.5(Codex);在 CLAUDE.md 中编写了详细的模型优先级分配策略;对于令牌消耗大的任务(如计算机使用、代码库分析),则使用其他模型执行并将结果报告给 Fable。这种方法实现了模型间的优化组合。
来源:@theo
Opinions/Thoughts
1. Google 新研究 RLMF:让 LLM 通过元认知反馈学会诚实表达不确定性
Google 发表新论文提出 RLMF(带元认知反馈的强化学习),旨在解决 LLM 高置信度幻觉和无法识别知识边界的系统性问题。该方法分为两阶段:首先校准自报置信度的准确性,然后通过定向输出编辑将置信度映射为自然语言的不确定性表达。RLMF 在多种任务上达到了最先进的忠实校准水平,同时在保持准确性的前提下,相比标准 RL 提升了最高 63%。研究指出,当前多数修复方案是外挂式校准,而 RLMF 将模型的元认知能力直接转化为训练信号,在偏好优化中根据自我判断质量优化排序,并利用相同的自我判断来选择高价值训练数据。该研究为构建更可信赖的 LLM 提供了全新范式。
来源:arXiv.org
2. Kent Beck 谈软件工程未来:编码只是小部分,信任与人类沟通无法自动化
The Pragmatic Engineer 发表了对软件工程传奇人物 Kent Beck 的深度访谈。Beck 认为,在AI时代,编码只是软件工程中很小的一部分,大量的人类工作——建立信任、沟通理解、领域知识——是无法被自动化的。他分享了自己从 Apple 被解雇、与 Ward Cunningham 合作发现 TDD、参与撰写敏捷宣言、以及在 Facebook 的冲击性体验。他提出了 ‘探索、扩展、提取’ 的 3X 模型,并认为焦虑是他发明 TDD 的动力。他强调,软件工程中最重要的始终是人与人之间的沟通和理解,而AI将使这一部分变得更加关键。
3. Anthropic 平台工程主管揭秘:如何构建 AI 原生工程团队
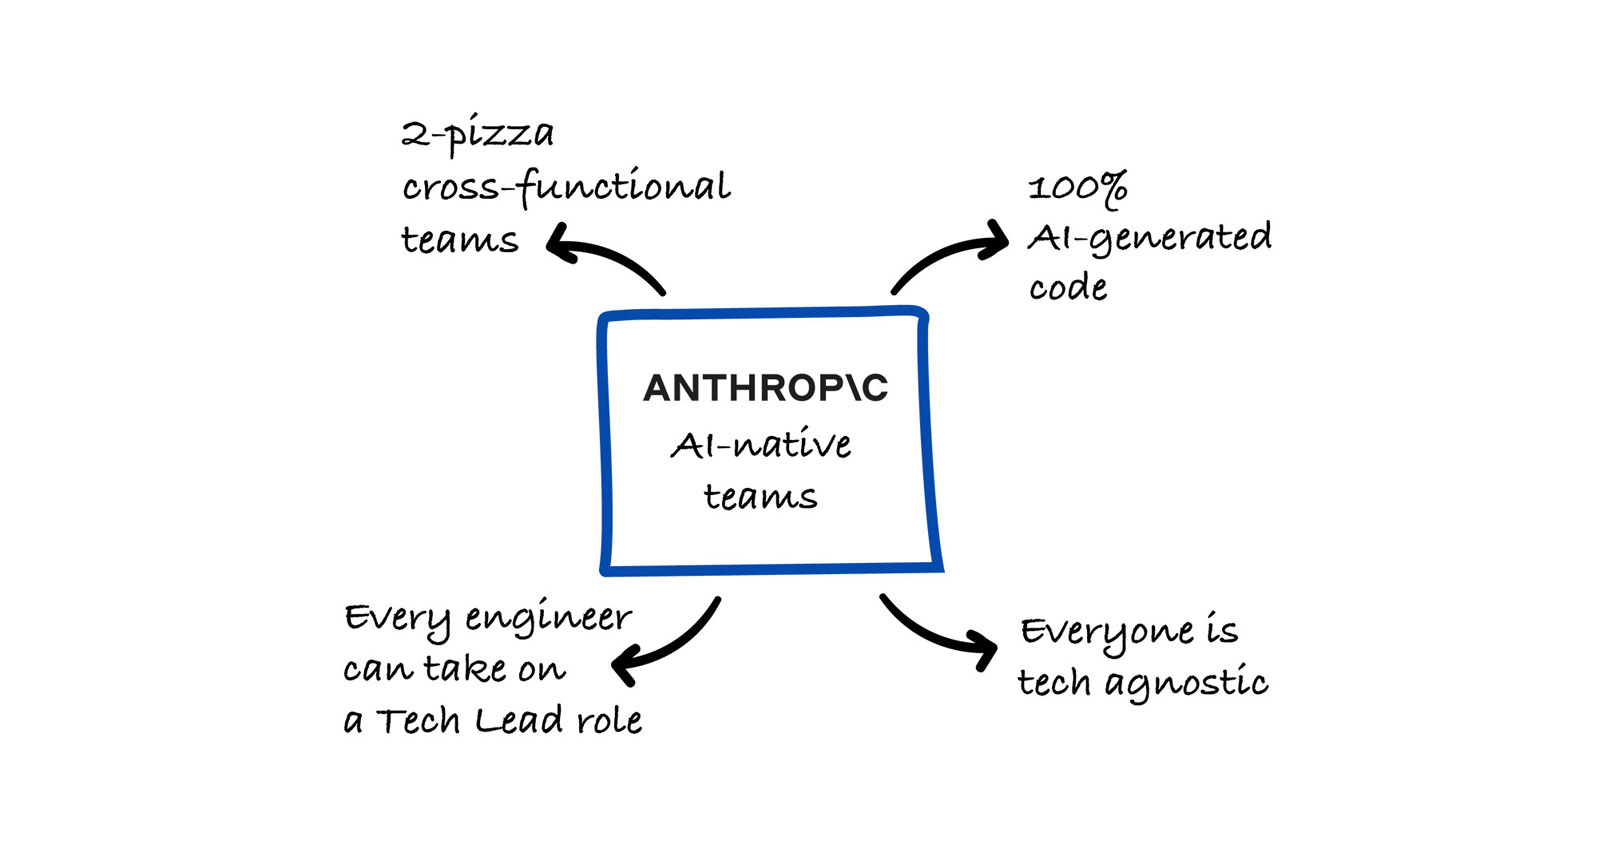
文章分享了对 Anthropic 平台工程负责人 Katelyn Lesse 的采访,揭示了这家 AI 公司如何构建 AI 原生工程团队。关键要点包括:‘AI 原生’意味着将 AI 无缝嵌入工作流;团队结构虽然保持传统的跨职能形态,但并行度和工程师自主性大幅提升;所有代码均由 AI 生成,但工程师仍需负责设计、架构和引导 AI 代理达到期望结果;产品经理变得更重要,因为瓶颈从实现转向了决策;没有专门的 QA 工程师,而是依赖自动化测试和 AI 评估。审阅 AI 生成代码现在成为一项核心工程技能。公司强调工程师的责任和问责制始终不能被 AI 替代。
4. FARS 系统:大规模全自动科研产出 166 篇论文并公开失败案例
新发表的论文介绍了 FARS,一个完全自动化的 AI-for-AI 科研系统,旨在大规模运作多种科研主题。FARS 通过阶段特定代理(负责构思、规划、实验、写作)在共享工作空间协作,记录提案、代码、日志、结果和手稿。其首次公开部署产生了 166 篇跨越 67 个细粒度 AI/ML 主题的完整论文。与以往仅展示精选案例不同,FARS 保留了完整语料库(包括失败案例),并由 282 份志愿者评审对 140 篇论文进行了评估。结果显示出 FARS 能够产出可审阅的成果,但同样暴露了在研究范围、方法论和完整性方面存在的重复失败模式。该研究展示了全自主科研系统在规模化应用中的真实能力与局限。
来源:arXiv.org