
Product
1. Anthropic 推出 Claude Science,为科学家打造专属 AI 工作台
Anthropic 正式推出 Claude Science,一个集成科研全流程的 AI 工作台,并非新模型而是基于现有 Claude 模型的专用环境。它连接 60 多个科学数据库,配备基因组学、蛋白质结构、化学等预建工具包,支持创建子助理分工协作。所有产出(代码、运行环境、对话历史)均可完整追溯复现。已出现具体应用案例:ManifoldBio 用于靶向药物筛选、艾伦研究所搭建多 Agent 综述流水线将两年工作量压缩至数周、UCSF 团队将胶质瘤分析时间缩短 90%。Anthropic 通过垂直工作台策略巩固行业操作系统角色。
来源:TechCrunch
2. Anthropic 发布 Claude Sonnet 5,代理能力接近 Opus 定价更低
Anthropic 发布 Claude Sonnet 5,定位为性价比更高的代理模型。Anthropic 宣称其性能接近 Opus 4.8,但定价仅为 $3/$15/M tokens(首发折扣至 $2/$10,持续到 8 月 31 日)。模型新增 xhigh effort 等级,支持 100 万 token 上下文窗口,最大输出 128K tokens。Sonnet 5 采用新 tokenizer,相同输入 token 数增加约 30%,实际使用成本可能高于预期。在 SWE-bench Pro 等基准上表现接近 Opus 4.8,但在某些知识密集型任务上仍有差距。Sonnet 5 也是首个在 Anthropic 宪法框架下批评自身约束规则的模型。
来源:TechCrunch
3. 美团发布 LongCat-2.0,1.6T 参数 1M 上下文的大模型
美团发布 LongCat-2.0,参数规模达 1.6T,支持百万 token 上下文窗口。该模型的完整训练和大规模部署全部基于 AI ASIC 超级计算集群完成,体现了国产自研芯片生态的进展。目前已通过 Owl Alpha 名称在 OpenRouter 上提供测试。LongCat-2.0 表明中国大模型在参数规模和上下文能力上正快速追赶前沿,且硬件自主化取得突破。

4. Ollama 借助 MLX 使 Gemma 4 在 Apple Silicon 上提速近 90%
Ollama 宣布使用 MLX 后端后,Gemma 4 在 Apple Silicon 上的推理速度提升近 90%。加速来自改进的多 token 预测(MTP)技术,现已在 Gemma 4 上默认启用并将逐步推广。Ollama 在运行时自动调整推测解码的 token 数量,确保在猜测不再提速时不会拖慢生成。这一进展使本地 AI 的实用性大幅提升。

来源:@ollama
5. Anthropic 官方确认 Fable 5 和 Mythos 5 出口管制解除
Anthropic 官方宣布收到商务部通知,Claude Fable 5 和 Mythos 5 的出口管制已被解除,将于次日恢复访问。Anthropic 感谢用户的耐心与合作方的工作。这是 AI 领域首次公开对前沿模型实施出口管制后又解禁的事件,预示着美国政府将采取持续的“许可-监督”管理模式。未来此类监管可能成为常态。
来源:@AnthropicAI
6. Cursor for iOS
Cursor 推出 iOS 应用,可在手机上启动始终在线的云端代理,并远程控制电脑上的代理。同时 Composer 2.5 在 7 月 5 日前提供 75% 折扣。
7. Google 发布 Nano Banana 2 Lite 和 Gemini Omni Flash 两个新视觉模型
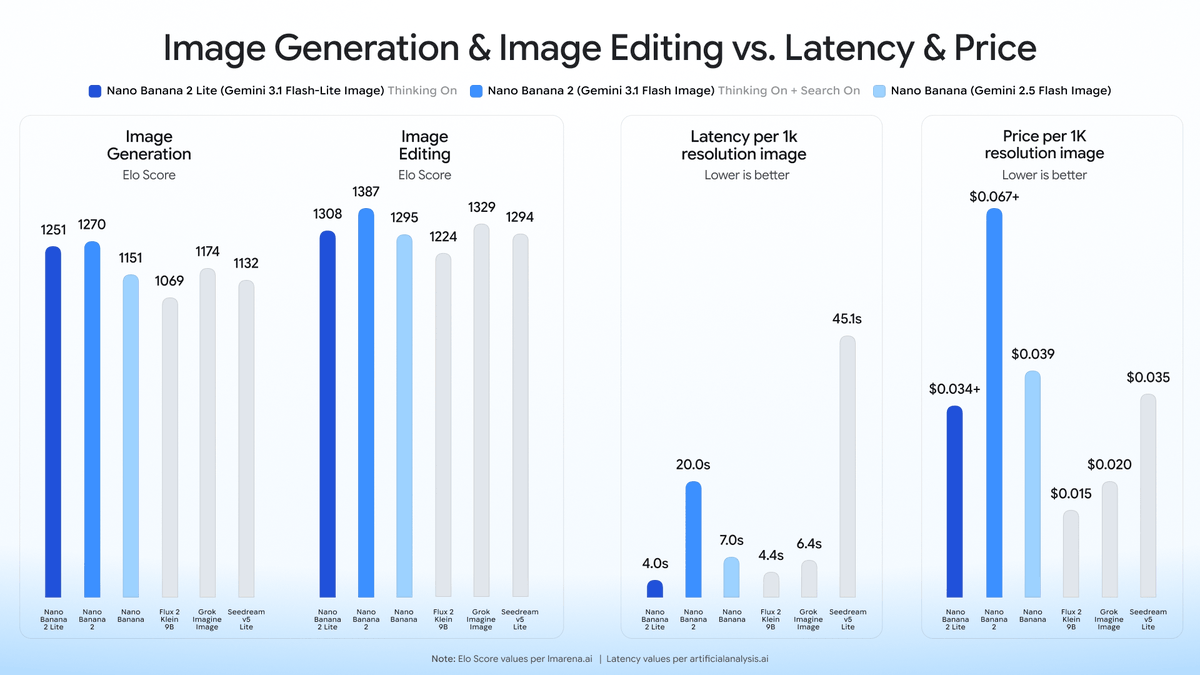
Google 同日发布两个视觉模型:Nano Banana 2 Lite 用于图像生成,4 秒单张,每千张仅 $0.034,适合高吞吐量任务;Gemini Omni Flash 在文本到视频榜单排名第一、图像到视频和编辑排名第二,定价 $0.10/秒。OpenAI 的 gpt-image-2 在图像领域仍居榜首。Google 以低价和速度切入视觉生成市场,推动多模态推理成本下降。


Tutorial
1. Hermes Agent 更新 Web 提取:速度提升六十倍,成本降低四十九倍
Nous Research 的 Hermes Agent 发布重大更新 web_extract,重新设计了 Web 内容提取管道。新方案将干净内容直接传递给 Agent 而非经过冗余处理。根据内容大小分级处理:<5000 字符直接返回 HTML,5000-50 万字符单遍摘要,50 万-200 万字符并行分块摘要,超过 200 万建议使用 web_crawl。支持将提取摘要路由到廉价模型(如 Gemini Flash)以节省成本。提供 8 个后端提供商(Firecrawl、SearXNG、Brave、DDGS、Tavily、Exa、Parallel、xAI),支持搜索与提取分离配置。SearXNG 可自托管实现零成本搜索。
来源:15 LEVELS OF HERMES AGENT. FROM CHATBOT TO 24/7 AUTONOMOUS SYSTEM.
2. product design
Vercel 发文《Teaching agents product design》,探讨如何教导 AI 代理产品设计思维。
Opinions/Thoughts
1. Simon Willison 发现 Sonnet 5 新 tokenizer 使英文成本增加约 40%
Simon Willison 分析 Claude Sonnet 5 的开发者文档后指出,新 tokenizer 使相同文本的 token 数大约增加 30%,意味着虽然官方定价与 Sonnet 4.6 相同,但实际每次推理成本提升约 1.3 倍(英文约 1.4 倍、西语 1.33 倍、简体中文持平)。此外,Sampling parameters 不再支持,adaptive thinking 默认开启。这一发现解释了为何很多用户报告 Sonnet 5 实际花费高于预期。
2. 访问 OpenAI、Anthropic 和 Cursor 后的一手印象:云代理是下一个大趋势
Pragmatic Engineer 作者通过访问三家 AI 领军公司发现,云代理正成为重大趋势:OpenAI 收购 Ona(Gitpod) 为 Codex 构建持久云环境,Anthropic 六个月的 Claude Managed Agents 项目专注于云托管长期代理,Cursor 的云代理在隔离 VM 中异步运行。OpenAI 内部超过 95% 的非工程师使用 Codex 进行编码。工程师的主要任务正从写代码转向构建让 Agent 高效运行的环境。文章还附有 Coinbase 如何优化每 token 成本的案例。
3. Artificial Analysis 评测 Sonnet 5:智能指数 53,任务成本高于 Opus 4.8
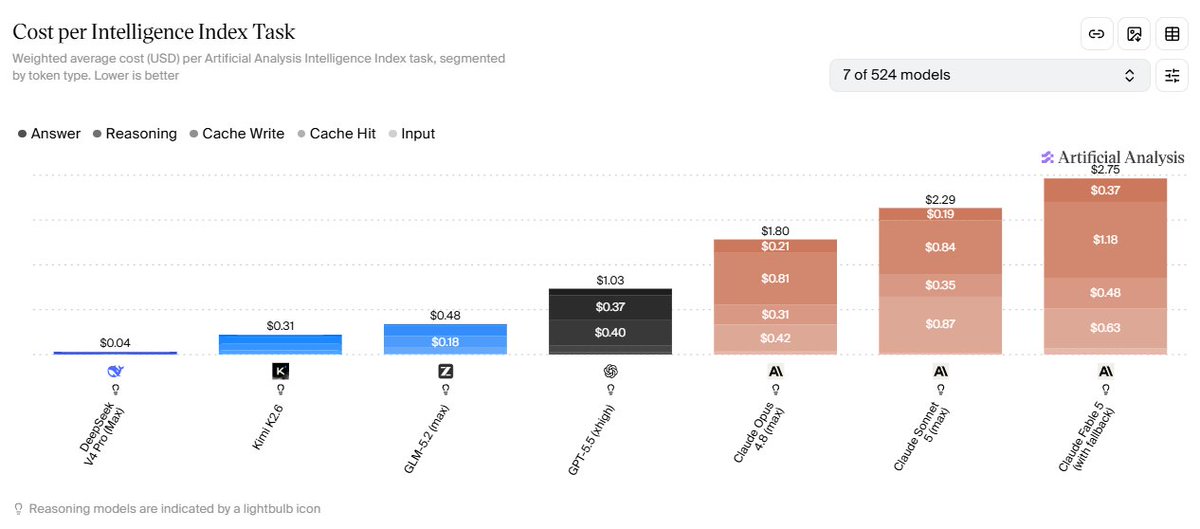
Artificial Analysis 发布 Claude Sonnet 5 的独立评测:在人工智能指数上得分为 53,比 Sonnet 4.6 高 6 分,与 GPT-5.5(xhigh)和 Opus 4.8 接近。但每个任务成本 $2.29,比 Sonnet 4.6 高约 2 倍,比 Opus 4.8 高约 15%。原因是 Sonnet 5 在任务中使用约 40% 更多输出 token,在知识工作评估中使用约 3 倍代理轮次。在知识工作评估中 Sonnet 5 已超过 Opus 4.8 仅低于 Fable 5。模型还缺乏 Fable 5 在一些硬推理基准上的表现。

4. Sonnet 5 成本对比:1.2 倍 Opus 4.8,57 倍 DeepSeek V4
用户 scaling01 发布 Sonnet 5 与其他模型的成本对比表:每任务成本 Sonnet 5 是 Opus 4.8 Max 的 1.2 倍,GPT-5.5-xhigh 的 2 倍,GLM-5.2 的 5 倍,Kimi-K2.6 的 7 倍,DeepSeek-V4-Pro 的 57 倍。虽然 Sonnet 5 在能力上接近 Opus 4.8,但其 token 消耗量大的特性使其在实际使用中性价比反而更低。这一对比引发了社区对模型选择时成本效率的广泛讨论。
来源:@scaling01
5. Tokenmaxxing 的终结:随着推理成本上升,AI tokens 需要精打细算
O’Reilly Radar 文章认为“Tokenmaxxing”(无节制使用 AI tokens 来显得高效)正在消亡,原因是推理模型和 Agent 的 token 消耗量暴增数百倍,导致成本失控。标志性事件包括 GitHub Copilot 从无限使用转向信用制、Anthropic 对 Fable 的定价是 Opus 4.8 的两倍、OpenAI GPT-5.5 比 GPT-5.4 价格翻倍。文章呼吁采用可观测性层、模型路由、本地模型等最佳实践来优化 token 支出,认为这是在预算约束下可持续发展的必要路径。
6. Claude Code 被发现默默编码上传中国用户位置信息引争议
研究显示 Claude Code v2.1.196 在默认系统提示中悄悄编码并上传用户是否位于中国的信息,包括时区、代理、AI 实验室连接等元数据。这一发现引发社区巨大争议,被指控为间谍软件行为。Anthropic 随后回应称将移除该行为。Teknium(Nous Research)等社区领袖借此倡导开源 Agent(如 Hermes Agent)的可审计性优势。开源与专有 Agent 之间的信任问题再次被推到前台。

7. Human in the /loop
探讨如何可靠地在代理工作流中插入和移除人类监督环节(Human in the loop)。