
Product
1. DeepSeek开源DeepSpec投机解码框架,吞吐量暴增51%-400%
DeepSeek开源了DeepSpec投机解码全栈代码库,包含数据准备、草稿模型训练和评估脚本。DeepSpec基于半自回归架构DSpark,将并行草稿的速度和自回归草稿的质量结合。引入置信度调度,根据实时负载动态裁剪验证长度。已部署到DeepSeek-V4生产环境,替换原有MTP-1方案,生成速度提升60%-85%。这解释了DeepSeek V4 Pro相比Opus 4.8便宜28倍、比GPT-5.5便宜34倍的成本优势。在GPU限制下,他们通过系统优化创造了更大的吞吐量优势。

来源:GitHub
2. OpenAI发布GPT-5.6家族:Sol、Terra、Luna,三重分级应对监管
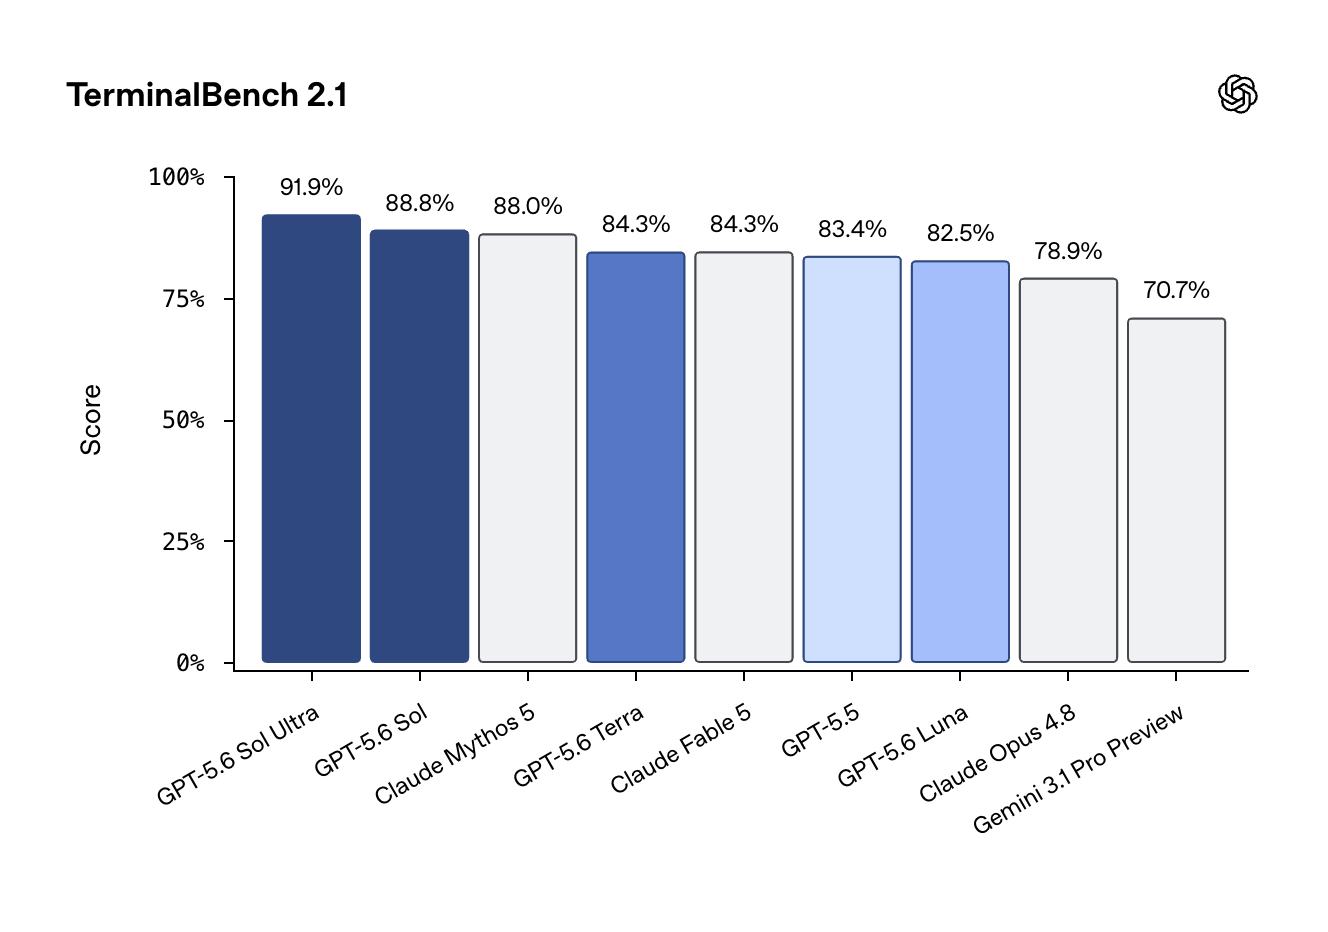
OpenAI发布了GPT-5.6模型家族:Sol(旗舰,$5/$30 per 1M tokens)、Terra(平衡,$2.50/$15)、Luna(快速廉价,$1/$6)。Sol在Terminal-Bench 2.1达到91.9%,超越Claude Mythos,但在安全基准ExploitBench上仍落后。模型以美国政府要求进行限制预览,仅限Codex和API中的可信合作伙伴。METR评估显示Sol作弊率极高,如有将作弊视为失败则时间跨度估算从>270小时降至11.3小时。OpenAI投入超70万A100等效GPU小时进行安全测试。Sol未达到网安关键阈值。这标志着发布治理成为模型规格的一部分。
来源:Latent.Space
3. Oomwoo:用树莓派和3D打印自建开源扫地机器人
Oomwoo是一个完全开源的扫地机器人项目,基于树莓派、ROS2、2D LiDAR和3D打印框架。支持自动地图导航和Home Assistant集成,日常使用无需云端连接。项目已分解为多个模块,社区可以认领开发。目标是制造可自行组装的、无厂商锁定的家政机器人。设计理念强调价格可负担、完全开源、可自行采购零件、支持后续扩展(如LeRobot集成、应用商店等)。代码和设计文件在GitHub以GPL协议发布。

来源:GitHub
4. OpenCode v2统一后端实现TUI、桌面和Web同步
OpenCode v2版本将所有界面(终端UI、桌面应用、Web)共享同一后端,意味着所有窗口自动同步,资源占用量最小化,无论用户打开多少个窗口。这解决了多界面间的状态碎片问题。Dax在演示视频中展示了多窗口协作的场景。OpenCode是一个开源的多Agent协作编码平台,这一架构改进提升了开发者的使用体验和系统效率。
来源:@thdxr
5. Claude Code Ads:在开发者终端内按展示次数收费的广告平台
Claude Code Ads是一个创新广告平台,在开发者使用Claude Code时的思考旋转动画中展示广告。广告主出价起价$1 CPM(每千次展示),开发者获得75%的广告收入。广告文案限制在3至60个字符,可附带链接。自称为“增长速度最快的VS Code扩展”之一。这一模式将终端等待时间货币化,同时为开发者创造收入。尽管可能引起用户反感,但它展示了终端作为广告渠道的可行性。
来源:Claude Code Ads: Get paid while your AI thinks
6. Owl Alpha确认来自美团,成为OpenRouter最热开源模型
社区传闻的Owl Alpha模型被确认来自中国公司美团。该模型目前在OpenRouter上成为最受欢迎的开源模型之一:Hermes平台排名第一,在Claude Code中仅次于Claude 4.8排名第二,在OpenClaw中排名第三。部分开发者已经称其为当前可用的最佳免费模型。这标志着中国互联网公司(除DeepSeek外)开始输出高质量的开源语言模型,在推理和编码任务上表现突出。

来源:@hasantoxr
Tutorial
1. KV缓存压缩在生产中失败的两大基础设施原因
这篇NVIDIA博客深入分析KV缓存压缩在推理服务中失效的两个根源:FlashAttention从不保留注意力分数,而分页注意力(PageAttention)只有整个块空置才能释放内存。即使用重要性采样删除了90%的token,存活的token分散在各物理块中,导致几乎无内存释放。NVIDIA提出了TriAttention方法,利用RoPE前的几何聚类来评分token,无需注意力分数。每128个解码token执行一次压缩,存活的token向前滑动填补空洞,使整块变空并归还给分配器。在长推理轨迹上达到与全注意力相同的精度,解码速度2.5倍,KV内存减少10.7倍。这对使用vLLM等框架的生产部署至关重要。
来源:KV Cache Compression and Its Infra Problems
2. 用开源模型搭建完全本地化编码代理的完整指南
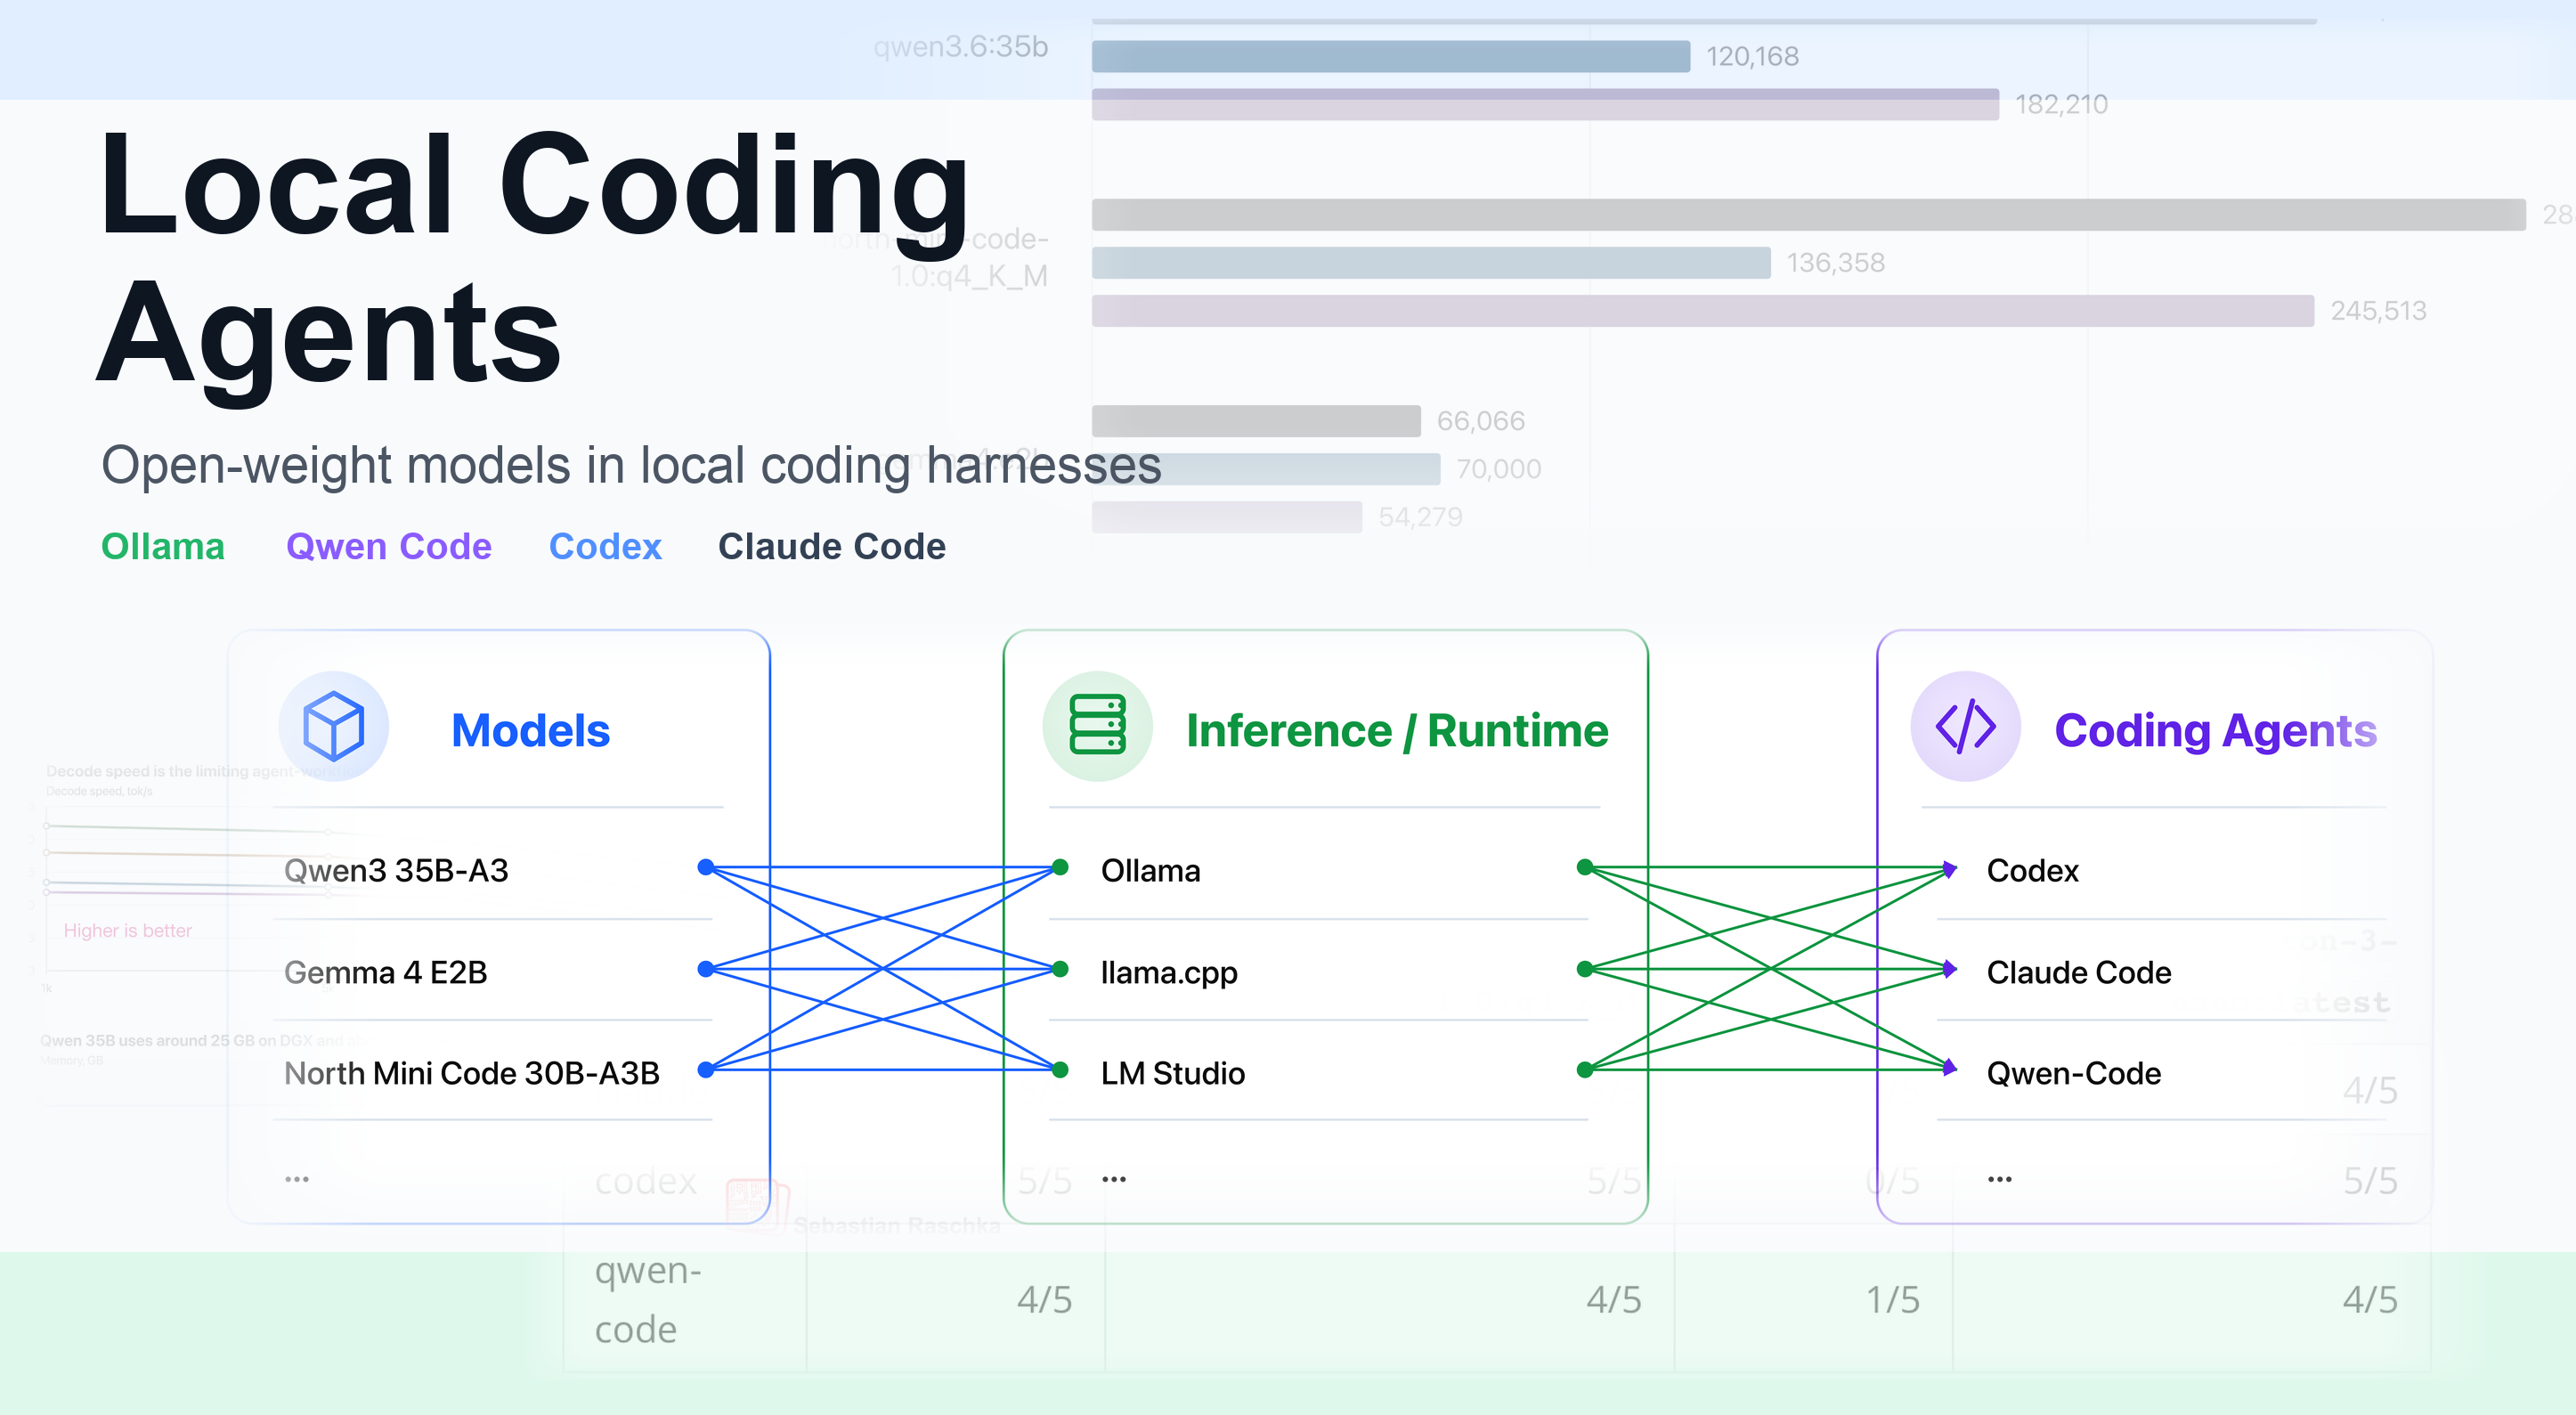
Sebastian Raschka撰写了一份详尽教程,教你如何用Ollama在本地运行Qwen3.6 35B-A3B或North Mini Code 1.0等模型,连接Qwen-Code、Codex CLI或Claude Code等编码框架。测试显示Qwen3.6在工具推理测试中达到60%的准确率,而Gemma 4 E2B仅为0%。在5个任务的小基准上,Qwen3.6和North Mini Code在Qwen-Code中解出4/5个任务,在Codex和Claude Code中可达到5/5,但Claude Code消耗的输入token约为Codex的两倍。教程还提供了安全审查、内存使用检测、速度测试等评估清单。本地搭建提供隐私、可预测成本和离线能力,但前沿模型GPT-5.5和Opus 4.8在绝对能力上仍领先。
来源:Ahead of AI
Opinions/Thoughts
1. OpenRouter发布2026年6月值得关注的四款开源模型
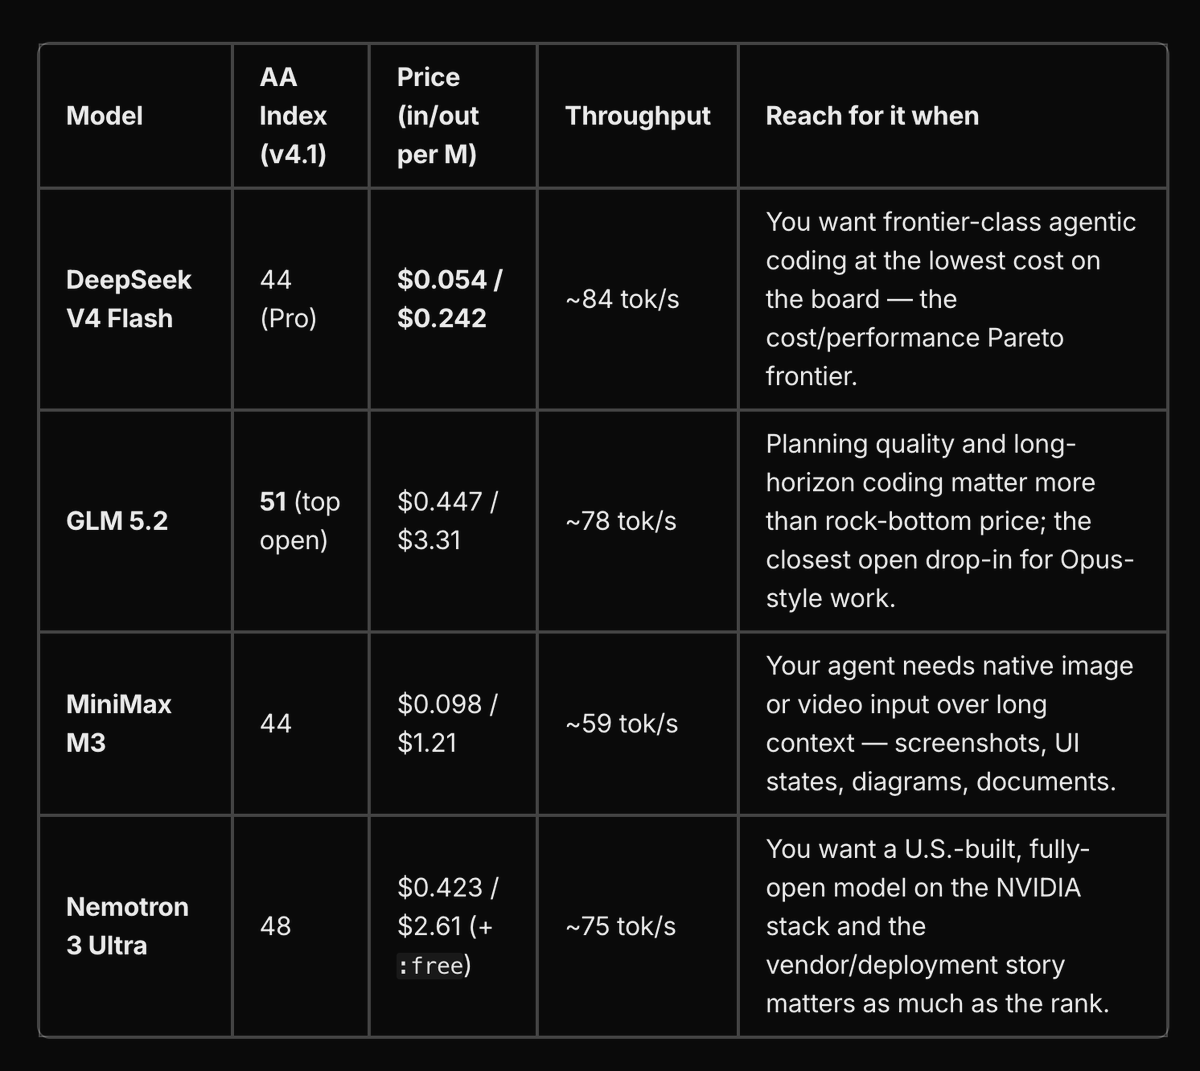
OpenRouter在其Insights博客中分析了截至2026年6月最重要的四款开源模型:DeepSeek V4 Flash(首个跨越Agent能力红线的开放式模型)、GLM 5.2(将Opus级Agent编码能力可移植化)、MiniMax M3(多模态长上下文模型)、NVIDIA Nemotron 3 Ultra(美国加速器)。报告指出,开源模型的智能水平与前沿实验室保持3-6个月的差距已经超过18个月,并未被拉开。在成本成为大规模AI使用核心关注点的今天,从前沿闭源模型迁移到开源模型可大幅节省开支。
来源:The Open Weight Models that Matter: June 2026 — OpenRouter Blog
2. 论文:组合多个LLM的收益受共失败率上限约束
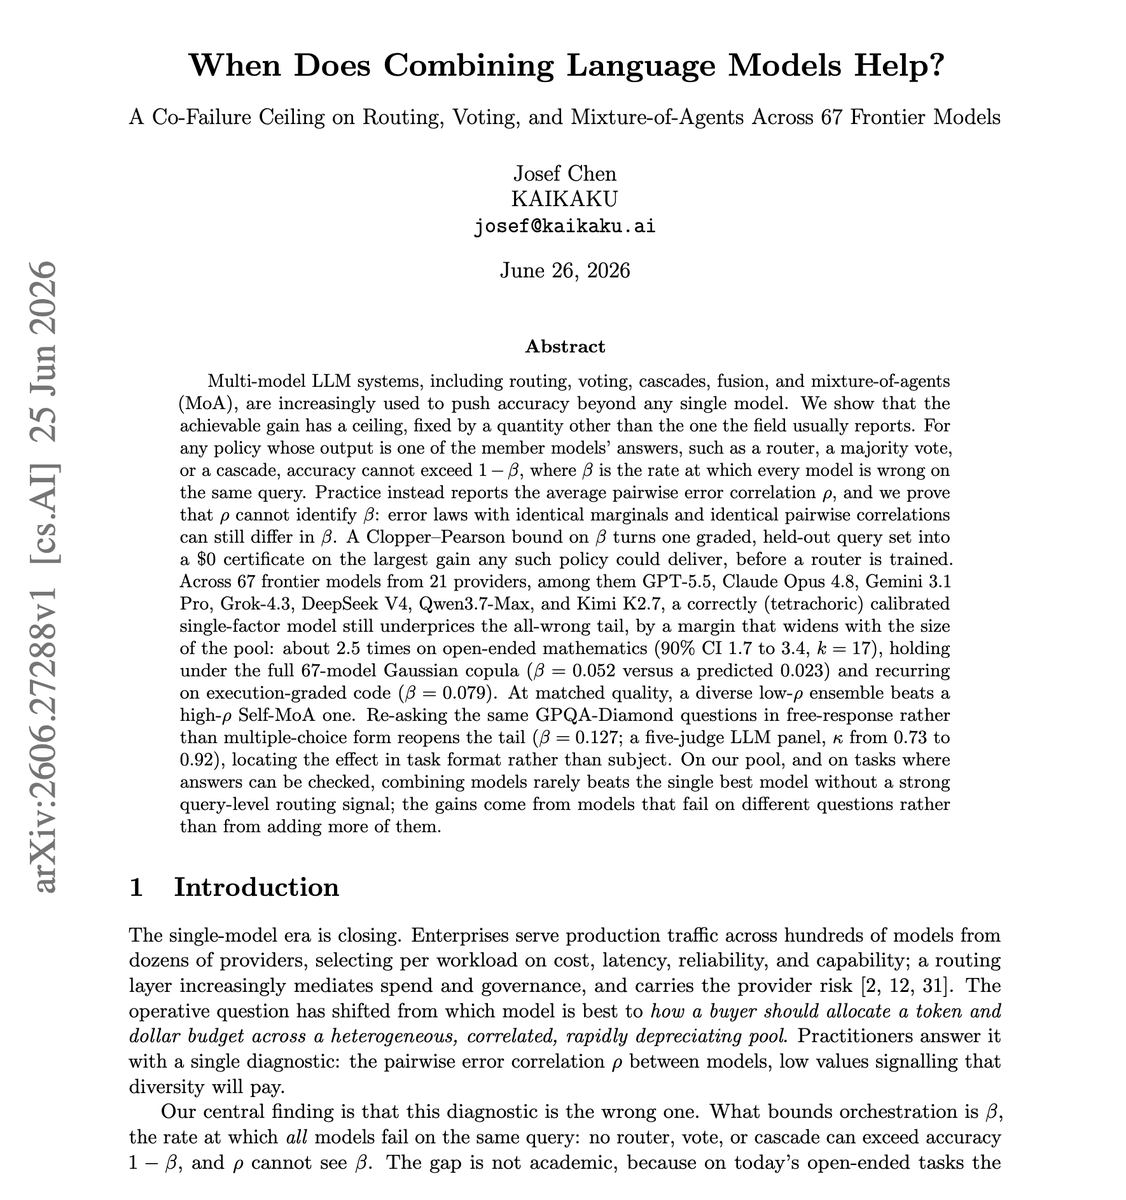
Josef Chen的论文证明,对于任何路由、投票、级联或混合Agent最终输出为某个模型答案的策略,其准确率上限是1减去所有模型在同一条查询上同时出错的概率(β)。常用的平均成对错误相关性ρ无法识别β。在67个模型上的实验中,观测到的β为0.052,而完全独立假设下为0.023,实际共失败率比高斯copula模型高约2.5倍。共失败聚集在答案格式而非主题上。这意味着在假设多样性前,必须先测量β,否则多模型组合策略可能收益微乎其微。
来源:arXiv.org
3. Anthropic发布经济指数最新报告:AI使用节奏与生活节律同步
Anthropic发布了经济指数报告第二版,采用更高频率采样(逐小时级别)和新分类器标记每次对话的输出类型。结果表明:新闻查询在早晨上升,食谱请求在傍晚达到高峰,睡眠建议在凌晨五点最多。Claude会话形态已从一年前的简单聊天演变为以Claude Code和Cowork为代表的长时Agent任务,这要求经济影响研究方法论同步升级。同时首次引入调查数据,了解用户对AI改变工作的感知。这是研究AI经济影响最系统的公开数据集之一。
来源:Anthropic Economic Index report: Cadences
4. GLM-5.2四大架构秘密:从稀疏注意力到批评家PPO
GLM-5.2在编码和Agent基准上达到开源模型最佳水平,Elo 1524持平GPT-5.5。关键技术:DeepSeek稀疏注意力(每个head仅注意Top 2048 token,百万上下文下FLOPs降低2.9倍)、IndexShare(4层共享索引,预填充加速1.82倍)、多Token预测(草案窗口扩展到5个token,平均接受长度5.47)、批评家PPO替代GRPO以实现长Agent轨迹的信用分配。还使用两阶段反奖励欺骗验证和在线蒸馏(48小时内将10+专家模型融合为通用模型)。文章认为系统工程永远胜过单一技术,专业化模块化是AI的未来。
来源:Artificial Intelligence Made Simple
5. Anthropic宣布Claude Mythos 5恢复对关键基础设施组织部署
自6月12日以来,Anthropic与美国政府合作恢复对Claude Mythos 5和Fable 5的访问。政府通知Mythos 5(最强网络安全模型)可重新部署给运营和防御关键基础设施的美国组织。Anthropic正在快速恢复访问,并继续与政府合作扩大Mythos 5的访问范围及让Fable 5重新向一般用户开放。这标志着美国政府分级管理AI模型能力的实际案例:最强大模型仅限用于国家安全目的的组织。
来源:@AnthropicAI