
AI 日刊 · 2026-10-12
Product
1. OpenAI 将 GPT-6.1 Sol 的默认上下文从二十七万上调到五十万
OpenAI 的 Thibault Sottiaux 写明,GPT-6.1 Sol 通过 Codex 和 Work 使用时,默认上下文从 27.2 万升到 50 万,增幅约 80%。上限仍是 100 万。用户可以自行调高或调低。他给出的理由是减少压缩,并保住需要长期保留细节的任务。新默认值经过测试,被他称为目前大多数用户的平衡点。以后还会再提高。这不是新模型发布。窗口变大也不自动等于回答更好。这次改动直接针对的是压缩变少。


2. REA 让编程智能体逆向没有源码的软件
REA 是一个 MCP,把逆向工具接到 Claude Code、Codex、Cursor 这类编程智能体上。可检查的对象包括原生二进制、JavaScript 和 Electron 应用、.NET 程序集,以及网站。分析在本地运行,结论要带证据和限制。原生分析可以使用已有的 Hopper、Ghidra 或 IDA,静态 JavaScript 分析不需要这些引擎。安装命令是 npx rea-agents setup。转发者使用了“软件之死”这种说法,仓库写的是另一件事:看到一个功能,让智能体在没有源码时说明它如何工作,并给出证据。
来源:GitHub
3. Skills Manager 集中管理五十多种编码工具的技能
Skills Manager 用 Tauri 2 和 Rust 写成。它把 Claude Code、Codex、Cursor 等五十多种编码工具目录里的技能收进一个中央库,默认位于 ~/.skills-manager。来源可以是 Git 仓库、本地文件夹、zip、.skill 包,或 skills.sh 市场。预设可以把一组技能一次性开关。这是一次复制,不是持续同步。仪表盘允许智能体通过这个应用安装和分发技能,而不是直接改各工具目录。来源、更新追踪和每个工具的状态因此还能保留。它管理的是技能文件的安装和分发,不判断技能内容好不好。

来源:GitHub
Tutorial
1. Uzu 用投机解码把本地推理提到每秒九十多 token
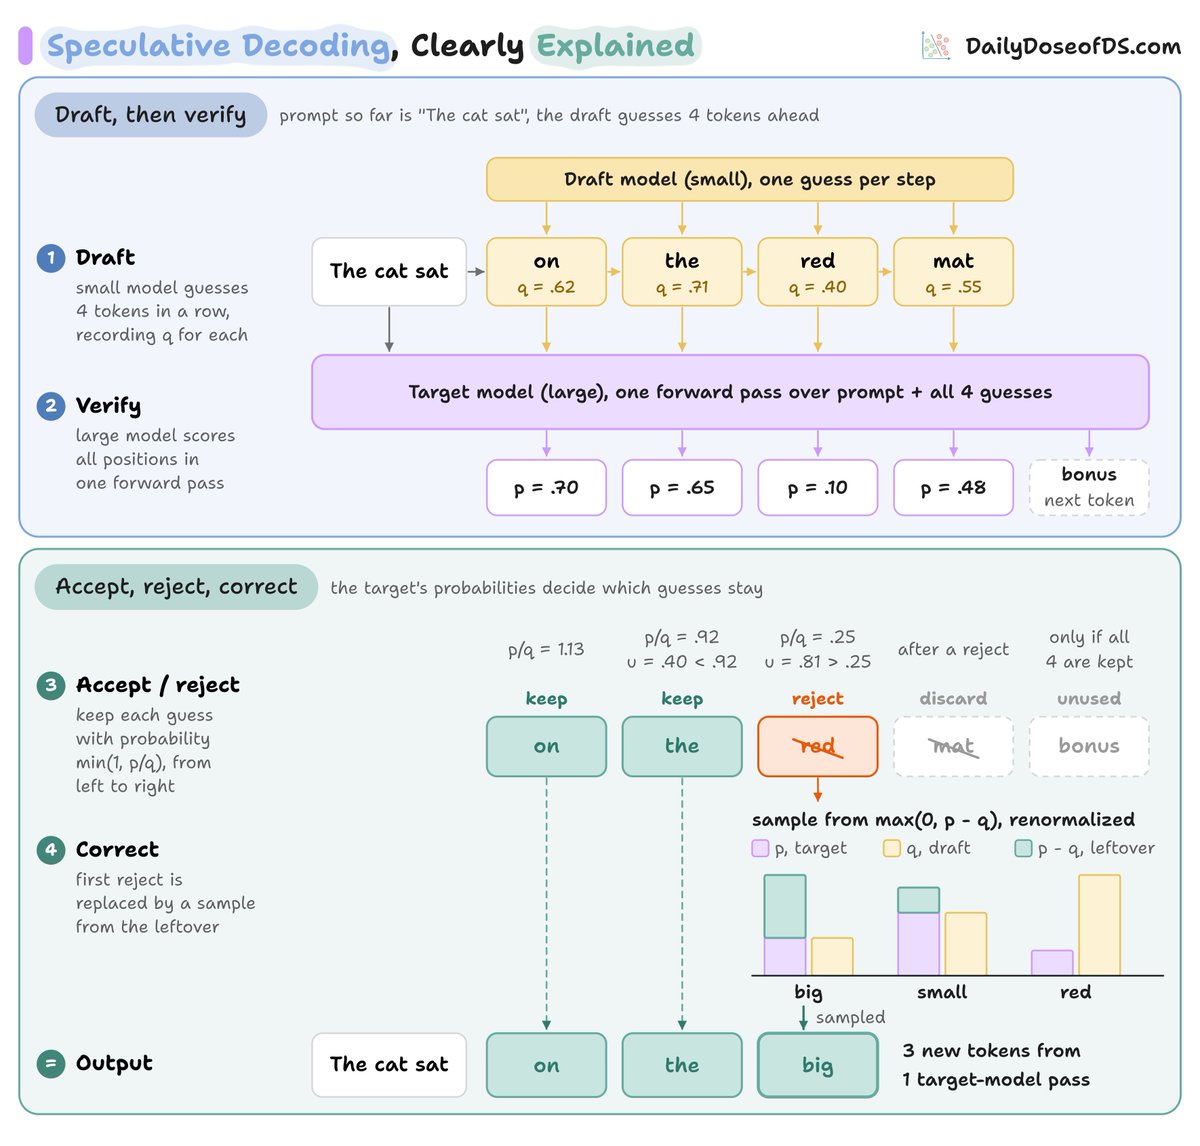
本地单条生成慢,是因为每个 token 都要把权重从内存读一遍。文章用基础 M5 的每秒 153 GB 和 4-bit Qwen3.5 9B 约 5.2 GB 估算上限,约每秒 29 token。同一编码提示上,llama.cpp 约 22,MLX 约 25。Uzu 一次草稿最多 16 个 token,再由主模型一次验证。同一机器、模型和提示上,文章记录到每秒 92 到 117 token。它把激活量化到 int8,以走 M5 的整数矩阵路径,并用 32 元的随机 Hadamard 变换打散离群值。对比的是完整引擎路径,三条路径的量化配方并不相同。文章要求一次只跑一个服务,并丢掉第一次预热。接受率会随提示变化。
来源:Karpathy’s Trick for Faster Local LLMs, finally has a proper solution
2. 编码智能体脚手架消融显示弱模型与前沿模型需要不同工具
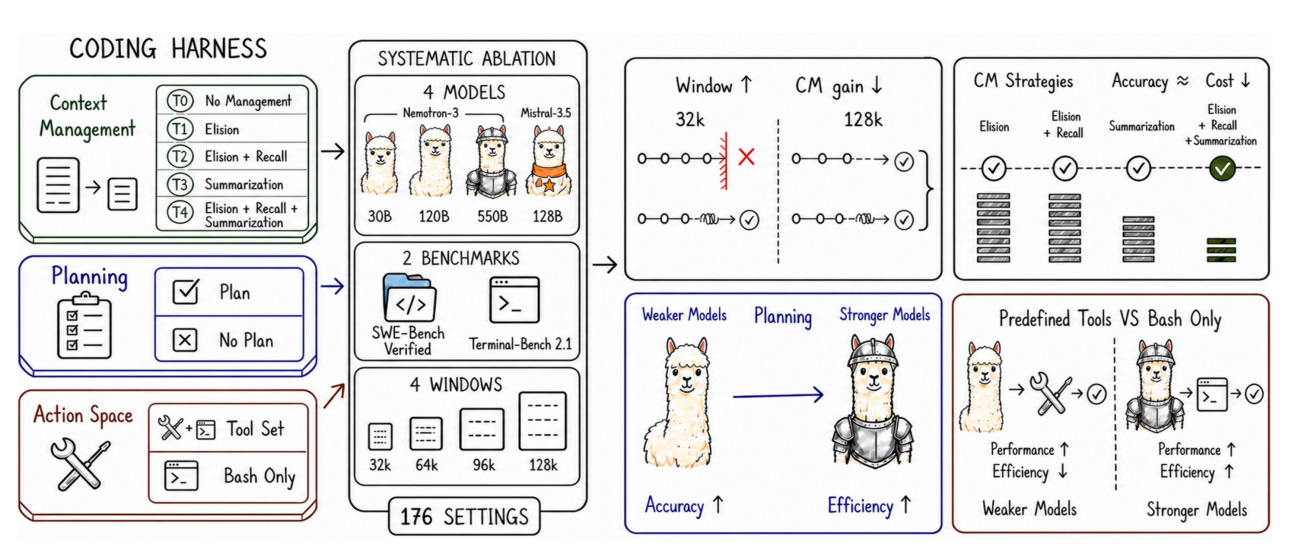
Machine Learning At Scale 介绍论文《An Empirical Study of Harness Design for Coding Agents》。作者用模块化 ReAct 循环,在 SWE-Bench Verified 和 Terminal-Bench 2.1 上做了 176 组设置。模型包括 Nemotron-3 的 300 亿、1200 亿和 5500 亿参数,以及 Mistral-Medium-3.5-128B。上下文从 3.2 万到 12.8 万 token。公开部分给出三条结果。复杂的上下文检索很少被调用,准确率不高于简单的规则裁剪。持续规划对弱模型是完成任务的条件,对前沿模型主要是减少重复验证。专用工具集帮助弱模型,却限制更适合直接使用 Bash 的前沿模型。评测整个产品会把规划、动作空间和上下文策略混在一起。
Opinions/Thoughts
1. Karpathy 再次提出 LLM 能力认知正在变成陡峭漏斗
Andrej Karpathy 重发四月的一条帖子,理由是人们对 LLM 能力的共同理解差距正在变宽。这已经不像两组人各说各话,更像一个陡漏斗。Yanhua 按这条帖子的粗略估算画了四层。约 60 亿人,约占 75%,几乎没用过 LLM。10 亿到 20 亿人用过免费版,把它当成有点笨的聊天机器人。约 2000 万人,约占 0.2%,会把数周项目交给智能体写代码或做数学;约 5000 人接触内部前沿系统,让成千上万个智能体协作数周。这些是餐巾纸估算,不是普查。论点是:同一时间,各层看到的不是同一个 AI,所以争论经常没有共同对象。

来源:@yanhua1010
2. magpie 十九天约九千星,引发全自动开发争议
WquGuru 写,yetone 的 magpie 从 9 月 23 日建仓起,19 天约 9200 星,版本到 v0.1.1203,过去 24 小时发了 25 版。附图里的争论不是星数,而是质量控制。批评者说,需求一提出,AI 就写 PR、自动合并、自动发版,版本已经滚到 v0.1.1187 以上。yetone 回应,他自费订阅昂贵模型,全天候实现用户需求,软件免费。批评者接着说,生成越快,越需要代码审查、测试和发布流程,免费和开源不取消被批评的资格。事实部分是发布速度,争论的核心是速度和审查是否匹配。

来源:@wquguru