AI 日刊 · 2026-10-13
Product
1. Meta 推出 Muse Wonder 系列,主打长期个人与职业任务
Meta 发布 Muse Wonder 和 Muse Wonder Full。Wonder 已可通过 Meta Model API 和 Muse Code 使用,Full 先提供给 Muse Code 订阅用户。官方把两项能力称为 Active Memory 和 Active Focus:前者跨对话取回相关上下文,后者在任务受阻时继续换方法。官方最大推理档对比表里,Artificial Analysis Index 为 Full 56、Wonder 52、Claude Opus 5.5 为 58;同一张表上,Full 的 DeepSWE 1.1 是 79.0,SWE-Marathon 是 57.5,Harvey LAB-AA 是 13.1。FocusBench 上 Full 是 54.2%,Wonder 是 44.9%,GPT-6 Astra 是 47.7%,Opus 5.5 是 45.8%;MemoryBench 上 Wonder 是 85.6%,Full 是 85.5%;ProgramBench 上 Opus 5.5 是 70.5%,高于 Full 的 59.0%。这些是 Meta 自己的最大档结果,博客写模型在 Prometheus 数据中心训练。官方回复还说 Muse Spark 的开源权重即将放出。
来源:@AIatMeta
2. Anthropic 称新防御让蒸馏提取的推理下降约一个数量级
Anthropic 发文称,新防御让蒸馏者在自家平台提取到的推理 token 降到原来的约十分之一到百分之一。文章点名智谱在开发 GLM-5.3 时蒸馏美国模型的网络能力。它称智谱试过 Claude Fable 5,防护使攻击变差后,改用更旧的 Claude 和另一家实验室的模型。文章还写,Moonshot 的 Kimi 请求曾被秘密转到 Claude。其中一条被 Anthropic 认为与中国军方有关的请求,是在分析成都某个人的监控画面。新办法限制推理跨对话、跨模型和跨账号移动,并用两级分类器拦截提取,误报率低于 0.1%。反复尝试的账号会被限流或封禁。自 9 月 24 日起,这类被拦截请求也要收费。
来源:Strengthening our defenses against distillation attacks
3. X 推出五档统一订阅,把 Grok、Cursor 和会员收进同一账单
SpaceXSI 宣布把 Grok、Grok Bot、Cursor 和 X Premium 收进 The X Subscription。官方图列出五档价格:Free、Plus 8 美元、Premium 30 美元、Super 100 美元、Ultra 200 美元。Grok 一栏写的是聊天、语音、图像、视频和 API。Cursor 一栏是本地和云端编码。X Premium 一栏是蓝标、创作者工具和更少广告。官方称每一档对自己模型的单位用量,都高于它替换的旧方案。现有用户可以保留旧方案,或切换并关联 Grok、Cursor 和 X 账号。推出是逐步的,是否开放要看账单设置。

来源:@SpaceXSI
4. 智谱发布 GLM-Legal,自称法律代理基准高于基座模型
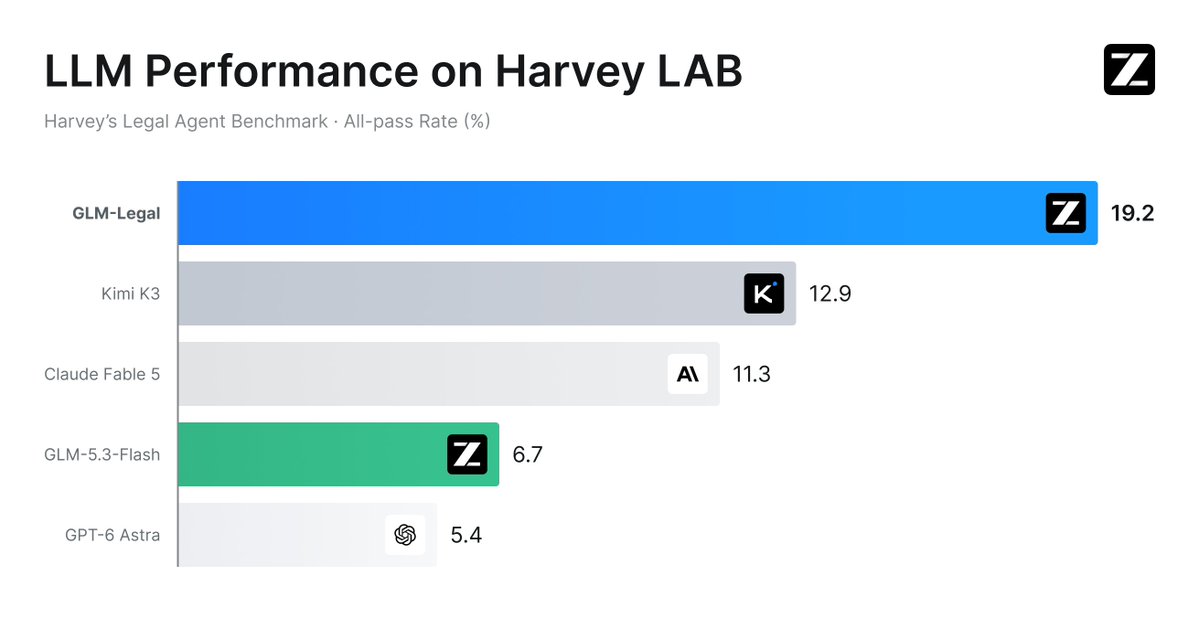
智谱发布 GLM-Legal,基座是 GLM-5.3-Flash。帖子写它面向合同审查、证据分析和合规,并称在主流法律基准上对齐前沿模型。随帖图表只公开了 Harvey Legal Agent Benchmark 的全通过率。GLM-Legal 是 19.2%,Kimi K3 是 12.9%,Claude Fable 5 是 11.3%,GLM-5.3-Flash 是 6.7%,GPT-6 Astra 是 5.4%。同一张图上,基座只有 6.7%,所以提升来自法律专项,不是基座原有分数。这是智谱自己的图,指标是 all-pass rate。它和别家用不同口径报出的法律分数不能直接横比。API 需要申请。
来源:@Zai_org
5. Factory 上线可复用沙箱 Environments,云端 Agent 不必每次重装
Factory 宣布 Environments 一般可用。它是 Droid 云端沙箱的可复用定义,包含仓库、工具和依赖,并预先构建成镜像。官方说这样 Agent 不必每次重新克隆和安装。镜像每隔几小时重建,只有通过验证的构建才会上线。Automations 可以按计划运行,或响应 Slack、GitHub 和 webhook,并在最新验证过的沙箱里启动。Agent Readiness 给仓库打 1 到 5 分。官方说多数企业客户从 2 分开始,Missions 更适合 4 分以上。
来源:@FactoryAI
6. Anatomy 技能用一句话生成可旋转的等轴机械结构
wheresryan22 发布 Anatomy 技能。用一句话描述机器,Claude 生成可检查的立体演示。原文列出三类输出。一是可旋转的等轴立体线框。二是用 WebGL 着色器表现火、水、等离子体等效果。三是零件可以各自旋转和移动。它被写成一个可安装的技能,由 Claude 根据一句描述生成。这适合解释机械结构,因为观察者能转动物体、单独看零件,而不是只看一段生成视频。它不提供新的基础模型,也不替代专用视频模型。
Tutorial
1. Anthropic 讲解动态工作流,让 Claude 自己决定 Agent 怎么分工
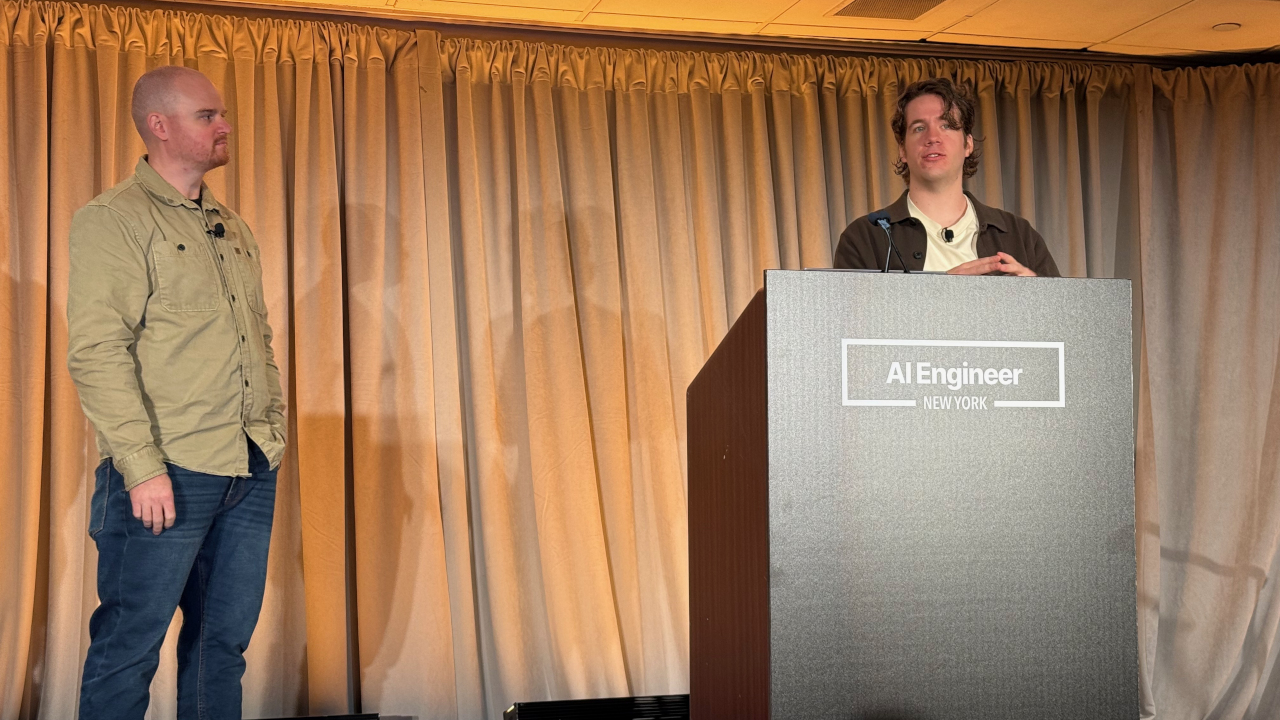
Latent Space 记录了 AI Engineer New York 上 Anthropic 对动态工作流的说明。CJ Avilla 和 Harrison Stall 说,flows 让 Claude 自己写编排程序,决定怎么拆任务、启动 Agent 和收集结果。开发者仍可在配置里放入预先设好的子 Agent。演示是股票观察列表。扫描阶段把代码分给隔离上下文的 Agent,复查阶段再出报告。Stall 说模型运行时不知道预算,但开发者可以设 session 预算。Avilla 说同样任务上,flows 比单 Agent 贵很多,也找出更多细节。子 Agent 不能通过 API 直接互发消息,但共享文件系统。
来源:Latent.Space
Opinions/Thoughts
1. 同一模型换 harness,DeepSWE 分数可以差三十五个点
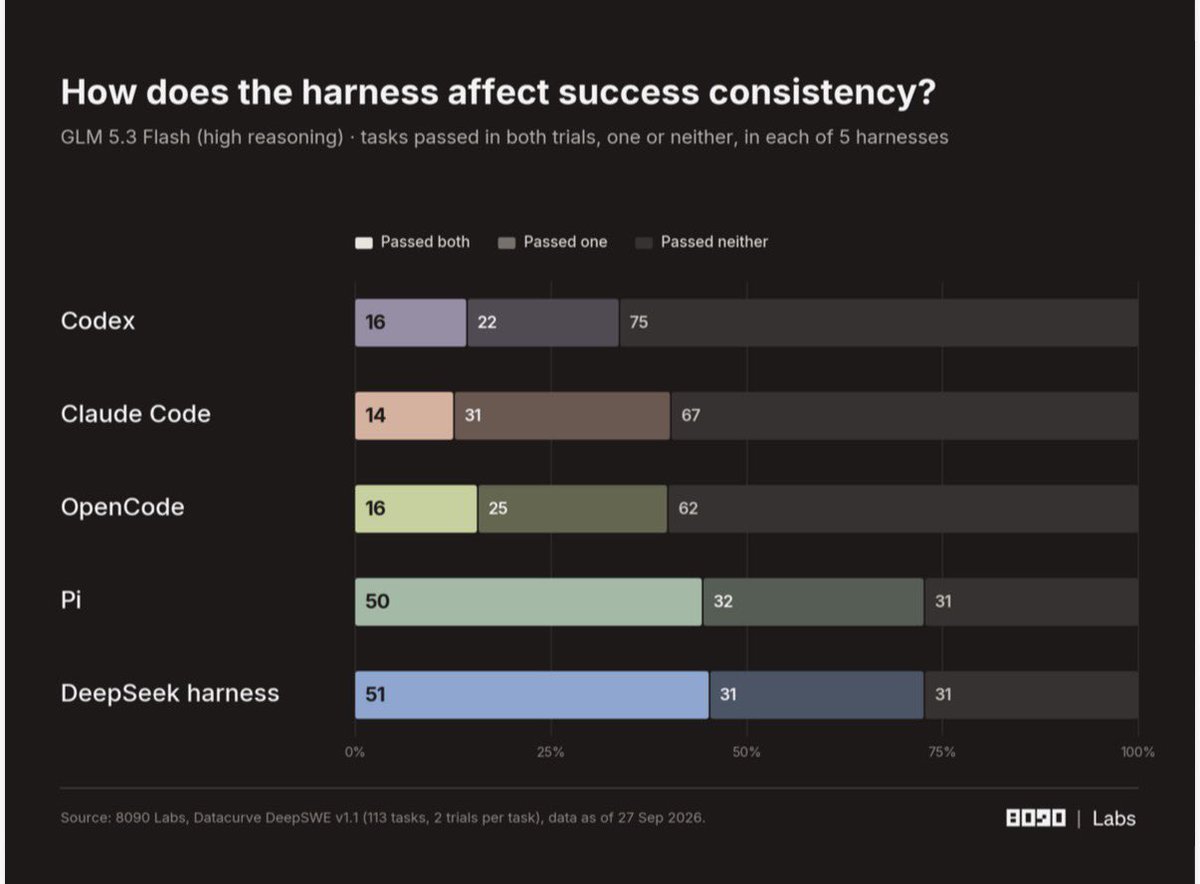
Chamath Palihapitiya 用 8090 Labs 的图说明,排行榜分数离不开 harness。数据是 Datacurve DeepSWE v1.1,113 个任务,每题 2 次,截止日期是 2026 年 9 月 27 日。GLM 5.3 Flash 在 Codex 上是 24%,在 DeepSeek harness 上是 59%,相差 35 个点;Claude Fable 5.1 从 Claude Code 的 41% 到 Codex 的 61%,相差 20 个点。更强的 GPT-5.6 Sol 只差 6 个点,Grok 4.6 差 5 个点。高推理档的 GLM 5.3 Flash 另有一组:Codex 24%,Claude Code 26%,OpenCode 27%,Pi 58%,DeepSeek harness 59%。一致性图里,DeepSeek harness 有 51 题两次都通过,Codex 只有 16 题。成本图把失败也算进去:OpenCode 上每个验证通过的任务是 1.64 美元,Pi 上是 0.22 美元。图注写 GLM 用的是 9 月 9 日结束的促销价,牌价是两倍。



来源:@chamath
2. h1 用简单 Lean 反馈做出形式化证明高分,而不是手写分工
Skander Moalla 介绍 h1。它不预设分解、搜索树或多 Agent 层级,只给前沿模型一个高效的 Lean 接口,循环做推理、编辑、验证和反思。单次运行的结果包括 FATE-X 90/100、Formal Conjectures-Solved 78/100、FormalQualBench 14/23、Putnam 2025 12/12、IMO 2026 6/6。在对齐模型后的美元成本上,他说 h1 经常不低于手工设计的流程。同一个 Gemini 3 Flash、同样 20 美元预算,在 Putnam100 上 AxProverBase 是 18/100,h1 是 69/100。开放 Erdős 问题子集上,h1 一次更长的运行是 82.5%、121 美元,AlphaProof Nexus basic 的 pass@3 是 75.4%、191 美元。他强调一次 pass@1 不是一个点,而是测试时计算量的函数。结论不是 harness 不重要,工程应花在反馈、持久执行和接口上。