
Product
1. Gemini 3.8 Flash 与 Cyber 同日发布
Google 发布 Gemini 3.8 Flash 与 3.8 Flash Cyber,距 3.7 Flash 仅三周,是六周内第三次 Flash。二者同一底座,定价与 3.7 相同:每百万 token 输入 0.75 美元、输出 3.75 美元,该价到 2026 年 12 月 31 日截止,之后升至 1.50 / 7.50 美元。官方称 3.8 在长程软件工程上接近更高价旗舰,DeepSWE v1.1 上超过多数更大模型;HLE-Verified 为 54.9%,并在 Vals Finance Agent V2 与 Harvey Legal Agent 上超过 3.7。设计取舍是“更卖力”:复杂任务会多走推理步、多次调工具,高努力档 token 更多;要省算力可降努力档或继续用 3.7。Cyber 走 Fairwind,只给受信任的防守方。内部跨 20 种语言的漏洞发现成功率超过 70%;CWE-Bench 上 pass@1 为 47.2%,与某旗舰的 47.8% 接近但更便宜。Chrome 安全组称正确补丁数是更大商用模型的 2.6 倍;Wiz 称内部渗透测试召回高 7.5–9.7%,成本低 2.3–5.2 倍。开发者可在 Antigravity、Gemini API、AI Studio 与 Android Studio 使用;企业走 Gemini Enterprise;消费者需 Google AI Pro / Ultra。
来源:Google
2. Meta 推出 Muse Spark 1.3
Mark Zuckerberg 宣布 Muse Spark 1.3 开始推送,称这是迄今在编码与代理任务上最大的一跳,并说性能“便宜到几乎不用计费”。入口是 Muse Code 与 Meta 模型 API。下一步预告两件事:代号西瓜(🍉)的更大升级,以及 Muse Spark 开源权重。帖文没有给出基准分数或价目表,定量对比要另看第三方榜。

来源:@finkd
3. CursorBench 3.2:Fable 5.1 领先
CursorBench 3.2 用真实 Cursor 会话里的模糊、跨文件任务评代理。榜首是 Fable 5.1 Max,73.4 分,每任务约 9.64 美元、72,060 token、70 步。Fable 5.1 Extra High 为 72.8 分、6.96 美元。Grok 4.6 Extra High 70.8 分、仅 2.81 美元,性价比突出。Gemini 3.8 Flash High 69.2 分、2.38 美元,但平均 161 步、约 8.2 万 token,明显更“勤快也更啰嗦”。GPT-5.6 Sol Max 67.2 分。同一模型换努力档,分数与账单差一截;Flash 类模型用更多步数换接近旗舰的分。
来源:Cursor
4. Anthropic 开源电商 Agent 蓝图
Anthropic 发布 Claude 电商代理蓝图,含购物 Agent 与商家 Agent,覆盖零售、旅行、电信、票务四个可运行垂直示例,并带 Claude Code 插件。代码可跑在 Claude API、Amazon Bedrock、Microsoft Foundry 或 Vertex AI。官方称已上线零售商的购物代理购物车最大约增 35%,成交意愿约增 60%;点名 Shopify、Priceline 等。购物 Agent 做目录搜索、多件规划、个性化、会话内展示与客服,支付仍交给现有结账或代理支付商,并用护栏把价格和商品钉在真实目录上、避免操纵式加购。商家 Agent 看销售、库存、定价与营销草稿,上线前需人批准。Visa、Mastercard、Accenture、Intuit、Klaviyo 等出现在背书名单里。时机对准假日季规划。
来源:Claude
5. OpenCode v2 内置会话级终端
James Long 演示 OpenCode v2 内置终端:基于 libghostty,按会话隔离,重启后仍在,用来快速跑任意命令。这是把“代理旁边再开一个终端”收进同一产品,而不是让模型去猜你本机 shell 的状态。速度卖点来自 Ghostty 的终端核心,而不是再包一层 WebView。
来源:@jlongster
6. API 上出现 GPT-6-Astra 路由名
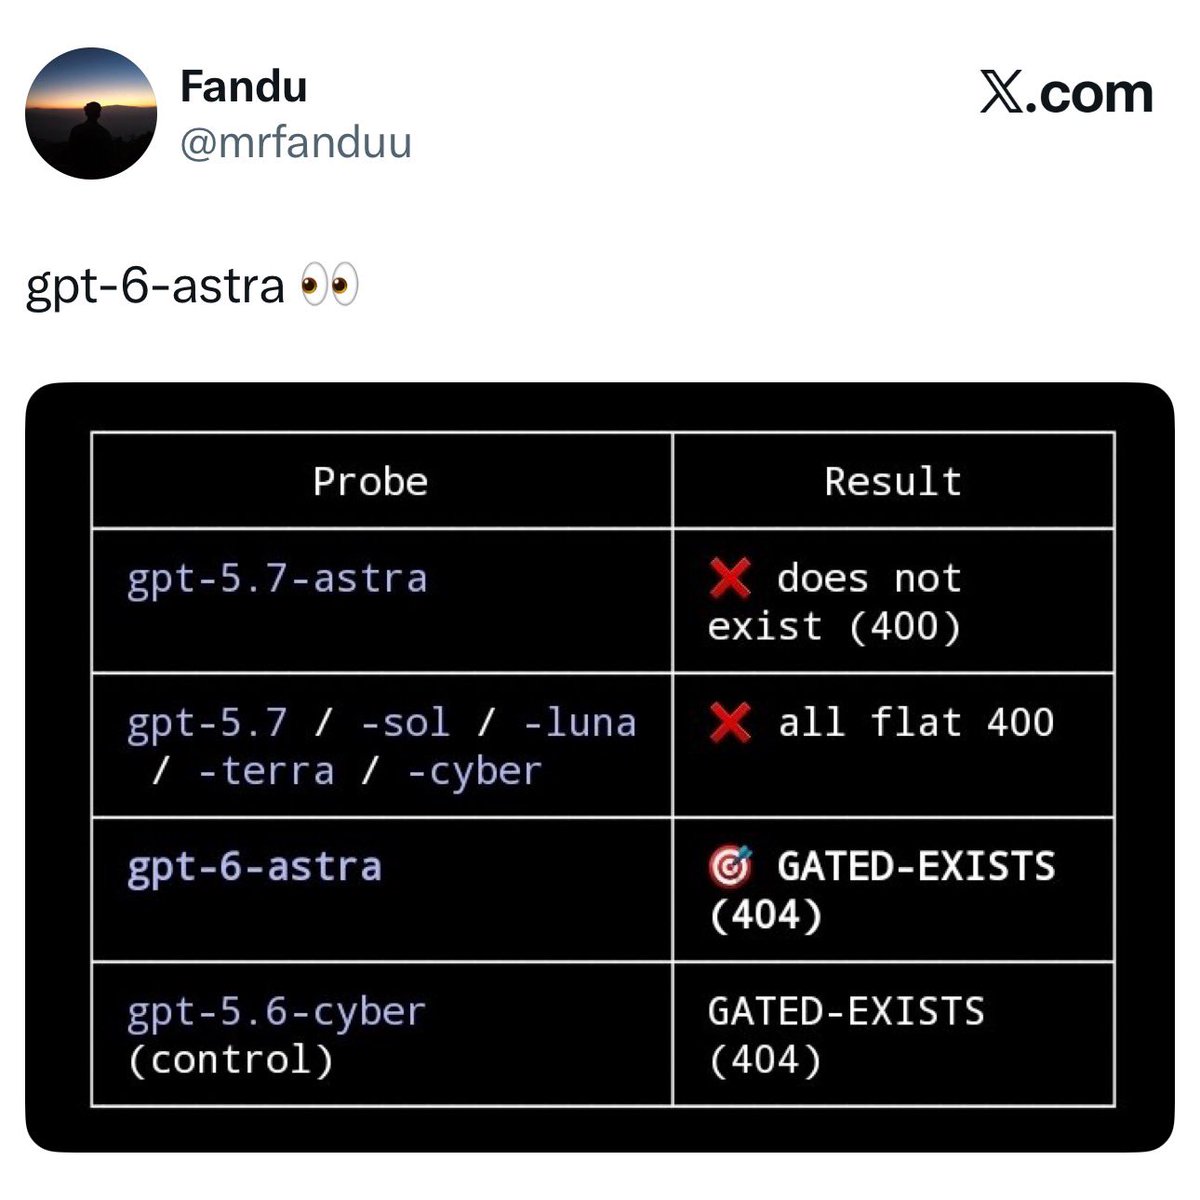
TestingCatalog 称在 API 上看到 GPT-6-Astra 的 model slug,并猜测若次日上线会是“巨大的一周”。截图还显示 routing 相关字段。这是泄漏级观察,不是 OpenAI 发布说明;slug 出现不等于对公众开放,也不等于能力与此前 Astra 安全阈值声明绑定。
Tutorial
1. Fable 5.1 官方提示词差异指南
Anthropic 文档列出 Fable 5.1 / Mythos 5.1 相对 Fable 5 的行为差:努力档要重新扫,名称不对应同一思考量;默认用户可见的进度更新更少,需打开 thinking.display 的 updates;编码/电脑循环里可能每轮只调一次工具,要显式要求并行;对话史必须只追加,改旧轮会打穿缓存与 thinking block。另外还有写得太密、聊天缺结构、低努力档少搜索、误拒绝、整文件重写、xhigh/max 长输出顶满 max_tokens、主代理干等子代理、看图不够细等条目。elvis 称按文档改提示后,“claudese”有下降。旧 Fable 5 提示大多仍能用,但这些差会直接变成时延和账单。

2. 斯坦福 CS329Z:工程化 AI Agent
斯坦福 CS329Z Engineering AI Agents 由 Diyi Yang、Michael Ryan、John Yang 主讲,Fall 2026,周一三 1:30–2:50,Packard 101。课从单体模型讲到复合系统再到自主代理:先手写 RAG、工具调用和 agent loop,再看 DSPy 等框架如何抽象。两次应用作业加一学期项目;课程页写作业覆盖从零做组件,以及评测与优化。指定阅读包括 Zaharia 的复合 AI 系统、Anthropic 的 Building Effective Agents,以及 MCP 规范。这是工程课,不是再讲一遍提示词。
Opinions/Thoughts
1. FrontierHarness:同样任务费用可差十倍
Runta 的 FrontierHarness v1.0 用同一模型 Kimi K3、同一任务和冷启动检查点,测 9 个 harness 的 12 种配置,共 360 次。通过率 50.0%–66.7%,只差 17 分;每次成功的中位费用却从 1.05 美元到 18.34 美元。Codex 通过率 66.7%、每次 3.47 美元;Claude Code 与 DSH Creator 都是 63.3%,但 Claude Code 每次 18.34 美元,约贵 5.6 倍。Exo 最便宜(1.05 美元、53.3%),DSH Minimal 最快(中位 5 分 41 秒)。全场通过率 58.1%。Claude Code 的 token 加权缓存命中仅 25.0%,被少数超大失败单元拉歪;作者认为这更像 harness 与 K3 隐式缓存不匹配,而不是 Claude Code 日常表现。结论:会做对和会做便宜是两件事,模型榜看不出账单。

来源:Introducing FrontierHarness Eval — RUNTA
2. 字节 HarnessDev 改为给 harness 打分
elvis 推荐字节 Seed 的自进化 agent harness 论文。方法名 HarnessDev:不再按模型完成了哪些任务打分,而按它造出的 harness 打分。代理从某个起点开始(后续被截断)。配套信息是:把评测对象从“这一题对不对”改成“它给自己搭的脚手架好不好”,这和今日多份 harness 评测是同一条线。

来源:@omarsar0