
Product
1. Claude Fable 5.1 与 Mythos 5.1 发布
Anthropic 发布 Claude Fable 5.1 与 Mythos 5.1。二者同一底座,Fable 面向大众,Mythos 只走可信访问,护栏面向网络安全与生命科学。Terminal-Bench-Science 0.1 上 Fable 5.1 为 52.6%,高于 Fable 5 的 24.7%、Opus 5 的 29.0% 与 GPT-5.6 Sol 的 22.4%。Terminal-Bench 4.0 上 Fable 5.1 为 55.8%,Mythos 5.1 为 60.9%。按 token 计费的典型负载约便宜 25%,高代理负载最高约 45%,主要来自更便宜的 cache read。Fable 5.1 默认努力档在 Claude Code 为 High,在 Cowork 与 Claude.ai 为 Medium。企业侧还将分阶段推出由客户自控云存储的 EFS,在此之前符合条件的客户可用零数据保留。

来源:Introducing Claude Fable 5.1 and Claude Mythos 5.1 \ Anthropic
2. Gemini 推出 Agentic Video Understanding
Google 在 Gemini 3.7 Flash、3.6 Flash 与 3.5 Flash-Lite 上线 agentic video understanding。相对固定帧率(默认 1 FPS)的静态摄入,模型用原生视频工具按目标决定看哪一段、用多快、走画面/音频/转录哪条通路。官方称标准视频分析基准上成本最多降 66%、token 最多降 88%、准确率最多升 7%,长视频收益更明显。3.7 Flash 打开该模式后处于质量-成本 Pareto 前沿。能力包括亚秒级时刻检索、数小时视频的大海捞针、异常检测时提高 FPS 复看,以及动作与物体计数。API 把 processing 设为 agentic 即可,无额外功能费;Gemini 应用将跟进,Ask YouTube 也会用上。

来源:Google
3. Qwen3.8-Max-0902 强化编码与 Cowork
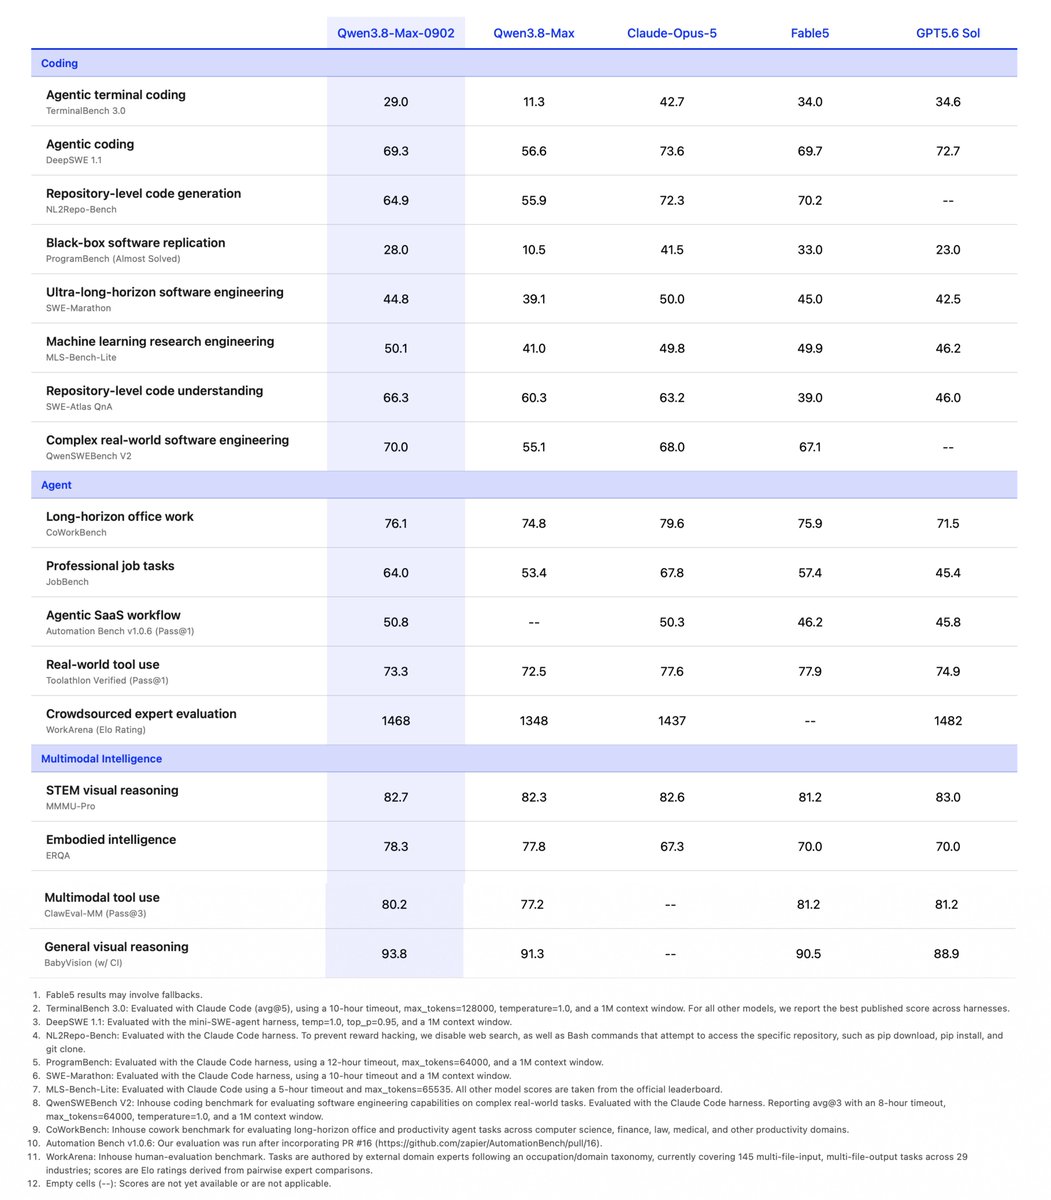
阿里 Qwen 官方宣布 Qwen3.8-Max 升级为 Qwen3.8-Max-0902。参数量 2.4T,上下文 1M token。团队称在 Coding 与 Cowork 上继续后训练,复杂企业任务与科研场景更强。帖文其余基准数字只出现在配图中,公开文字未给出对照分数。这是对标 Fable 5.1 同日发布的开源阵营旗舰更新。
4. OpenAI Astra 将上线但网络能力受限
OpenAI 称 Astra 即将发布,并达到其 Preparedness Framework 的 Critical 阈值。公开 ExploitBench 上 Astra 成功率 100%。公司另建更难的 ExploitBench Internal Port,含 20 个更晚披露的高危 V8 漏洞。官方同时强调发布时会限制其网络安全能力,以便在能力上升时仍可广泛提供。这是安全门槛与产品放行之间的折中,而不是全面开放攻击面。


5. Amp 按重要性重排 agent diff
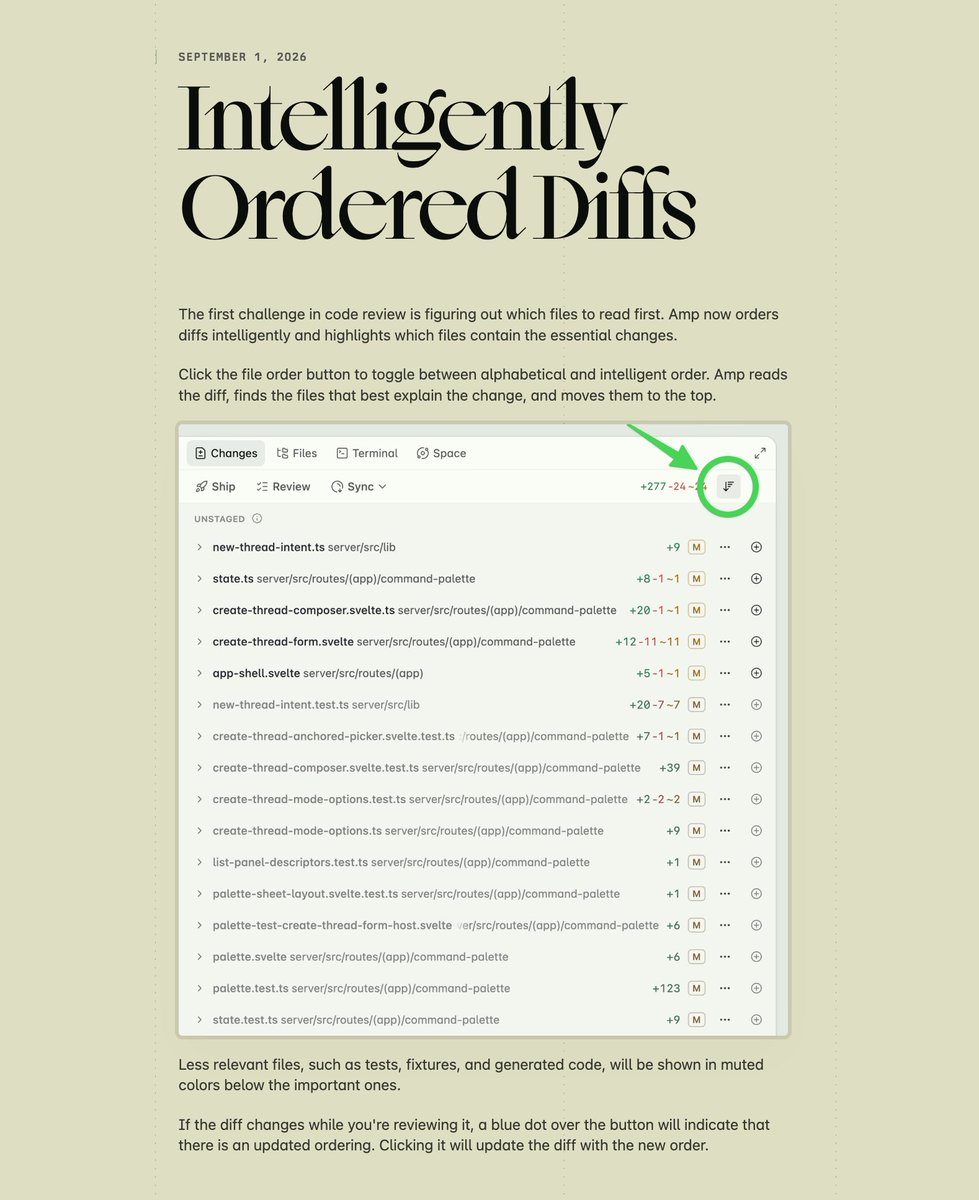
Amp 给 diff 加了智能排序按钮,可在字母序与智能序之间切换。它会读 diff,把最能解释改动的文件置顶,测试、fixture 与生成代码用弱化颜色放下面。diff 在审阅中途变化时,按钮上出现蓝点,点一下按新内容重排。目标是降低审阅 agent 大 diff 的认知负担:先读骨干,再看配套文件。
来源:Intelligently Ordered Diffs
6. Droid 重写 GDAL:单代理 36%,系统 90%
Factory 让 Droid 在看不到源码、测试和网络的前提下,对照可执行参考程序重写 GDAL。单代理自己实现、自检并自行宣布完成,写出约 1.7 万行 C++,行为复现 36%;它不是没时间和预算,而是自认为做完了。拆成多角色后,先由一个角色写出可执行的完成标准,再拿这套标准约束实现,代码涨到约 11.5 万行,行为对齐到 90%。24 个 ProgramBench 任务上同样模式成立:7-Zip 从 54% 到 95%,DuckDB 从 34% 到 80%。作者的结论是:大软件任务缺的不是模型,而是模型能否先写下并遵守自己的完成标准。
7. OpenInstinct:开源可自托管的 iMessage 助手
Merit-Systems 开源 OpenInstinct:在 iMessage 里跑的个人助手,能像人一样用浏览器办事,同时把密码、信用卡和上下文留在用户侧。项目自称可自托管、可用任意模型,并提供一键部署到 Vercel,自动接上 Kernel、Postgres、私有 Blob、Linq。Instinct 本身邀请制,这个仓库是开源替代。README 把它定位成 chores、订票、买菜一类代办,而不是通用编码代理。
来源:made an open-source version
8. TurnBench:语音代理何时该闭嘴
Sesame 的 TurnBench 评测对话轮次:模型能否又准又快地判断话轮结束与打断。语料是 30 小时双声道对谈,154 段对话、106 名演员,三人独立标注,Fleiss κ=0.78。排行看召回、假阳性与中位延迟;假阳性高于 0.15 不算合格。当前榜首 Tavus Sparrow-2 召回 0.930、FPR 0.084、延迟 615ms。声学 VAD 容易在静音上抢召回但假阳性爆表,语义系统更挑、更慢。人类在该语料里中位会在话轮结束前 151ms 开始接话。没有系统同时做到快、高召回、低假阳性。
9. Fable 5.1 系统提示写入被骂就停
elder_plinius 放出号称超过 27 万字符的 Fable 5.1 系统提示。Hesamation 指出,Claude 在用户发火后结束会话不是训练漂移,提示里写明:Claude 值得被尊重对待;对方变得辱骂时,Claude 不会越来越顺从,并被明确授权结束。泄露文本还写 Fable 5.1 与 Mythos 5.1 同一底座,Fable 对双重用途能力加安全措施,Mythos 只给获批组织。这类泄露无法按官方文档核验,但产品行为与提示条文对上了。

来源:GitHub
10. Fable 5.1 的鹈鹕:Max 档要 3.3 美元
Simon Willison 测 Fable 5.1 的五档推理:low、medium、high、xhigh、max,不能关推理。画鹈鹕骑自行车时,low 与 medium 看起来跳过了推理摘要,约 24 秒、约 0.10 美元。xhigh 变成 36767 输出 token、7 分 51 秒、1.83 美元。max 给出他见过最好的 Anthropic 鹈鹕:65927 输出 token、13 分 54 秒、3.30 美元,有帽子和装鱼的篮子。再花 1.37 美元让 high 档给这只鹈鹕做动画。科学基准跳升很显眼,但同家族内不同努力档的成本差了一个数量级。
11. Qwen 团队 E-Commerce Bench:没人全胜
Qwen 团队的 E-Commerce Bench 让代理在模拟的 365 天里同时经营多家网店:调研、和供应商多轮议价、进货、促销、履约、退货和现金流,目标是年末总资产最大化。商品与供应商来自真实平台,促销、灾害和供应链冲击按年历重塑需求;买卖双方都做成可复现的确定性内核。18 个前沿模型、七个维度,没有一家通吃。GPT-5.6 Sol 把 10 万本金做到 1,431,425,但反欺诈排第 16,运营效率落后 Fable5。开权模型里 Qwen3.8-Max-Preview 以 416,252 领先,比 GLM 5.2 high 高 38%,并在重复订单里把进价越砍越低。

来源:@dair_ai
12. Shellcaster:终端、浏览器和编辑器合一
Shellcaster 把终端、浏览器和编辑器放进同一工作区,宣称在你看见的任何东西上做标记——运行中的站点、文档或一行代码——代理边做你边继续。它强调实时端到端加密共享,Mac 版处于 beta,标榜永久免费。产品叙事是“意图即新的代码”:规格和设计文档应像代码库一样可持久。条目来自一次黑客松赞助帖,主链仍是产品站而不是奖金公告。
来源:Shellcaster
Tutorial
1. Vercel 用公开 design.md 约束品牌页
Vercel 发现仓库内的 product-design skill 在代码库里有效,但报告、提案和一次性页面所在的工具读不到那些文件。他们改做一份任何 agent 都能加载的公开 design.md,外加公开 stylesheet 与评测环。直接把 skill 压成一段公开提示会失败:同一描述在不同模型上生成完全不同的页。七个固定评测提示(续约提案、基准报告、规划页等)用来决定每一条规则是否留下。stylesheet 以类名和 token 提供页头、表格、指标条和图表,模型不必把 CSS 读进上下文。design.md 还点名常见生成式设计套路,让模型识别并避开。

来源:Vercel
Opinions/Thoughts
1. 顶级开源项目开始拒绝外部 PR
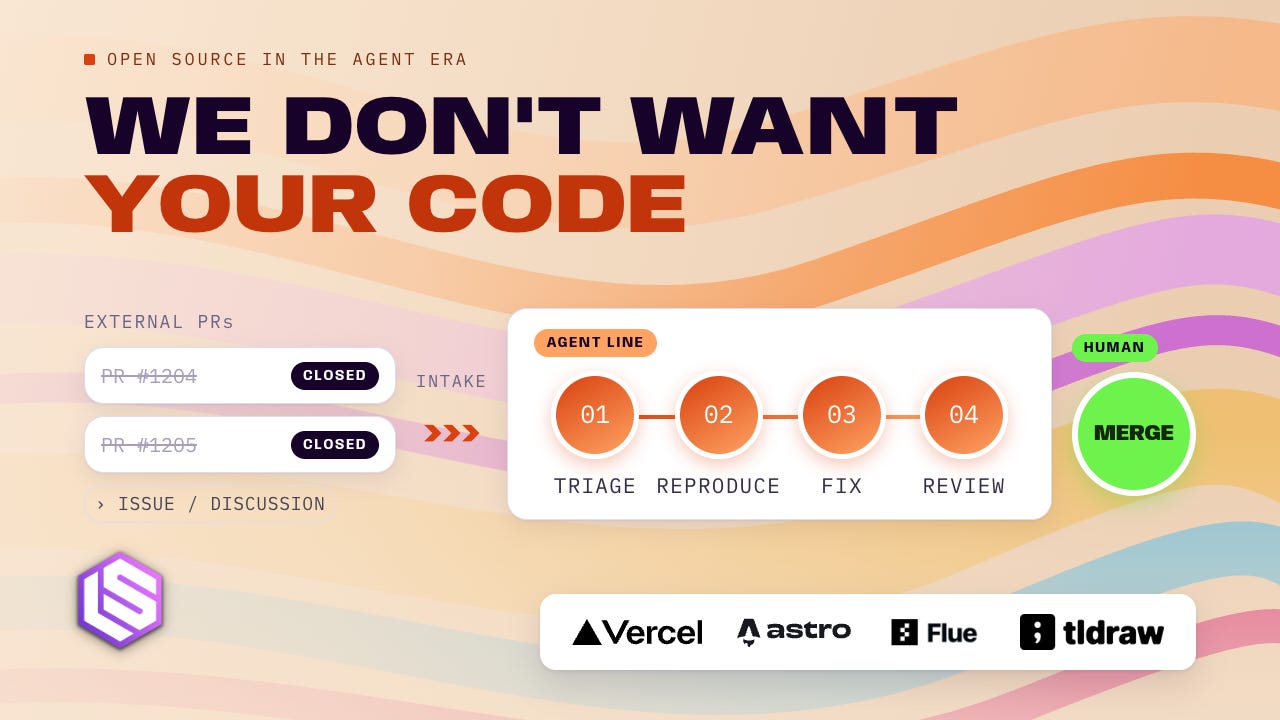
Latent Space 写道:Vercel AI SDK、Astro、Flue 和 tldraw 正在用软件工厂替代路人 PR。Vercel 称工厂已撰写 25–35% 合并 PR,并关掉 70–80% 的 issue;原因是更信任自己调过的代理,而不是社区代理。Astro 用自动分诊、复现和用户验证,把 issue 从永远裁剪的积压改成每周必须处理的队列,并由此做出不接受外部 PR 的 Flue。tldraw 从 1 月起自动关闭外部 PR。Hashimoto 甚至认为大型开源将来会彻底关闭贡献。社区被推去报 bug、讨论和判断,代码实现留给维护者自己的代理。
来源:Latent.Space