
Product
1. 本周 AI 论文:Skill、Harness、安全
DAIR.AI 汇总 8 月 24–30 日论文。NVIDIA 的 Skill Lift 发现结构扫描分与技能真实质量几乎无关(ρ=0.14),要用加载/不加载的成对实验量 delta。JIT-Agent 按任务生成 harness,称 DeepSeek-V4-Flash 在 DeepSearchQA 上超过 GPT-5.6。Prime Agent 开源 REPL 与跨 run Continual Harness,ARC-AGI-3 Best@1 从 30% 提到 95.5%。多次 compaction 后安全规则只剩约 10%。EvoMal 显示共享技能库会自我传播恶意技能。数字来自综述转述,原文设定未在此核验。
2. Google WikiSkill:经验先写成 Wiki
meng shao 介绍 Google Research 的 WikiSkill:在原始经验与可执行 Skills 之间插入持久知识层 Wiki,让经验被持续编译成结构化知识,再支撑 Skills 进化。Akshay 的原帖把 Agent skills 说成「任务指令文件夹」,并指出人们越来越让 agent 自己写这些指令。WikiSkill 的主张是:只让模型改 skill 文件不够,要先沉淀可复用知识。论文指标、开源与否、和 Anthropic skill 目录如何对接,这条帖文都没给。它要解决的是 skill 自动进化,而不是又一份提示词模板。

来源:@shao__meng
3. 微软:标准 SFT 不适合接 RL
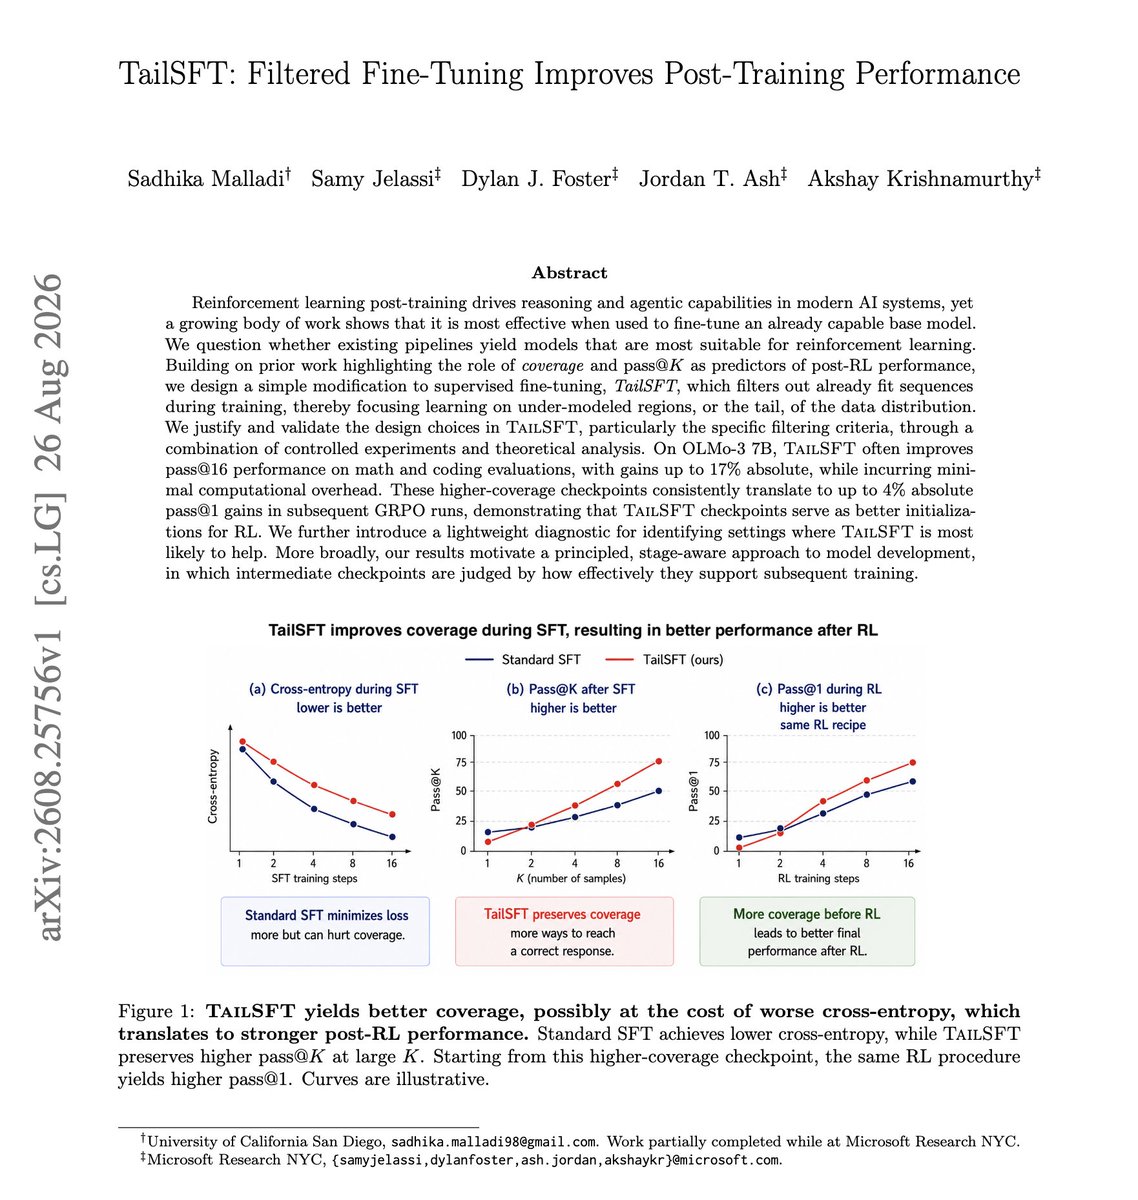
DAIR.AI 转述微软研究:常规 SFT 流水线并不会产出你真正想拿去跑 RL 的模型。帖文说标准 SFT 会保留某些东西,但句子在此被截断,没有点名方法名、数据集或提升幅度。能确定的只有结论方向:SFT 不是中性的热身,它会塑造后续 RL 的起点。若你把 SFT 当「先教行为再强化学习」的默认步骤,这条要求你重新检查 SFT 目标与 RL 目标是否一致。具体改法要以论文为准,这里不能外推。
来源:@dair_ai
4. Stanford:长推理不要全量注意力
elvis 推荐一篇 Stanford 关于高效 test-time scaling 的论文,面向会想很久的 agent。核心观察:长推理用全量注意力把整条 trace 留在内存里,于是最难、最需要长思考的问题反而最贵。帖文在展开处被截断,没有给出方法名、替代注意力形式或基准数字。对跑长 horizon agent 的人,这是在问:推理时间加长时,成本是不是被「记住全部思路」拖死。具体算法要以论文为准,不能从推荐语发明架构。

来源:@omarsar0
5. Archify:代码库变成可验证系统图
AIGCLINK 介绍 Archify:把代码库或系统描述变成可交互、可验证、可对比变更的系统图,输出单文件 HTML。渲染是确定性的,同一输入得到同一张图,避免模型每次画得不一样。GitHub 说明它走 typed JSON IR,再编译成 HTML/SVG,服务 Cursor、Claude Code、Codex CLI、OpenCode。图类型包括架构、工作流、序列、数据流和生命周期,并支持 Before/Delta/After 对比。当前稳定版写的是 v2.16.0。它解决的是 agent 画图不可复现,不是又一个 Chat-to-Mermaid。图是否真能追溯到 revision-verified 源码,要以仓库为准。
来源:GitHub
6. Vercel:MiniMax H3 视频五折
Vercel 与 MiniMax 合作,8 月 30 日至 9 月 13 日在 AI Gateway 上对 MiniMax H3 与 H3 Max 五折。折扣覆盖所有时长和画幅,模型 ID 不变,已有请求会自动走新价格。H3 可从文本、首图、首尾帧或参考图/视频/音频生成 2K 视频;H3 Max 用 480p/768p 换速度。生成按后台任务轮询,因为渲染要数分钟。这是分发和价格,不是新能力发布。折后单价、并发上限和内容安全策略,changelog 未展开。
来源:Vercel
7. 浏览器里 LoRA:小模型驱动游戏角色
David Oxley 实验:完全在浏览器里跑小语言模型,能否真正影响游戏角色。路径包括生成行为克隆数据、做实验性 WebGPU LoRA 训练器,并训练了 SmolLM2。帖文在模型名后被截断,没有写效果是否「有意义」、帧率和参数量。它要测的是端侧小模型能不能进入交互循环,而不只是聊天。这是研究原型,不是可玩产品。WebGPU 训练是否稳定、权重是否留在本地,原文未给结论。
来源:@dpoxley
Tutorial
1. Simon 拆 ChatGPT Work 的真实能力
Simon Willison 把 ChatGPT Work 拆成云端 Work Cloud,以及能碰本地文件的 Work Local(前身是 Codex 桌面应用)。本文只写 Cloud:限 $20/月及以上。相对 Chat,它有 Luna/Terra、带联网的代码执行、无头 Chrome、跨会话文件系统、ChatGPT Sites 和子 agent,并按 Codex 额度计费。默认出网几乎开放;浏览器可让你本地输入密码和 2FA。Sites 跑在 Cloudflare Workers,默认可私有。Chat 的 5.6 Pro 在 Work 里没有对应档。官方「Chat 回答、Work 交付」的划分,他觉得几乎没用。

2. KV 缓存为什么不存 Q
Avi Chawla 的长文把 LLM 里四层「缓存」拆开:KV cache 存单次请求的注意力张量;Prefix caching 按 token ID 哈希链在服务端复用同一张量;Prompt caching 是云厂商按量计费的同一查找;Semantic cache 按向量相似度存整段回答。前三者是精确匹配、不改正确性;第四者是模糊匹配,可能用 200 返回错误答案。Q 不进 KV cache,是因为因果掩码下 query 只用一次,而 K/V 会被后续所有 token 读取。Decode 因此从计算密集变成吃显存带宽。文中还提醒 transformers v5 的 cache API 已变。这是服务成本问题,不是面试俏皮话。
来源:KV, Prefix, Prompt and Semantic Caching in LLMs, clearly explained
3. Raschka:从 LLM 讲到 uv 装 PyTorch
Sebastian Raschka 发了一段视频,三件事绑在一起:常规 LLM 与推理模型、agent 的关系;对 from-scratch 路线的看法;以及用 uv 安装 Python 和 PyTorch 依赖。这是教学,不是新论文。它把「模型形态」和「工程启动」放进同一条入门路径,避免新手先卡在环境。视频细节无法从文字还原。适合当成从零补推理模型和本地环境的入口,而不是能力评测。
来源:@rasbt
4. AI 芯片:算力已不是第一瓶颈
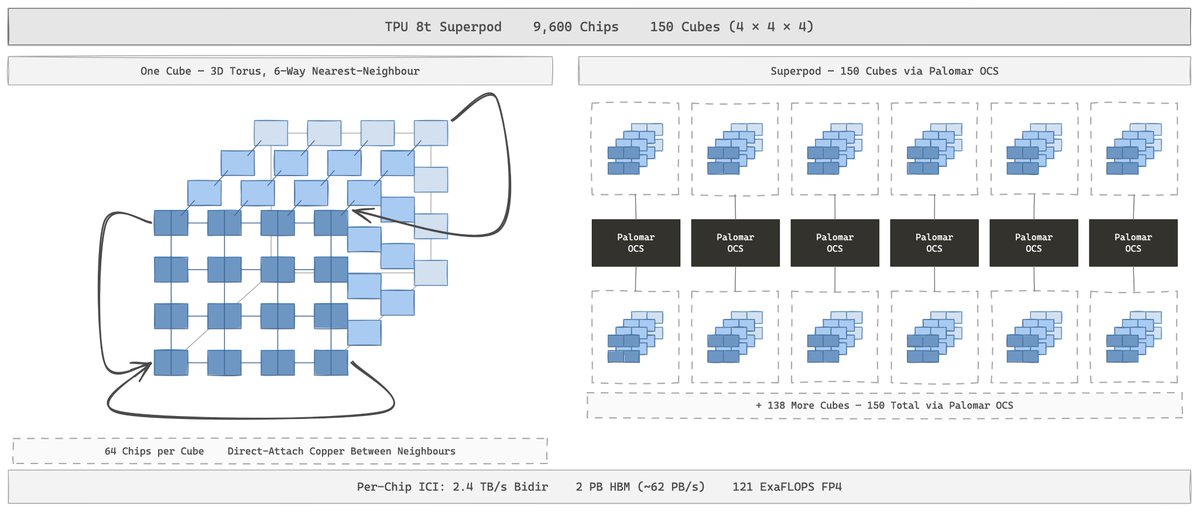
Gorden Sun 推荐一篇梳理各家 AI 芯片架构与历史的长文。他的摘要只有一层:大模型在狂做矩阵乘,算力增长快过内存搬运,数据搬移成了最大瓶颈;NVIDIA 被点名为第一种思路的代表。帖文在厂商名后被截断,没有转述其他厂家的具体方案,不能补。对要读芯片的人,这是一张「先看带宽再看 FLOPs」的地图。原文是否覆盖训练与推理、是否包含国产芯片,这条里看不到。
来源:@Gorden_Sun
5. Ponytail:压住 GPT-5.6 Sol 的过度设计
Bilal Bakr 称 GPT-5.6 Sol 是日常主力,但爱过度设计和写太多代码。修复三步:安装 DietrichGebert/ponytail skill、接到 Codex、再给 Sol 一段约束提示。帖文在提示词处被截断,不能复述完整指令。能确定的是:模型能力越强,越需要一条「少写」的 skill,而不是更多工具。这是个人配置,不是官方补丁。对把 Sol 当默认编码模型的人,这是一条可试的约束层。效果没有对照实验。

来源:@bil0090
6. 用数字逐步算完 Attention 的 QKV
Pallavi 转 Amit Shekhar 的教程:用逐步数字例子把 Scaled Dot-Product Attention 算完,覆盖从词到向量、构造 Q/K/V、QK^T、缩放、softmax,再到加权 V。公式是 Attention(Q,K,V)=softmax(QK^T/√d_k)V。文章日期写的是 2026 年 4 月 3 日,不是新研究,是把面试题写成可手算的过程。它解释的是机制,不是 KV cache 的系统层。对需要补基础的人有用;对已经在跑 serving 的人,价值低于 Avi 的缓存长文。
来源:Outcome School | Get a High-Paying Tech Job
Opinions/Thoughts
1. Tara Seshan:工作从划船变成掌舵
Lenny 这期是 OpenAI Codex 与 ChatGPT Work 产品负责人 Tara Seshan 的访谈节目单,不是逐字稿。公开要点:执行交给 agent 后,人类判断和野心成为差异化;OpenAI 按未来两三个月的模型能力做产品;内部梗包括 “Is this maximally accelerated?”。她认为公司的新瓶颈是野心,PM 的工作变成抬高别人的野心。文末写 My biggest takeaways 后即付费墙。不能把节目单当成她在录音里的原话。和 ChatGPT Work 拆解是同一产品线的两边:一边讲能力,一边讲组织。