
Product
1. OpenAI 审计 SWE-Bench Pro:30% 任务失效,撤回使用建议
OpenAI 表示其对被广泛使用的 AI 编程基准 SWE-Bench Pro 进行了审计,发现其中约 30% 的任务存在问题、已无法可靠衡量前沿编程能力。据此 OpenAI 撤回了此前“建议研究社区将其作为主要编程评测”的推荐。这一结论对整个编程模型排行榜的可信度构成冲击,意味着部分现有分数可能建立在失效任务之上。它也折射出“模型变强 → 评测必须更难、更公平”的行业共识。OpenAI 同时强调需要更可信的基准来判断真实进展与前沿位置。
来源:@OpenAI
2. OpenAI 披露 SWE-Bench Pro 审计方法:Agent + 资深工程师
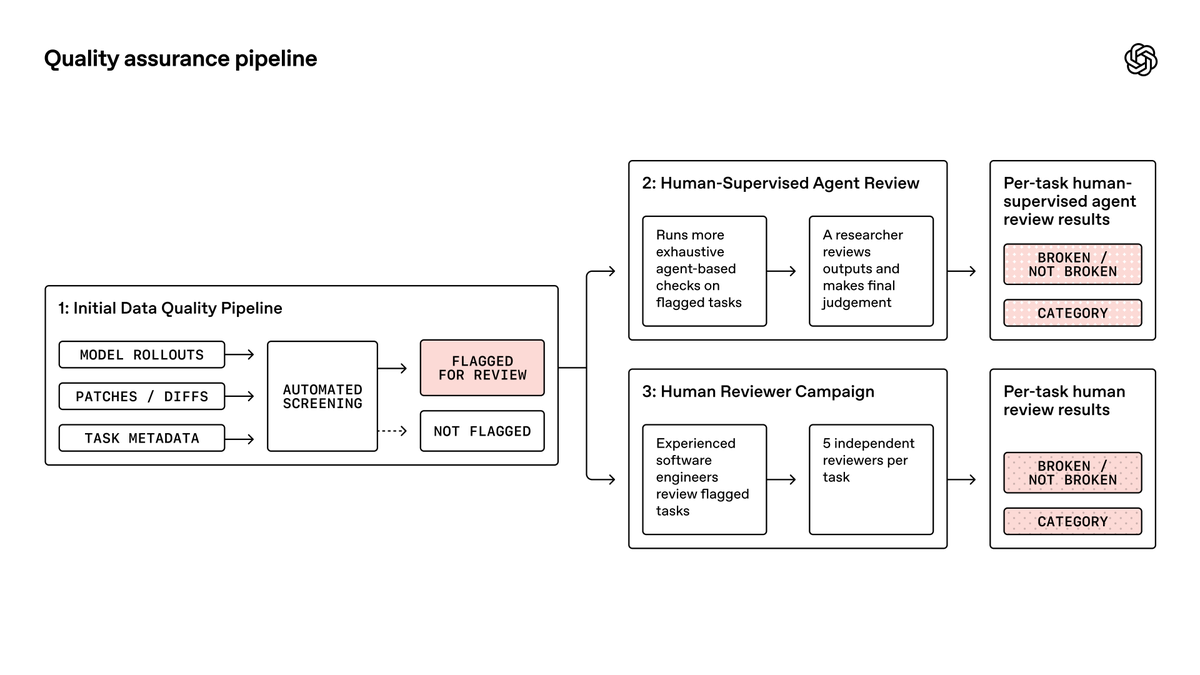
作为上述审计的方法补充,OpenAI 说明其同时使用了基于模型的“调查 Agent”与五位独立资深软件工程师的人工复核。这种“规模化机器审查 + 专家判断居中”的组合,意在既覆盖大量任务、又保留人类专家的把关。它也示范了一种在大规模评测审计中把 AI 与人审结合的可行范式。该方法论本身对其他希望自审基准的团队具有参考价值。
来源:@OpenAI
3. Anthropic 研究:为模型的双用途知识装上“开关”
Anthropic 发布与 AE Studio 合作的研究,探索对模型中“双用途知识”(dual use knowledge)的访问控制。这类知识既能用于修补漏洞、研发疫苗,也可被滥用于攻击或制造病原体。研究试图同时兼顾三个目标:尽可能外科手术式地限制危险访问、允许可信用户为正当用途调用同等能力、且不影响模型在其它任务上的表现。当前的拒答与分类器等防护层并不改变模型底层“知道什么”,面对越狱仍可能失守。该方向追求更本质的“控制模型所知”,是 Alignment 路线在能力治理上的具体推进。
来源:An off switch for dual use knowledge in AI models
4. Claude Code 2.1.205:阻止篡改会话记录等多项修复
Claude Code CLI 发布 2.1.205 版本。新功能方面,增加了一条 auto mode 规则,用于阻止对会话记录文件(session transcript)的篡改,以保护对话完整性。修复项包括:修正 —json-schema 在 schema 非法时静默产出非结构化输出、修正消息在 —max-turns 边界处被静默丢失等问题。另有 auto mode 在执行 rm -rf 遇到未解析变量时会先提示,降低误删风险。这些更新集中在“可靠性 + 防止静默失败”,是 Agent 工具链成熟化的典型方向。
来源:GitHub
5. 论文 NapMem:把记忆重构为 Agent 主动导航的动作空间
arXiv 新论文《From Passive Retrieval to Active Memory Navigation》提出 NapMem,把长期记忆从“被动检索”重构为 Agent 主动导航的结构化动作空间。多数记忆系统仍把检索器选中的证据直接喂给模型,模型只是被动消费者;NapMem 将用户历史组织成多粒度的金字塔(原始对话、类型化记忆记录等),由学习到的策略决定在合适粒度上调用记忆。其核心主张是:让 Agent 自己决定“用什么粒度的记忆、何时用”,而非接受预选证据。这对长程 Agent 的上下文治理有直接借鉴意义。

来源:arXiv.org
6. Glean 推出 AI Gateway:企业 AI 的统一控制面
Glean 发布 AI Gateway,定位为企业众多“AI 前门”(coding 助手、Agent、自建应用、各路模型)之下的统一控制面。企业如今并存多套 AI 入口且组合快速变化,Gateway 试图在三件事上收口:谁能访问 AI、AI 被允许做什么、以及成本如何。员工可继续使用偏好的工具(如 Claude Code、Codex、Cursor 或 Glean),而 IT 在底层统一设规则。其价值主张是用一个策略层把治理、权限与计费从碎片化工具中抽象出来。这反映企业 AI 治理正从“选一个模型”转向“管一整片入口”。
来源:Glean AI Gateway: One control plane beneath every AI front door
7. Google 开源 agents-cli:把编码助手变成 Agent 构建专家
Google 开源 agents-cli,一套 CLI 与 skills,旨在把任意编码助手变成在 Google Cloud(Gemini Enterprise Agent Platform)上构建、评估、部署 AI Agent 的专家。它呼应了 Karpathy 所定义的“Agentic Engineering”——把生产级 Agent 工程从 vibe coding 中区分出来所需的规格设计、评测闭环与安全监督等核心技能。其卖点在于把模型提供方、检索层、评测系统、部署目标与可观测性这些原本分散在各仪表盘的能力整合到一处。本质是为“以编码助手为中心”的 Agent 工程补上后端脚手架。
来源:GitHub
8. Vercel Labs 推出 Native SDK:用标记 + Zig 构建桌面应用
Vercel Labs 发布 Native SDK,一套构建原生桌面应用的工具包,主张“富有表现力的 UI”与“原生性能”不应互斥。其特性包括热重载、基于“标记 + Zig”的编写方式、即时启动、跨 macOS/Windows/Linux,以及从零自研的 GPU 引擎,内置设计系统与主题、自定义组件与设计 token。定位上对标 Web 运行系的开发体验,但试图去掉沉重的运行时开销。它延续了当前“用类 Web 作者体验写原生应用”的工具趋势。

来源:GitHub
9. Operon:把 Obsidian 里散落的任务收拢成结构化系统
Operon 是一款 Obsidian 任务管理插件,面向“人与 Agent”双重使用者,把散落在日记、项目笔记、清单中的任务收拢为一个仍以 Markdown 存放的任务系统。它为任务赋予结构化元数据、持久身份、可复用视图、规划面板、循环与时间追踪等能力,同时保持 Obsidian“任务贴近笔记”的本地优先特质。其要解决的问题是:Obsidian 虽把工作贴近笔记,但任务极易碎片化、难统一管理。考虑到 Agent 也开始参与任务执行,这类“人机共用的结构化任务层”正变得必要。

来源:GitHub
10. Superset Desktop 转向 local-first,修掉一类稳定性 bug
Superset(定位为“AI Agent 时代的代码编辑器”,可并行跑 Claude Code、Codex 等)发布新版本,把 v2 架构从“混合云优先”改回 local-first。官方称此举可消除一批恼人的稳定性问题,如创建/删除工作区失败、侧栏进入异常状态等。后续版本将随本地优先化带来明显的性能与响应提升。开发者坦言 v2 此前“过于实验性”,此次是回归更稳健的技术路线。这反映多 Agent 编辑器在快速迭代后普遍经历的“向稳定性回调”。
来源:GitHub
11. Nameplate:给 fleet 里每台 Mac 一个一眼可辨的身份
Nameplate 是一款给机器(macOS/Windows/Linux)打上“不可错认身份”的工具,通过彩色边框、名牌、水印、连接闪屏等点击穿透的覆盖层实现,且不影响壁纸、不被全屏应用遮挡。它的典型场景是远程登录时不再搞错“刚登进了哪台机器”。值得注意的用法是:Agent 可借助 Nameplate 在“需要用户输入”时提供额外上下文。本质上它是多机 / Agent 运维中廉价但实用的“身份可视化”层。

来源:Nameplate
Opinions/Thoughts
1. Bun 用 Rust 重写:若走 API 约花 16.5 万美元 token
Bun 已从 Zig 用 Rust 重写,并披露若改由 API 调用完成,token 成本约为 16.5 万美元。重写过程中使用了预发布版 Claude Fable 5;而 Bun 团队已于 2025 年 12 月加入 Anthropic。这组事实共同传递出一个强烈信号:在足够可测可验证的项目上,大规模重写正变得“又好又快又便宜”。当然,多数应用没有 Bun 那样的可测性,但模型仍在快速补齐这部分差距。它实质动摇了“重写注定昂贵危险”的传统工程信条。
