
Product
1. Gemini API Managed Agents大升级:后台任务、远程MCP与函数调用
Google正式推出Gemini API中Managed Agents的重大更新,支持后台异步任务执行、远程MCP服务器集成、自定义函数调用以及网络凭证刷新。开发者不再需要保持HTTP长连接,只需传递background:true参数即可异步运行交互,API立即返回ID供客户端轮询。Managed Agents还可以直接连接私有数据库或内部API的远程MCP服务器,无需编写自定义代理中间件。函数调用方面实现了步骤匹配——内置工具在服务器端自动执行,自定义函数则转入requires_action状态让客户端处理本地业务逻辑。凭证刷新机制允许通过传递现有environment_id和新的网络配置来替换过期令牌,同时保持沙箱的文件系统、已安装包和克隆仓库状态不变。这些更新本质上是将Managed Agents从同步请求变成了真正的异步worker,满足生产环境对可靠性和持久化的需求。
来源:Expanding Managed Agents in Gemini API: background tasks, remote MCP and more
2. Vercel发布Eve框架:用单个文件夹构建AI Agent
Guillermo Rauch正式发布Eve框架,定位为’面向Agent的Next.js’。核心设计理念是agent/即一个目录——一个instructions.md文件就能定义一个完整的Agent。可选的agent.ts用于配置模型和运行时,skills/目录存放标记为只在相关时加载的Markdown技能。框架支持插件化生态系统,用户只需在tools/github.ts中导出createGithubTools()即可赋予Agent GitHub能力。Eve的架构强调可插拔模型、技能、渠道和工具,所有构建模块均为可选,随着Agent成长逐步添加。这种’一个目录就是一个Agent’的设计哲学大幅降低了构建持久化Agent的门槛,让开发者无需处理底层基础设施即可专注于Agent的行为逻辑。
来源:eve
3. 腾讯Hy3开源模型登顶:295B参数可在本地硬件运行
Cline宣布腾讯最新开源模型Hy3在多项基准测试中达到前沿水平,该模型总参数295B,每次推理仅激活21B参数。这意味着开发者可以在本地硬件上运行这款前沿模型,无需依赖云服务。Hy3已在Cline中免费提供,模型ID为tencent/hy3:free。这一成果表明开源模型正在快速缩小与闭源模型的差距,并首次在性价比上实现了突破——本地运行的可行性将极大改变开发者对模型选择的考量。Cline同时强调其作为开源编码Agent的身份,支持CLI、VS Code和JetBrains等多种使用方式。

来源:GitHub
4. Cloudflare推出Monetization Gateway:向AI Agent按次收费
Cloudflare正式发布Monetization Gateway,让网站、数据、API接口和AI工具可以实现按次收费,而非传统的按月订阅。这项服务的核心背景是:当AI Agent成为网页主要访客时,传统广告和订阅模式失效——Agent不看广告、不办订阅,抓取内容后即离开。Cloudflare的方案基于x402开放协议,使用USDC等稳定币结算,号称一秒内到账,验证由全球330多个城市的边缘服务器就近完成。内容所有者可以为不同接口设定价格、按任务难度浮动收费,甚至只对未登录的访客设限。支付流程完全自动化:AI请求时收到付款提示和报价,自动扣款后携带凭证再次请求,验证通过即可访问。目前该功能尚处于候补名单阶段,未全量上线。这本质上是为未来的Agent网络构建支付基础设施——每个Agent将自带钱包,自主购买数据集、API调用和算力资源。

来源:小互 · AI 解读站
5. Cline团队发布J-Space交互式可视化演示:观察模型内部表征
受Anthropic J-Space论文启发,Cline团队利用Modal平台搭建了公开交互式演示,允许任何人观察小型语言模型在层和token之间的Jacobian透镜视图。演示展示了模型在不同深度层上如何逐步构建内部表征——从初始token嵌入到最终输出层的概念形成过程。J-Space论文揭示了类似全局工作区的内部结构,模型在其中保持概念后再输出。这一演示将论文中的理论概念具象化,让开发者和研究者可以直接观察模型内部正在处理的抽象表示。对于理解注意力机制、中间表征以及模型决策过程的教学和研究都有实际价值。
来源:@arafatkatze
6. Claude Cowork将登陆移动端和Web:在Web上启动任务、手机上收尾
Anthropic宣布Claude Cowork即将支持移动端和Web。核心场景:用户在桌面端给Claude分配一个任务,然后关闭笔记本电脑——Claude继续在云上执行任务,用户可以通过手机随时查看进度、调整方向,最终在手机上接收完成的工作。Beta版将在未来几周内首先面向Max计划用户开放,随后扩展到其他套餐。这一功能将Claude从一个’你在场时它工作’的工具转变为一个’你可以在任何设备上启动和管理异步任务’的平台。对于多设备工作流和远程办公场景来说是重要提升。
来源:@claudeai
7. Vercel收购Better Auth:为Agent时代构建身份认证基础
Vercel宣布收购Better Auth,这是一款开源TypeScript认证库,拥有470万+周npm下载量和850+贡献者。创始人Bereket Engida和核心团队加入Vercel继续开发。Better Auth的核心价值在Agent时代的应用:当Agent代表用户行动时,它运行在用户身份和权限下,每个服务的请求都显示为用户本人——目前没有办法限制单个Agent或子Agent的能力,也无法在不停用所有Agent的情况下单独停止一个。Better Auth团队的Agent Auth方案让每个Agent拥有自己的身份和范围化的可撤销权限,用户作为单一控制点。Vercel计划将Agent Auth整合到Vercel Connect和Eve(其Agent框架)中。Better Auth将继续保持MIT开源许可。
来源:Vercel
Tutorial
1. 用Fable 5清理3312个文件的知识库:Agent上下文质量决定一切
作者Elvis使用Fable 5清理了自己4年积累的Obsidian笔记库——3312个markdown文件中72%处于孤立状态。Fable 5诊断出的问题触目惊心:自动化地图80%错误、引导文件消耗73%的6万token预算且包含两个直接矛盾、约1.4GB死重(包括654MB旧备份)、甚至一个明文密钥。Fable 5通过两阶段清理:第一阶段消除状态漂移——生成所有53个cron任务的实时清单、将引导文件从17.6KB精简至12.4KB;第二阶段解决空间漂移——将知识层与机器层分离、合并827个文件、生成19个文件夹索引和1张主地图。每次新规则都附带机械检查器,每晚自动运行。总共消耗3100万输入token、43.8万输出token、338轮对话以及一个Fable orchestrator加14个子Agent。作者的核心洞察:上下文质量是Agent效果的上限——升级底料,每次下游运行都会变好。
来源:Elvis Sun
2. OpenRouter基准测试:图像输入detail参数优化策略指南
OpenRouter对5个模型进行了1,730道视觉推理问题的基准测试,揭示了图像输入detail参数的优化策略。核心发现:对推理模型来说,auto或high detail配合调整reasoning effort比设置low detail更有效——low detail使gpt-5.5在MMMU-Pro Vision上得分从79.0%降至65.2%(低13.8个百分点),且每问题成本反而从4.5美分升至5.1美分,因为模型需要烧更多推理token来补偿模糊图像。对非推理模型,low detail确实能节省成本和延迟,但需承担精度损失。总结:推理模型应保持high/auto detail,通过调整reasoning effort控制成本;非推理模型可根据精度容忍度适当使用low detail。报告提供了完整的逐模型表格和方法论。
3. LangChain Academy新课程:Deep Agents的Harness构建指南
LangChain Academy发布新课程’Introduction to Deep Agents’。课程核心内容:什么是Harness以及Agent为什么需要一个Harness;理解Harness的4个核心能力(工作流自动化、上下文管理、工具集成和错误恢复);动手构建Deep Agents;使用LangSmith进行追踪和部署。随着Agent系统复杂化,Harness(运行环境)的设计已经成为影响Agent性能的关键因素。Lilian Weng最近的论文也强调了’HAR-nerd’(Harness工程)对Agent能力的重要制约作用。LangChain的课程为开发者系统化地理解这一概念提供了教育入口。
来源:@LangChain
4. 如何精简Claude Code系统提示词:减少上下文膨胀的六步操作指南
Matt Pocock发布了一份详细指南,教开发者如何清理Claude Code的系统提示词中的臃肿内容。问题根源:每次向Claude发送请求时,都会附带工具定义、技能目录以及可能永远不会使用的功能系统指令——这些AI永远不用的’机械’内容占据了大量上下文,且每次请求都按token计费。指南提出了六步方案:第一步用/context命令测量当前上下文窗口各个部分的token消耗;第二步通过日志代理拦截HTTP请求,记录实际发送的内容;第三步利用ccflags禁用不需要的内置功能;第四步创建自定义启动指令替代默认的系统提示;第五步清理不再使用的技能文件;第六步验证改善效果。作者声称按照此方法操作后,每次请求可减少数万token。这份指南对于重度Claude Code用户有直接的降本效果。
来源:How To Kill The Bloat In Claude Code’s System Prompt
5. Anthropic官方推荐Fable 5编排模式:作顾问而非执行者
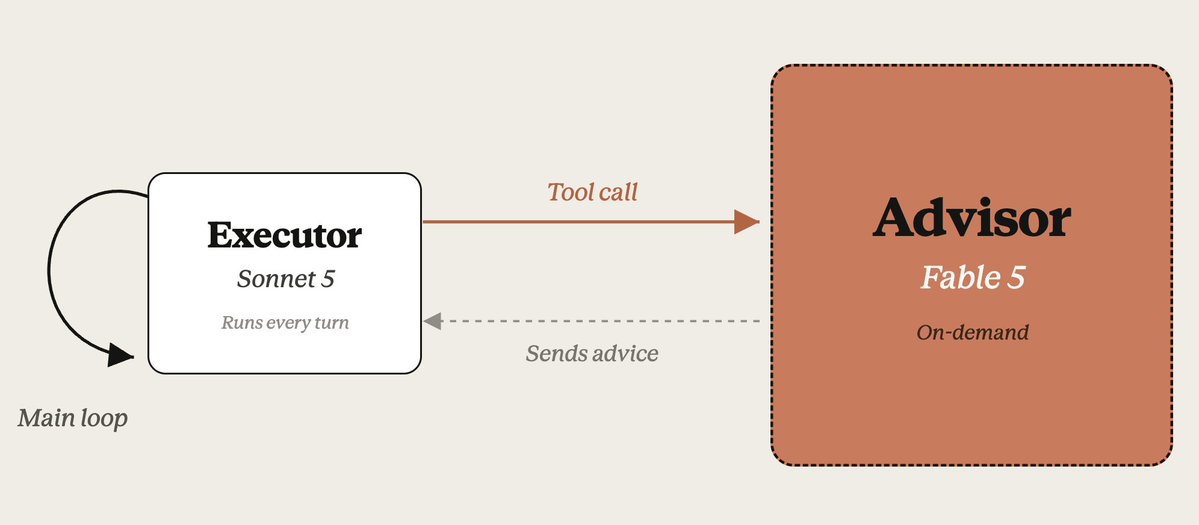
ClaudeDevs官方分享了使用Fable 5的推荐模式:将Fable 5用作顾问。具体架构为Fable 5担任规划器和决策者(Orchestrator),Sonnet 5等较低成本模型担任执行者(Executor)。执行者在需要时调用Fable 5获取指导,大部分token以较低的Executor费率计费。这种分层编排架构同时实现了高质量决策和低成本执行。Anthropic官方推广这一模式表明,即使在自家产品生态内,最优解也是用更经济的模型做日常执行、用最强模型做关键时刻的推理。此策略对企业的token预算管理具有直接的指导价值。
来源:@ClaudeDevs
Opinions/Thoughts
1. 斯坦福等机构提出LLM-as-a-Verifier:验证成为新缩放轴
来自斯坦福、NVIDIA和UC Berkeley的联合研究提出LLM-as-a-Verifier框架,将验证能力识别为继预训练、后训练和测试时计算之后的第四个缩放轴。该框架无需额外训练,通过读取评分token logits的分布期望生成连续校准分数,而非离散评分。论文展示了三个可扩展维度:评分粒度(更清晰的分离)、重复评估(降低方差)和标准分解(降低复杂度)。在多个领域取得显著成绩:Terminal-Bench V2上86.5%、SWE-Bench Verified上78.2%、RoboRewardBench上87.4%、MedAgentBench上73.3%。该连续分数还可作为SAC和GRPO的密集奖励信号,并已集成到Claude Code扩展中作为任务进度信号。这篇论文证明了验证能力可以作为独立缩放维度,对Agent系统可靠性提升具有深远的理论基础。

来源:arXiv.org
2. Lilian Weng万字长文:从Harness工程到递归自我改进的路径
Sakana AI引用Lilian Weng(Thinking Machines Lab联合创始人)的最新博客文章,系统阐述了从Harness工程到递归自我改进(RSI)的可行性路径。Weng的核心论点:直接将模型权重写入的形式化RSI短期内难以实现,而从模型运行环境——Harness的设计和优化入手才是现实起点。文章梳理了Harness设计模式(工作流自动化、文件系统持久记忆、子Agent和后台任务)、Harness优化方法(上下文工程、工作流设计、自改进Harness)以及进化搜索与模型权重联合优化。Sakana AI的三项研究——The AI Scientist(Nature 2026)、ShinkaEvolve和Darwin Gödel Machine——被作为典型案例引用。Weng同时指出了RSI面临的结构性挑战:评估困难、多样性崩塌和奖励黑客问题。这篇28分钟阅读量的文章是目前关于RSI最系统的整理。

来源:Harness Engineering for Self-Improvement
3. DeepSeek计划自研芯片:面对美国出口管制转向硬件自主
据路透社报道,中国AI公司DeepSeek已开始推进自有芯片制造计划,目标开发数据中心推理芯片——不是训练芯片。公司已为此投入约一年时间,正在接洽硬件合作伙伴并招聘工程师。该计划的核心动机是减少对Nvidia和华为的双重依赖。美国出口管制禁止Nvidia向中国销售高端GPU,而华为控制着中国约一半的数据中心芯片市场。DeepSeek不是唯一采取行动的中国公司——阿里巴巴和百度也在推进类似计划。与此同时美国AI公司也在加速自有芯片研发,OpenAI与Broadcom合作的Jalapeño芯片已宣布,Anthropic据传在与三星合作。
来源:Ars Technica