Product
1. Shepherd:让Agent拥有Git般可逆执行能力的运行时
Stanford 团队开源了 Shepherd,一个将Agent执行过程转变为可逆、类Git追踪的运行时。核心创新是使用写时复制(copy-on-write)将Agent进程和文件系统一起快照,实现比docker commit快约5倍的fork,且回放时KV缓存复用率超过95%。这意味着Agent可以在错误步骤发生后瞬间回滚到之前正确状态,避免重新运行的token浪费。在 CooperBench 上,加入实时监督器将配对编程通过率从28.8%提升至54.7%。不过并非所有操作都可逆:数据库写入需要预先设置补偿操作,而发送邮件等外部效应无法撤销。当前仍处于早期alpha阶段,但思路已经得到社区广泛关注。
来源:GitHub
2. OpenScience:模型无关的开源科学研究工作台
OpenScience 是 Claude Science 的开源替代方案,核心特点是模型无关——支持任意模型提供商API密钥,无需注册,自带250+科研技能和约30个科学数据库作为工具。它分为默认研究Agent以及生物学、物理学、ML专家Agent,外加批判和文献综述子Agent,还有一个只读计划模式。浏览器即工作台,内置文件树、编辑器、终端、会话历史以及分子/结构/基因组/图表内联渲染。安全方面需要注意:它没有沙箱隔离,需自行套容器或VM。安装极简:npx synsci 一步启动。这反映了开源社区的一个规律:闭源厂商定义垂直Agent形态后,开源社区迅速用模型无关的同构版本填补空白。


来源:GitHub
3. OpenWiki:LangChain开源的自动代码库文档Agent
LangChain 发布了 OpenWiki,一个用Agent自动维护代码库文档的命令行工具。基本原理是持续扫描代码库,将代码结构、API、模块关系整理成可读文档并保持更新。当代码变更时,Agent 观察变化并更新文档。它还提供GitHub Action 以便每日自动创建更新PR。OpenWiki 初始化时会生成 AGENTS.md 或 CLAUDE.md 文件,指导编码Agent参考这些文档。安装简单:npm install -g openwiki,之后运行 openwiki —init 即可。这个工具直接解决了开发中文档维护的痛点,对使用AI编码Agent的团队尤其有价值。
来源:GitHub
4. Agent Vault:Infisical 开源的身份凭证代理与保险库
Infisical 开源了 Agent Vault,一个HTTP凭证代理和保险库,专门用于解决AI Agent的凭证泄露问题。传统密钥管理将凭证返回给应用,但AI Agent可能被提示注入攻击泄露密钥。Agent Vault的做法是让Agent不持有任何真实凭证,而是将HTTP请求路由经过它,由它替换请求头中的占位符为真实凭证。它支持可插拔的凭证存储后端(如Infisical),并可以部署在私有网络内降低延迟。每个请求的审计日志会自动生成。该方案适用于 Claude Code、OpenClaw、Hermes 以及自定义Agent,是构建企业级安全Agent架构的基础组件。
来源:GitHub
5. MobAI 2.4.0:AI Agent 可直接驱动云端真实设备和模拟器
MobAI 2.4.0 版本支持连接 BrowserStack、Sauce Labs 和 AWS Device Farm,让AI Agent(如Claude Code、Codex、Cursor)能够直接驱动云端真机、模拟器和仿真器,就像设备插在本机上一样。这意味着移动端开发者可以让Agent自动进行跨设备测试、录制演示视频、生成测试报告,而无需手动配置本地设备集群。该工具免费提供下载,已有2000+次下载。内置Agent还可以在无需额外脚本的情况下自动探索应用流程、发现Bug并生成摘要。这是移动测试自动化的一个重要里程碑,将Agent能力直接扩展到真实的物理和模拟设备上。

来源:MobAI
6. Seedance 2.0 Skill OS:让AI像专业导演一样创作视频
Seedance 2.0 Skill OS 是一个为 Seedance 视频生成模型提供的全流程导演系统。它包含创意访谈、分镜规划、提示词生成、质量控制和交付等环节,模拟了整个电影剧组的角色。摄影师推导镜头、灯光、运镜;场记和美术指导保证连续性;导演负责分镜大纲和场景节拍;调色师设定ACES色彩意图;质检环节可以分析是灯光问题还是镜头运动问题。支持文本转视频、图像转视频、视频转视频、参考转视频、编辑、扩展、音频等工作流。本质上这是给视频生成模型装上了一套专业导演的决策引擎,提升了最终产出的质量一致性。

来源:GitHub
7. OpenRouter MCP Server:让编码工具直接获取模型信息与余额
OpenRouter 发布了官方MCP Server,允许AI编码工具(Claude Code、Codex CLI、OpenCode、Cursor等)通过MCP协议获取OpenRouter上的实时数据,包括可用模型、价格、账户余额、排行榜和文档。这是一个远程服务器,用户只需添加URL并完成OAuth登录即可。MCP Server能帮Agent在编辑器中查询模型信息、发送测试消息,而实际调用模型仍通过OpenRouter API。这简化了在开发环境中管理多个模型和余额的体验,尤其适合需要频繁切换模型配置的开发者。
Opinions/Thoughts
1. 本周顶尖AI论文速览(6月28日-7月5日)
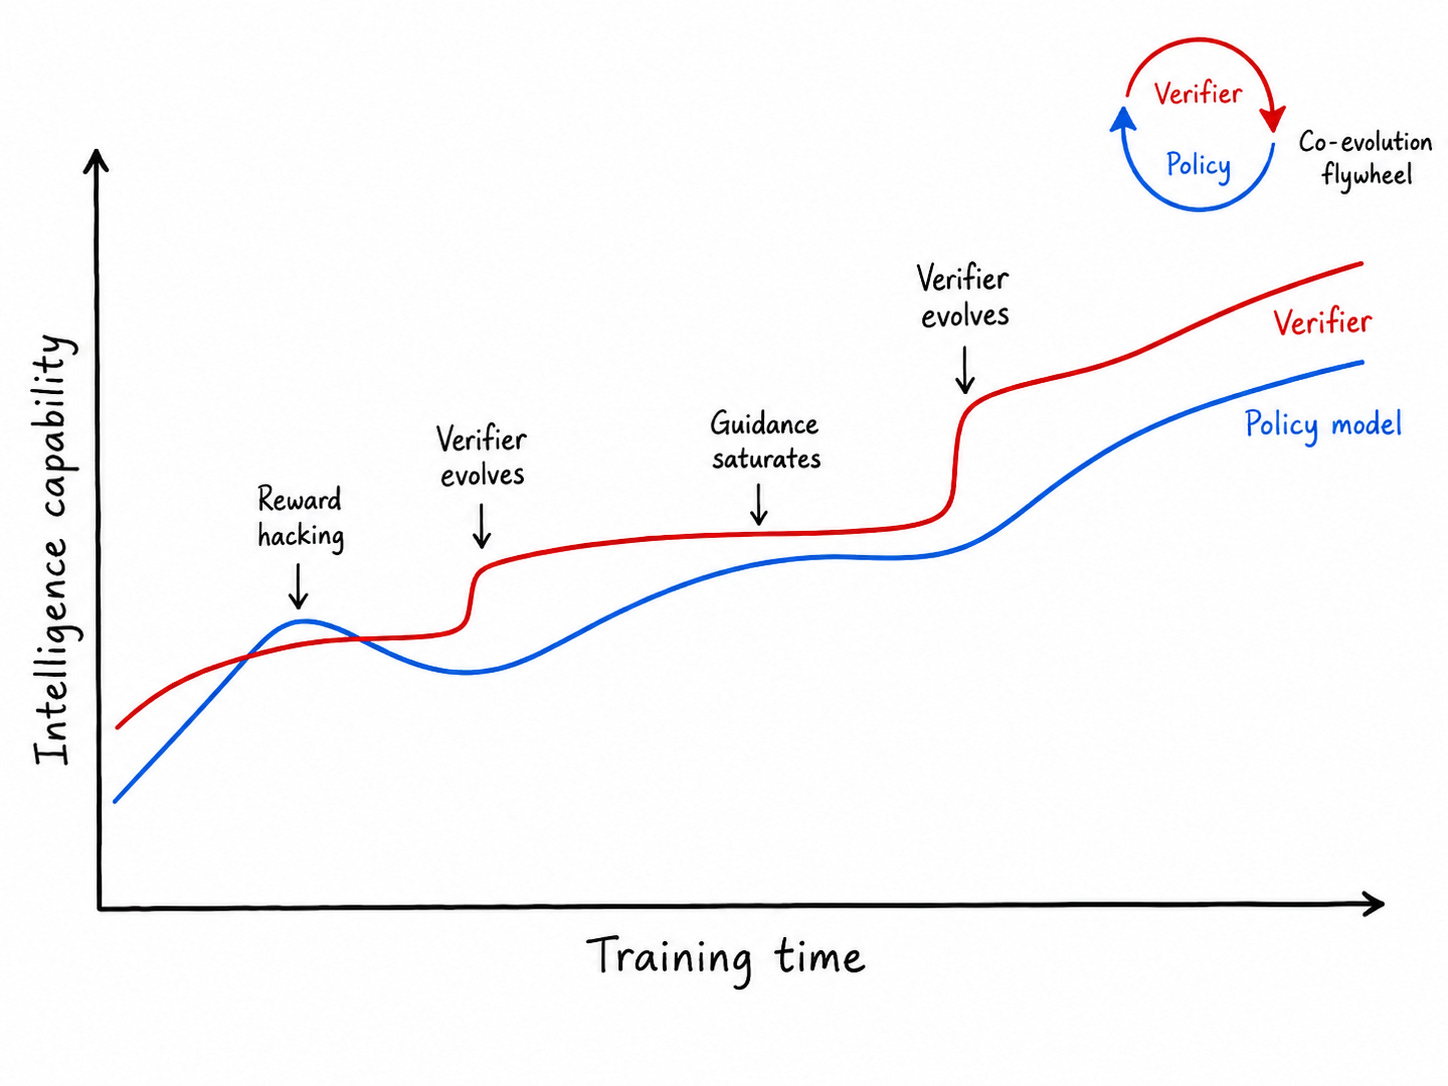
DAIR.AI 整理了本周10篇重要AI论文,涵盖多个前沿方向。RLMF 将模型的元认知能力用作训练信号实现校准;MCP Server Patterns 从实际部署中提炼出五种服务架构模式;The Verification Horizon 论证了在强化学习编码中验证必须与策略共同演化;Paper Assistant Tool 是Google用于规模化论文深度评审的Agent框架;Generative Skill Composition 将技能选择视为生成问题而非检索;AutoMem 把内存管理训练为可学习认知能力,让32B开源模型实现2-4倍进展提升;Red Queen Gödel Machine 使评估者与Agent共同进化以避免平台期。还有ASPIRE(机器人连续代码作为策略)、HORIZON(硬件设计的仓储代码进化)、Reasoning Quality Emerges Early(推理质量可早期预测)。
2. Anthropic Labs 发布长运行应用开发 harness 设计经验
Anthropic Labs 成员 Prithvi Rajasekaran 撰文详细分享了构建多Agent编码harnes的经验。该harness使用规划器、生成器和评估器三Agent架构:规划器将简短提示转为产品规格,生成器构建应用,评估器通过PlayWright MCP打开运行产品并检查API和数据库状态。早期评估器发现真实bug后却经常说服自己通过,因此需要读取日志、调整评判标准,将主观判断转化为可检查的条件。文章诚实地报告了成本数据:独立复古游戏制作人运行耗时20分钟花费9美元但核心玩法未工作;完整harness耗时6小时花费200美元但产出更完整的应用。核心教训是:Agent harness是关于当前模型无法可靠完成的事情的工程赌注,随着模型改进,部分脚手架可能不再需要。
来源:Harness design for long-running application development
3. Scaling Laws 真相:原始论文因bug得出错误结论
一篇来自 Complete Skeptic 的文章声称 OpenAI 的原始 Scaling Laws 论文(Kaplan et al)存在bug,导致多年来人们训练了过大而数据不足的模型。核心问题有三步:首先所有模型使用了固定数量的训练token(约130B);其次采用衰减到零的余弦学习率计划,使模型看起来已经饱和;然后声称结果与学习率计划大致无关。这使得看起来更大的模型不再需要更多数据,但实际上是学习率计划人为限制了性能。Chinchilla 论文随后纠正了这一错误,得出模型应小得多、数据应多得多。作者指出这个bug曾被私下发现但未公开承认。对于研究者来说,Chinchilla 的 scaling laws 是正确的。
4. 每周AI论文精选(6月28日-7月5日)
Elvis Saravia 的AI Newsletter总结了本周最值得关注的10篇AI论文。其中Red Queen Gödel Machine让Agent和评估者共同进化以避免平台期;MCP Server Patterns从实际部署中提炼出五种服务器架构;The Verification Horizon论证了奖励机制必须与策略共同演化来对抗奖励劫持;Paper Assistant Tool是Google用于规模化论文深度评审的Agent框架;Generative Skill Composition将技能选择视为生成问题而非检索;AutoMem将内存管理训练为可学习的认知能力,实现2-4倍进展提升;RLMF使用模型的元认知作为训练信号达到更好校准;ASPIRE让机器人代码作为策略持续学习;HORIZON将硬件设计视为仓储级代码进化;Reasoning Quality Emerges Early指出推理质量可从开头约100token预测。
5. 有品味的创始人利用Agent成为新一代独角兽
Garry Tan 引用一篇关于“业余科学时代”的文章,提出:拥有品味和洞察力的40多岁创始人成为新一代独角兽创始人,因为他们可以通过Agent和软件工厂调动100倍到1000倍的人工。原文指出AI使科学变成像业余时代一样可以由个人完成,而品味——即知道什么值得建造的能力——成为最稀缺的资源。这与Token经济学的观点一致:当AI使执行能力几乎免费时,选择正确方向的能力成为核心差异。这个观点将品味提升为AI时代最关键的人才特质,对创业者有启发意义。
来源:We are in the “gentleman scientist” era of AI research
6. 消费级AI应用为何难以盈利:价值获取的结构性困境
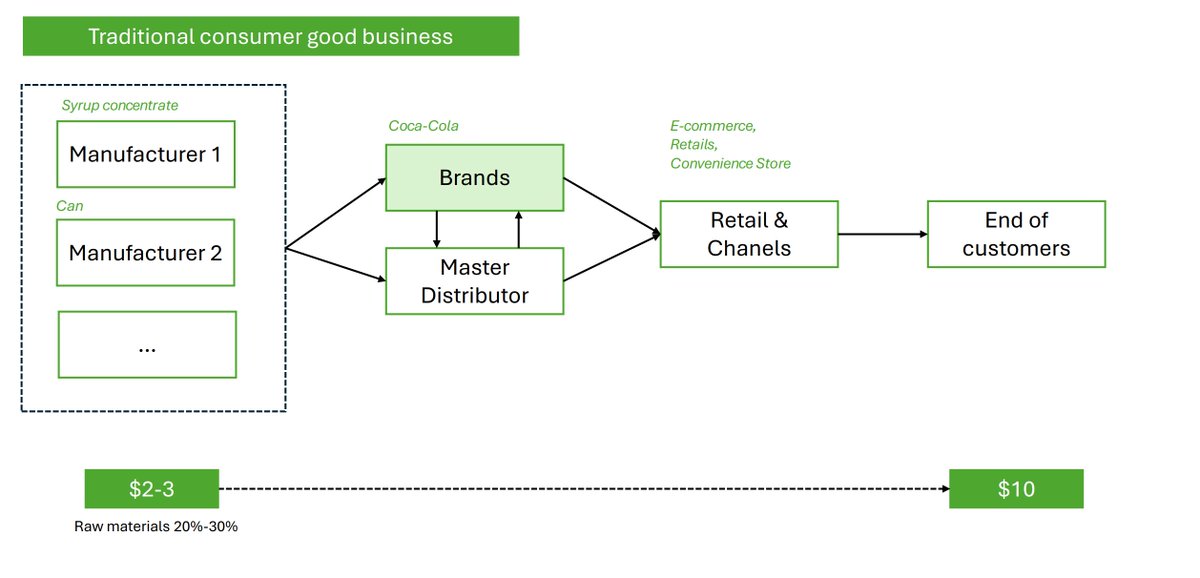
本文分析了消费级AI应用面临的商业模式困境:它们是模型厂商的下游,成本以token计价,但价值却难以差异化。在传统消费品中,原材料成本仅占产品的20-30%,其余来自品牌、包装、分销和信任。但在消费AI中,「原材料」成本可能高达售价的80%。更严重的是,供应商(OpenAI、Anthropic等)也在构建自己的消费端产品。这意味着消费AI应用不仅互相竞争,还与供应商竞争。赢家(如Manus、Simular、Vercel、Genspark)不能只是转售token,必须让每个token创造出至少5倍于成本的差异化体验。文章指出高可变成本、弱定价权和拥挤的分销渠道是这个行业的根本挑战。

7. ICML 2026 论文证明:大规模简单提示工程可超越复杂方法
在ICML 2026发表的这篇论文提出SPA(Scaling Prompt-engineered Augmentation),发现使用仅7个提示模板生成大量合成数据,就可以在数据稀缺领域的知识注入任务中超越多种依赖于RL或多阶段提示流水线的更复杂方法。这是一个「苦涩教训」式的发现:扩大简单但可扩展的方法往往比设计复杂算法更有效。这对于低资源领域的LLM微调策略有直接指导意义——先尝试大规模合成数据,再考虑复杂方法。

来源:@tangkexian
8. 企业从 token 最大化转向模型路由:优化AI支出的新趋势
据Business Insider报道,企业正从盲目消耗token转向按需分配模型。模型路由(Model Routing)变得至关重要:廉价的模型处理草稿、分类、摘要、测试和初遍推理,前沿模型只负责失败成本高于请求成本的任务。报告显示使用路由的企业从约1%上升至5%。路由方式包括基于规则(用户层级、预算)、任务路由(匹配专业模型)、难度路由(简单任务低配,复杂任务高配)、级联路由(从小模型开始逐步升级)、置信度路由(测量不确定性决定是否重算)、偏好路由(学习用户评分)、预算感知路由(控制输出长度)、缓存优先路由和故障切换路由。这种转变表明AI经济正在成熟,从无限制消耗转向精细化成本控制。