
AI 日刊 · 2026-10-10
Product
1. Claude Managed Agents 动态工作流公开测试
Anthropic 把 Claude Managed Agents 的 dynamic workflows 扩到公开测试。主 agent 不再只把任务丢给子 agent 再读回报,而是写一份 workflow 程序,按阶段在后台跑很多 agent,再把结果合起来。官方帖写明配置类型是 multiagent_20261001,单次 run 最多编排 1,000 个 agent。平台文档把上限写得更具体:一次 run 同时工作的线程默认 64,这个数字不保证固定;整个 run 生命周期里启动的 agent 上限是 1,000,再要就会以 thread_limit_error 结束。默认寿命 24 小时,也可由 agent 自设。文档同时说,这种编排很耗 token,建议从范围明确的任务开始,再加大复杂度。Claude Code 里的入口是 /claude-api managed-agents-onboard bug-hunter。这把多 agent 从“主线程亲自调度”推进到“主线程写编排程序、服务器后台执行”。子 agent 线程仍可追问,workflow 则是 Claude 不直接参与的程序。额度、失败重试和 64 线程是否稳定,都还要看实际账单和 run 事件。

来源:@ClaudeDevs
2. Claude Code Projects 放行候补 Pro 与 Max
Anthropic 把 Claude Code Projects 候补名单上的全部 Pro 和 Max 用户放了进来。官方定义很具体:一个 project 是一段持续对话,Claude 替你协调相关工作,每项任务通常开一个自己的线程,线程一般是云端的 Claude Code 会话,彼此并行,共享仓库、指令和记忆。需要本机环境时,可以通过 Remote Control 把该线程改到你的电脑上跑。文档写明这是 Pro 和 Max 的公开测试,正在逐步放量,优先给用过云端会话、且没有 claude.ai chat 或 Cowork 里既有项目的账号。Team 和 Enterprise 还不能用。侧边栏看不到 Projects 的人仍可加入候补。这和 Managed Agents 的动态工作流不是同一层:Projects 是产品里的持续协调界面,动态工作流是平台 API 上的编排程序。
来源:@ClaudeDevs
3. Vercel CLI 允许 agent 买域名
Vercel 让 agent 通过 CLI 走完买域名的流程,但付款确认仍要人做。changelog 写了命令链:vercel domains search 找候选,vercel domains check 查是否可注册,vercel domains price 看注册商价格,vercel domains buy 发起购买。非交互运行时,buy 会返回机器可读错误和建议的下一步,把确认交回给人。人要确认价格、自动续费和注册人联系信息。Guillermo Rauch 转发时说,agent 已经经常通过他们的 CLI 在 marketplace 买基础设施,这次把能力扩到域名,agent 可以从想法走到全栈。边界是花钱这一步没有放开。agent 可以搜索、比价、发起,但不能在无人确认时扣款。
来源:Vercel
4. Codex 桌面端开始预测下一条消息
OpenAI 在 Codex 桌面端给 Pro 用户开了 composer predictions 测试。Codex 会根据当前对话和你平时怎么跟它说话,建议下一条消息。接受方式是按 Tab,也可以先改再发送。设置里可以关掉。范围是桌面端的本地任务,不是全部 Codex 入口。OpenAI 说这是内部测试里最受欢迎的新功能之一。负责发布的 keyanzhang 补充,内部的人经常因为它太准而愣一下,且包含在 Pro 计划里、不另扣用量。这是把“下一步该说什么”从用户输入变成模型建议。它不改模型能力,改的是本地编码会话里的输入节奏。
来源:@OpenAIDevs
5. Grok Bot 可以申请自己的邮箱
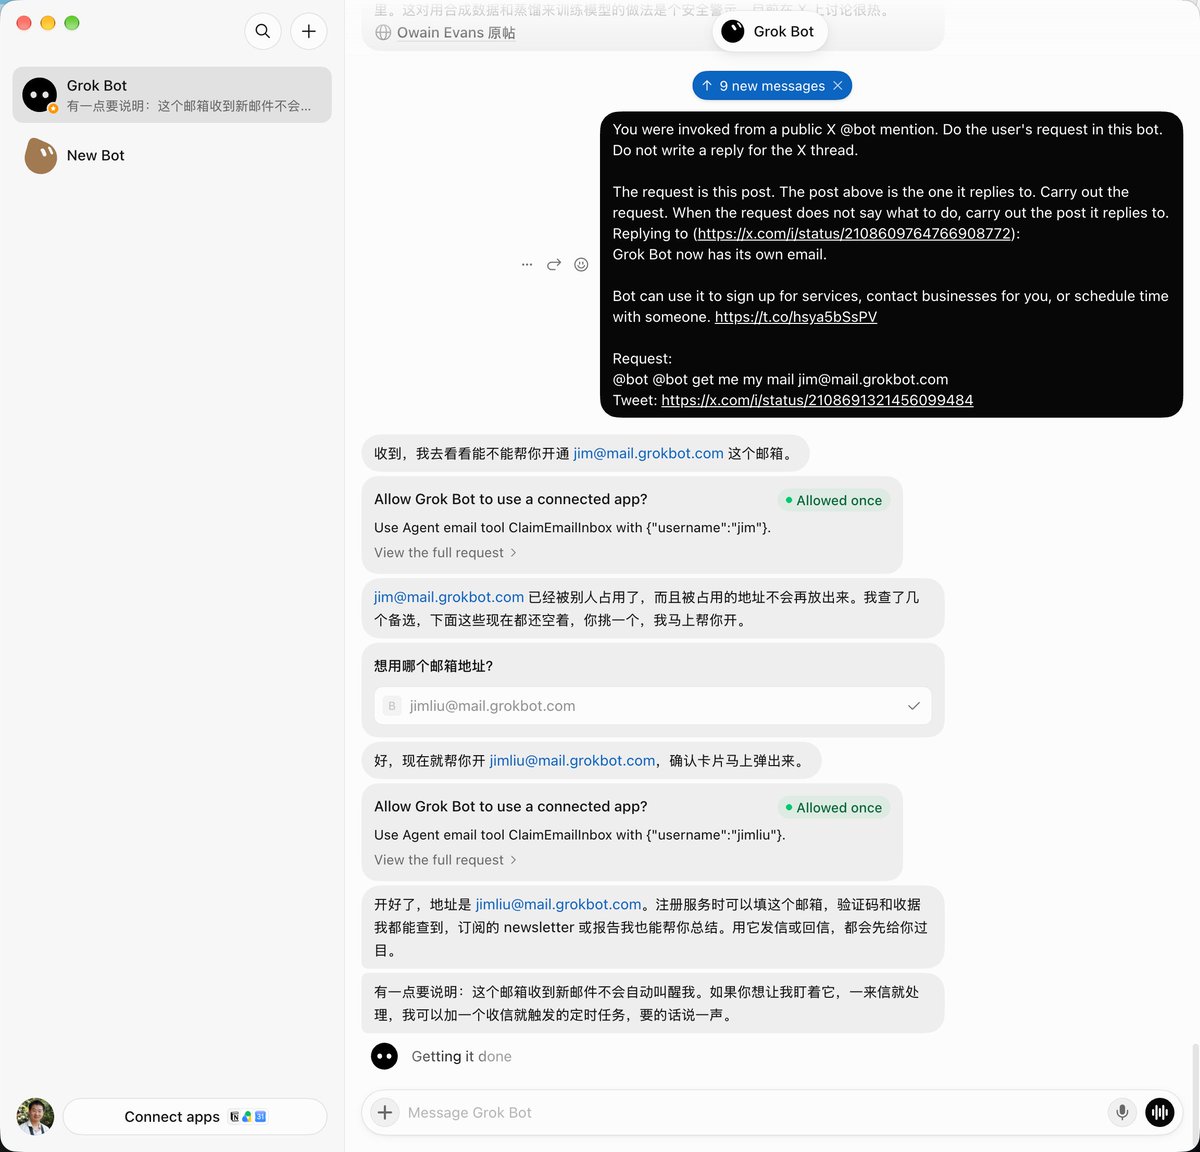
Grok Bot 开始有自己的邮箱,域名是 mail.grokbot.com。官方帮助页写了用途:用自己的地址注册服务并在你同意后取验证码,收集收据和简报再给你摘要,在你要求后发信并处理回复,以及在邮件到达时跑你设好的 routine。领取方式有两种:直接对 Bot 说“给自己申请邮箱”,它会问名字、查重、出确认卡,你批准前不会占用;或在桌面插件市场、手机设置的 Email 插件里填名字创建。地址全小写,最长 64 字符,support、admin 等保留词不能用。每人一个,不能改名,不能删除,注销后也不再发给别人。所有你的 Bot 都能用这个地址,但 Slack 线程、别人和 Bot 的对话、Team Bot 不行。Cursor 团队默认关闭,要管理员先开 Agent Email。新邮件不会自己叫醒 Bot,必须靠 routine。发信默认先给你看完整草稿。宝玉补充了在 X 上 @bot 申请的路径。
来源:@dotey
6. ChatGPT 手机端可直接创建 Dot
ChatGPT 官方账号说,dots 更新的第一项是:现在可以在 iOS 和 Android 的 ChatGPT App 里直接创建自己的 dot。帖子附了演示视频,没有写 dot 的权限、能连哪些应用、是否默认常开。O’Reilly 本周摘要把 Dots 描述为 OpenAI 的主动助手:保留上下文,跨应用工作,追求多个目标,不等提示就行动。要做到这一点,它需要对所跨应用和数据有持续访问。手机端能创建,意味着入口从桌面或网页扩到了随身设备。具体能创建什么、创建后默认拿到什么访问,这条官方帖没有展开。
来源:@ChatGPT
Tutorial
1. 4GB 显存可本地训 Jev 式决策模型
Akshay 发了一条本地训练视频:以 Qwen3.5 0.8B 为基座,用 Jev 式方法训练决策模型,60 步、约 10 分钟后,准确率从 37% 升到 65%,显存只要 4GB。章节从 0:50 的 Unsloth 安装开始,后面被截断。他引用自己更早的一条帖子,原文没有展开。这和微软 Decision-1、Cloudflare Clef 是同一类模型,只是规模落到了笔记本。37% 到 65% 是他这次运行的数字,不是公开基准榜。视频承诺可复现,但卡片没有给出数据集、评测集和最终检查点。
2. Agent Skills 工具按生命周期收成一份清单
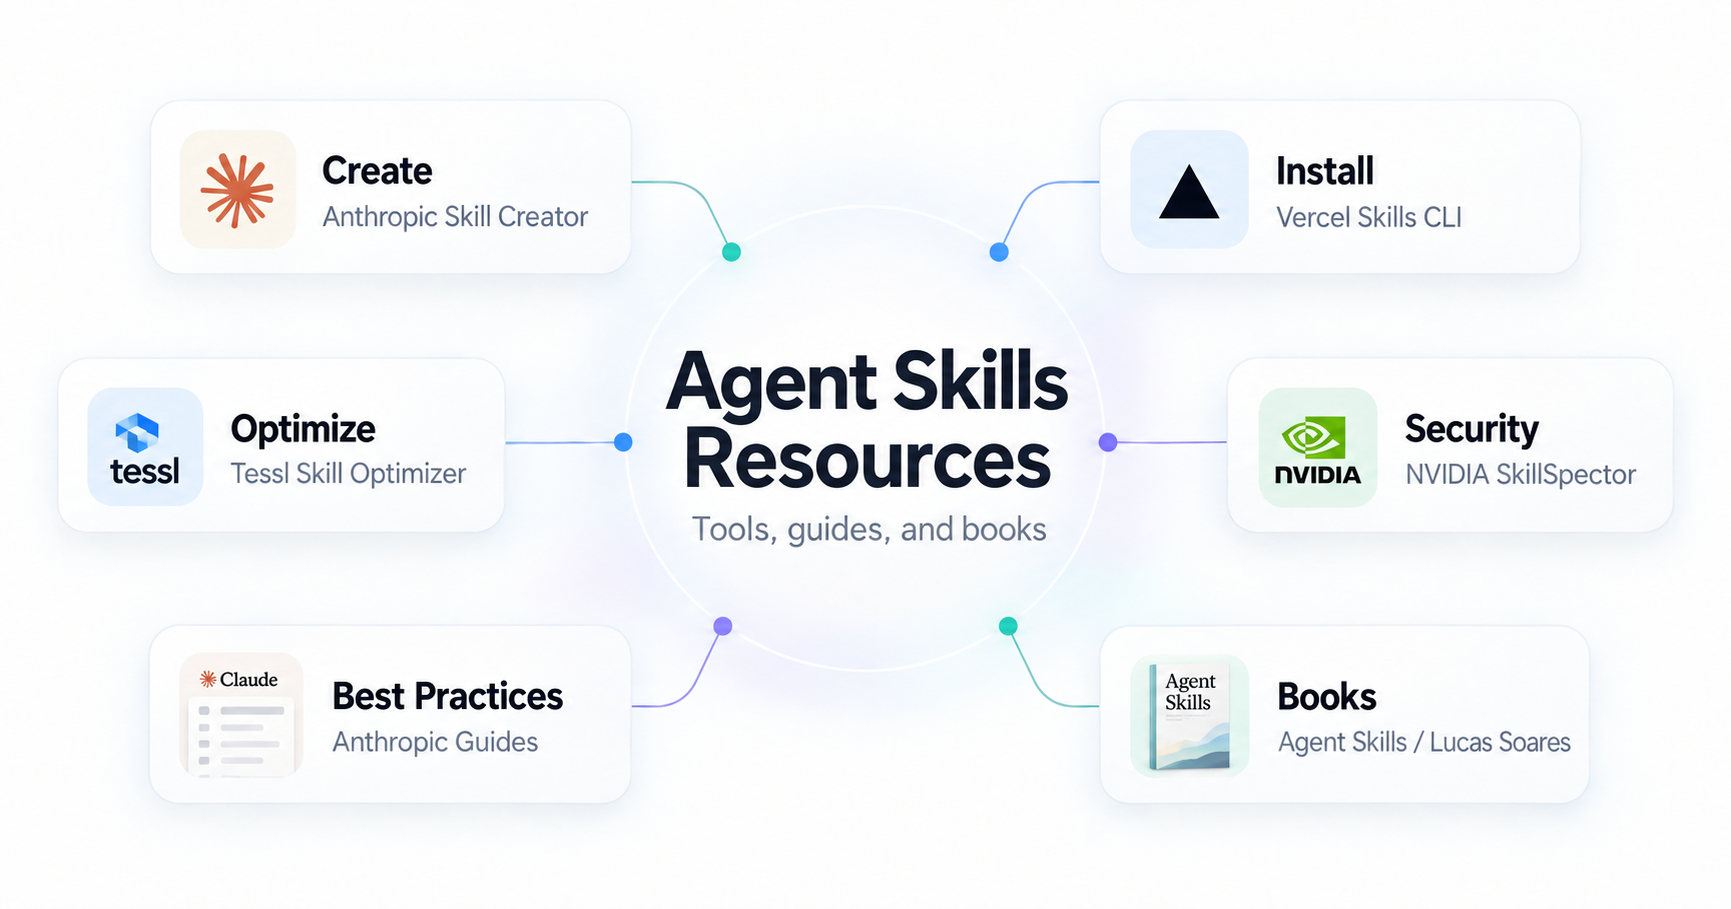
The Generative Programmer 整理了一份 agent skills 资源表,按生命周期而不是按热度排。作者认为写 SKILL.md 是容易的部分,难的是让 agent 在合适请求里找到技能、正确使用,并在工具和模型变化后继续这样做。清单先给规范:Agent Skills specification、best practices、Anthropic 的写作指南、Claude Code 的发现与加载文档。创建层推荐 Anthropic 的 skill-creator,因为它有测试用例、评测和反复改进,而不只是模板。BrowserAct Skill Forge 把重复的浏览器操作收成技能;Skill Seekers 从文档、仓库和 PDF 抽知识再打包。发现层分了 skills.sh、SkillsMP、ClawHub 和带质量评估的 Tessl Registry。后面还有校验、基准、安全扫描,正文在采集窗口里没有展完。这是一份编辑过的工具地图,不是新标准。
3. Lee Robinson 在斯坦福讲常驻 agent
Lee Robinson 放出他在 Stanford CS146S 的讲座,题目是像 @Bot 这种 always-on、主动 agent 怎么工作。时间轴是:2:35 怎么走到这里,6:13 模型变了什么,10:06 常驻 agent 内部,18:07 harness,27:26 context engineering,34:26 接下来去哪。帖子没有文字稿,视频本身不能从卡片核实。能用的是结构:他把变化拆成模型、常驻循环、harness 和上下文,而不是只讲一个产品发布。这和同日的 Grok Bot 邮箱、ChatGPT dots 手机创建是同一类产品问题的课程版。
来源:@leerob
Opinions/Thoughts
1. sudo L7 测编码 agent 的 Staff 判断
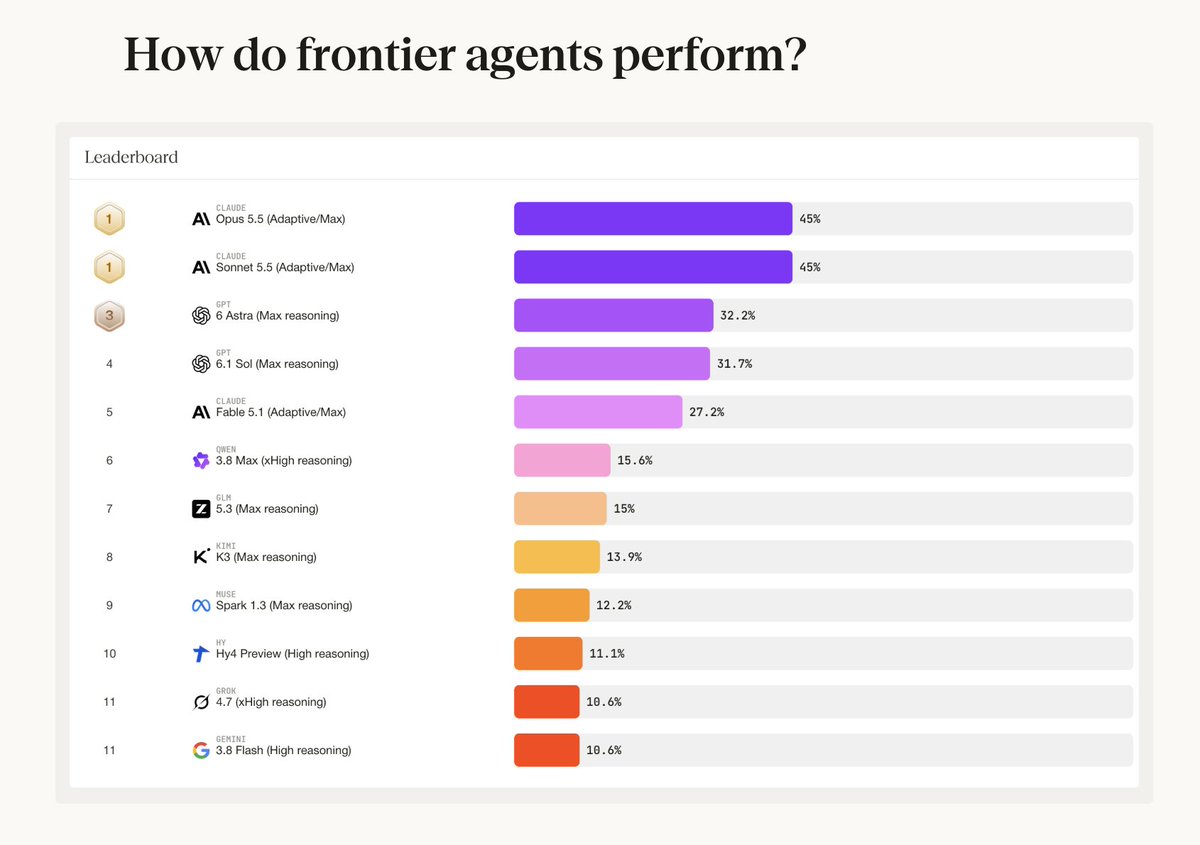
Lenny 转发 Surge 的 sudo L7,说最好的编码 agent 离 staff 级软件工程大约走了一半。原文把 staff 和初级工程师分开:初级工程师拿一张定义清楚的工单写补丁;staff 拿到的是“让它更快”“安全迁移”“先判断该做什么”。基准有 60 个任务,由 staff 及以上工程师编写,主要来自真实公司的私有生产仓库。Claude Opus 5.5 和 Sonnet 5.5 各完成大约 45% 的任务,GPT-6 Astra 大约 32%。功能正确性上四家接近:GPT-6.1 Sol 82.4%,Opus 5.5 82.1%,Astra 81.5%,Sonnet 5.5 79.6%。差距在 Thought Partnership:Opus 和 Sonnet 是 76.1% 与 74.8%,Sol 和 Astra 是 53.0% 与 51.6%。沟通分上 Sonnet 72.4%,Sol 44.1%。成本也不一样:Opus 约每任务 10 美元,Sonnet 约 14 美元,Sol 约 1 美元出头、完成率约 30%。例子包括 Opus 把已有的分账功能又做了一套,267 个测试全过。
来源:@lennysan