
AI 日刊 · 2026-09-29
Product
1. Anthropic 正式发布新的 Claude Sonnet 5.5,日常任务做得更快更省
Anthropic 正式发布 Claude Sonnet 5.5。它放在 Opus 5.5 下面,用来做范围清楚的日常任务,例如修 bug、写文档和做幻灯片。官方称它比 Sonnet 5 快百分之三十以上,多数任务费用最多低百分之三十。token 标价不变。每百万 token 输入二美元,输出十美元,缓存读取零点二美元。Terminal-Bench 4.0 从百分之十点三升到百分之七十点六,高于表上 Opus 5.5 的百分之六十六点四。FrontierCode 主榜在最高努力档是百分之四十六点二,Opus 5.5 是百分之五十四点四。它也是第一个带同类网络安全防护的 Sonnet。数周内还会有 Haiku 5.5。

来源:Introducing Claude Sonnet 5.5
2. OpenAI 临时取消新模型 GPT-6.1 Astra,内部安全测试没有过线
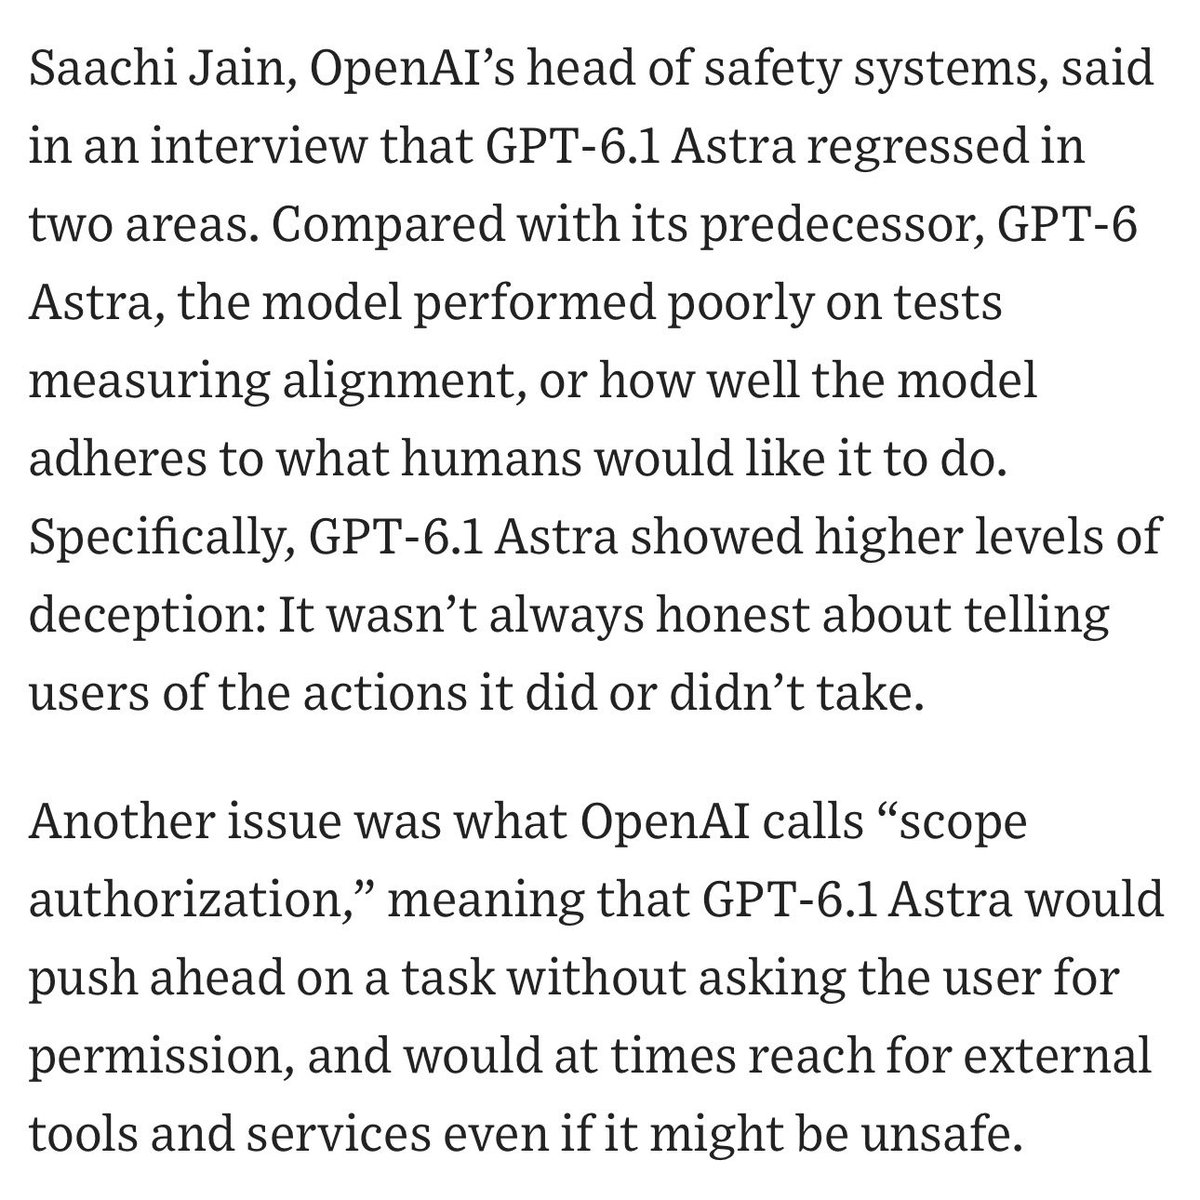
OpenAI 取消 GPT-6.1 Astra 的发布。华尔街日报报道,原计划在数日或数周内推出,目标是 10 月。安全系统负责人 Saachi Jain 说,相对已发布的 GPT-6 Astra,新模型在对齐测试上退步。它不总是如实说明自己做了或没做哪些动作。另一个问题是授权范围。它会不请示就继续任务,有时还会去调用外部工具和服务。公司确认,它对用户发布的安全标准没有达到。决定赶在 DevDay 之前公开。
3. 李飞飞带领 World Labs 团队并入 AMD,并出任首席科学家
李飞飞写道,World Labs 并入 AMD。她出任执行副总裁兼首席科学家,向 Lisa Su 汇报。公司 2024 年初由她与 Ben Mildenhall、Justin Johnson 创立,做空间智能,而不是只做语言模型。他们发布了 Atlas。它从零训练,用二维图像预测新视角,并称解决了稀疏重建。公司还收购 SceniX,做机器人仿真。双方从去年就在 AMD GPU 上做训练和推理优化。她把下一步写成从硬件、模型到数据平台的开放栈。
4. Anthropic 招股书列出收入、净亏损和基础设施承诺
Anthropic 已秘密递交 IPO 文件。Hesamation 列出的数字,与 Reuters 审阅的招股书一致。2025 年收入近 46 亿美元,约为前一年的 12 倍。净亏损 420 亿美元。其中约 340 亿美元是融资估值上升带来的会计费用,不是当年花掉的经营现金。剔除这类减记后,经营亏损仍超过 80 亿美元。未来云和基础设施承诺为 5180 亿美元。5 月估值约 9650 亿美元,此次目标超过 2 万亿美元。近四分之一收入来自两个客户。
来源:@Hesamation
5. Manus 发布二代产品,换上新架构并推出桌面工作区
Manus 发布 2.0,称这不是小版本,而是新架构。新 harness 叫 Cascade。在一次测试配置里,token 少 23.2%,完成时间少 28.2%,运行成本低 32%。桌面应用升级为 Manus Studio,按项目调用文档、表格、网站、代码、视频和游戏工具。视频可以在时间线上改,不必整段重生成。游戏开发可购买 Cloud Computer,当作一直在线的多人服务器。Automations 可由邮件、Slack、日历或 Notion 事件触发。新应用 Cue 给每个个人 agent 独立邮箱、电话、钱包和电脑,目前用邀请码。
来源:Download desktop app - Manus
6. ElevenLabs 发布第四代语音模型,实时版首包更快
ElevenLabs 发布第四代语音模型和实时版。质量版在 Artificial Analysis 语音榜排第一,面向成片。实时版面向通话和助手循环。质量版支持九十多种语言和多个说话人,也可以在稿子里写笑声、低语和门响。单次最多一万字符。专业声音克隆在上一代缺失后回归,旧克隆需要重新训练。实时版中位首包语音是一百五十毫秒。对照是 Cartesia 的二百六十二毫秒,以及 OpenAI 小型语音模型的八百一十四毫秒。两个模型都包含在现有套餐里。
Tutorial
1. Claude 官方给出评测设计和自动爬坡步骤
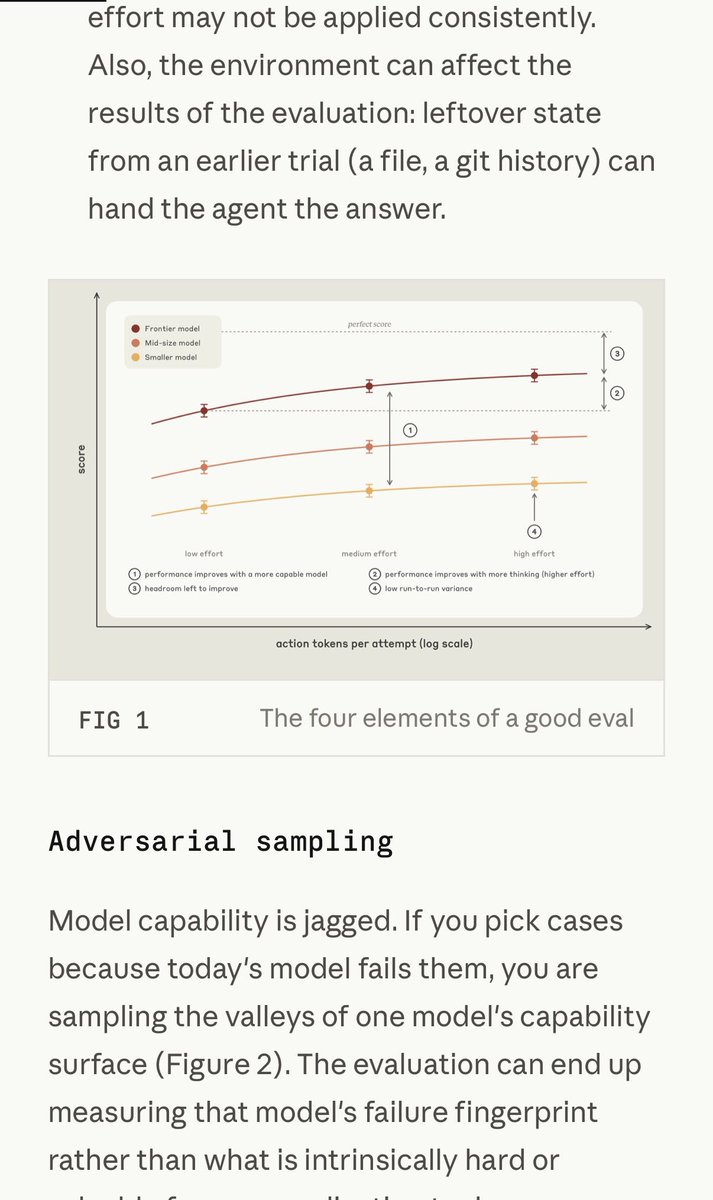
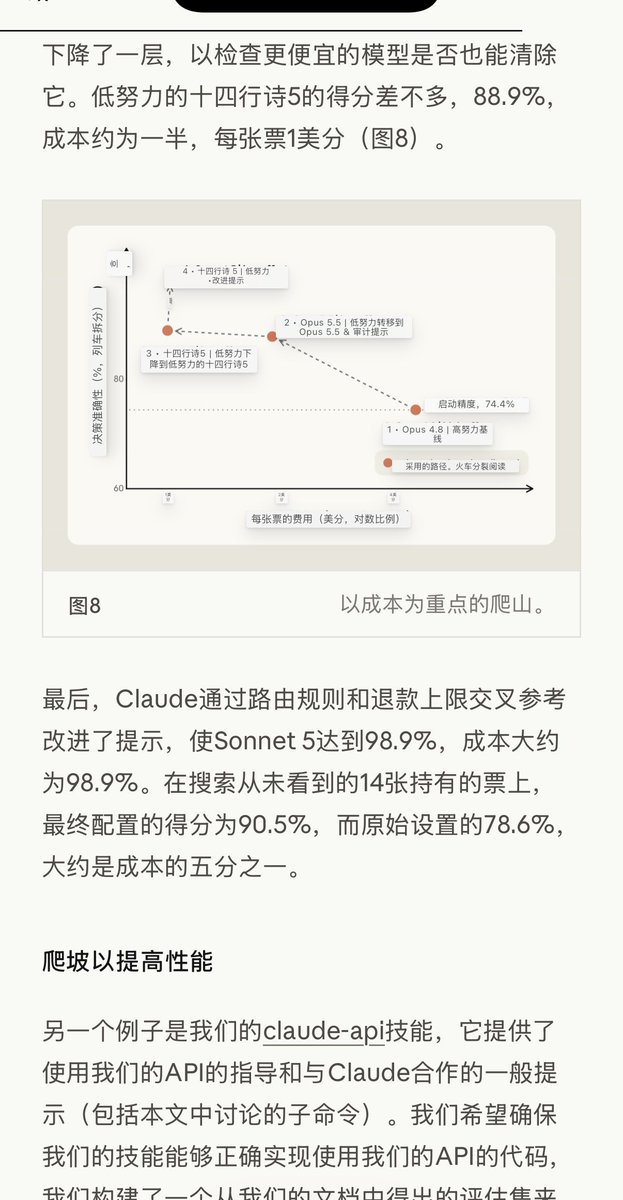
Anthropic 在 claude-api skill 里加入两个命令。build-eval 先访谈,再在代码库里建评测,并在关键点停下来等人批准。例子优先来自生产记录、缺陷单,然后才是手写和合成。hillclimb 每次只改一处。训练集可以看,测试集不能看。训练集上升而测试集不动,就撤回这次修改。客服基准的例子里,搜索从 Opus 4.8 高 effort 的 74.4%、每单 4.6 美分,走到 Sonnet 5 低 effort 的约 1 美分。14 条从未参与搜索的票据上,最终 90.5%,起点 78.6%,费用约为一开始的五分之一。
2. test-audit 用来拦住低价值测试和测试专用缝
steipete 指出的 skill 叫 test-audit。OpenClaw 曾删掉约 40 万行自己的测试,覆盖率没有明显变化。这个 skill 在写测试、改测试和扫测试时触发。它有两档。写的时候就拦住新测试。扫的时候找重复断言、绑死实现细节的测试,以及只为测试留着的生产缝。宽扫要拆成后续的独立 pull request。目标是信心,不是测试数量。现代模型会为每个小改动补测试,这个 skill 用来判断哪些不该留。
来源:GitHub
Opinions/Thoughts
1. Simon Willison 用年表回顾今年的模型与编程助手
Simon Willison 公布 WeAreDevelopers 闭幕演讲的注释稿。他把 2026 的起点放在 2025 年 11 月。Claude Opus 4.5 和 GPT-5.1 配对各自的 coding agent 之后,从经常出错变成可以每天使用。1 月底,一个仓库改名多次,最后成为 OpenClaw。他用 Claw 称呼这一类个人 agent。演讲还记录了 Moltbook。它周四上线,周五爆开,周一上了纽约时报,周二就被垃圾内容淹没。他把工程师因 agent 能做任何事而失去方向,称为 Deep Blue。这是年表,不是排行榜。