
AI 日刊 · 2026-09-28
Product
1. Ember-1 少花约四成 token,对齐 Kimi K3
Fireworks Research 发布 Ember-1。它在 Kimi K3 上再训练,目标是砍掉不必需的推理,而不是只把推理强度调低。官方称质量保住了,总 token 大约少 40%。他们做了 50 多次训练实验、200 多次评测,训练数据不含客户数据。七个基准和两家客户的流量上,推理长度可缩短 35% 到 50%,准确率没有下降。线上对照里,每任务 token 大约少 35%。其中一家分数从 0.751 到 0.753,推理 token 少 71.3%,总 token 少 39%。模型以 Research Preview 放在 Fireworks Serverless。
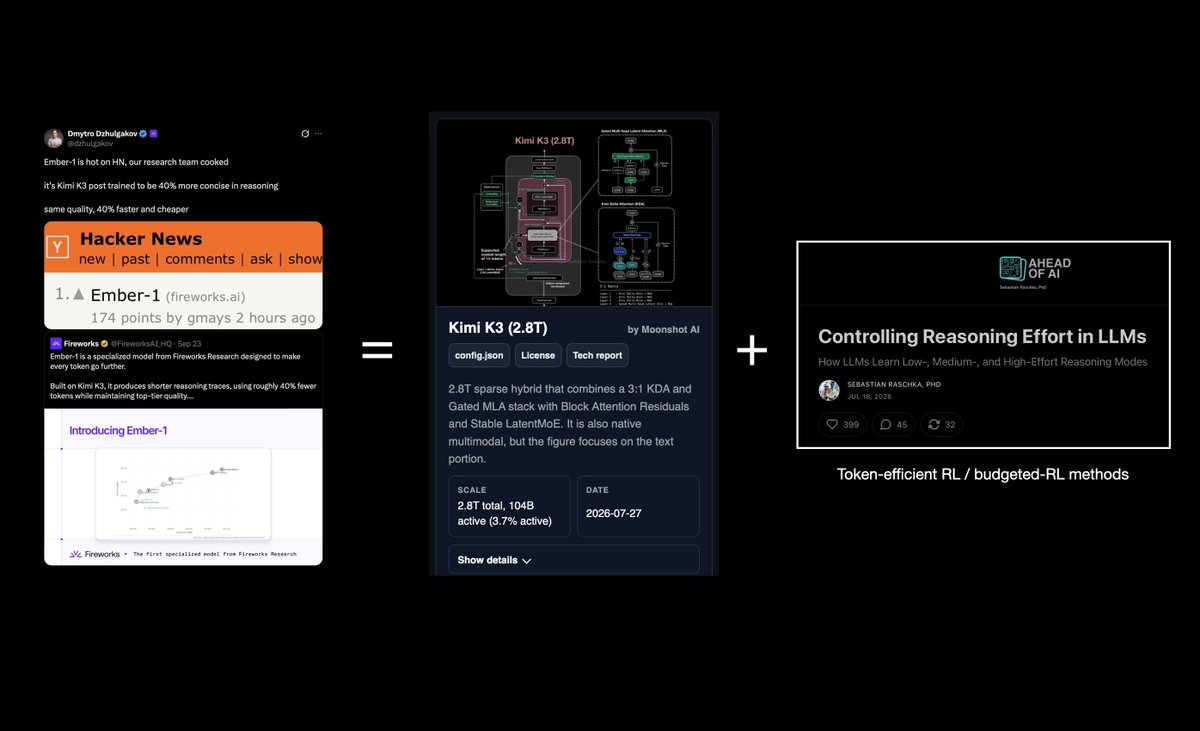
来源:@rasbt
2. Opus 5.5 降价后,订阅额度大约多走 25%
Addy Osmani 解释 Opus 5.5 的任务费用。API 标价是每百万 token 输入 4 美元、输出 20 美元、缓存读取 0.20 美元。输入和输出都比 Opus 5 便宜 20%。缓存读取便宜 60%,读取价从输入价的十分之一降到二十分之一。Pro、Max 和 Team 会把更低的价格计入额度,包括缓存上下文,所以额度大约比 Opus 5 多走 25%。五小时额度也提高了。费用由轮数、缓存读取、输出类型和模型价格一起决定。少想或换小模型能省 token,但一次返工可以吃掉这些节省。快速模式最多快 2.5 倍,价格是两倍,记在用量点数上,不占套餐额度。
3. GPT-6 Sol 与 Luna 修复图像理解回退
OpenAI 修复了降低 GPT-6 Sol 和 GPT-6 Luna 图像理解的缺陷。官方说,视觉任务的结果现在应当更好。修复覆盖 API 和 Codex,也包括计算机使用。如果你的流程会传入图像,官方建议重跑评测,再试一次这些流程。细节写在开发者更新日志里。修复前记下的视觉分数,不能直接代表现在的这两个模型。
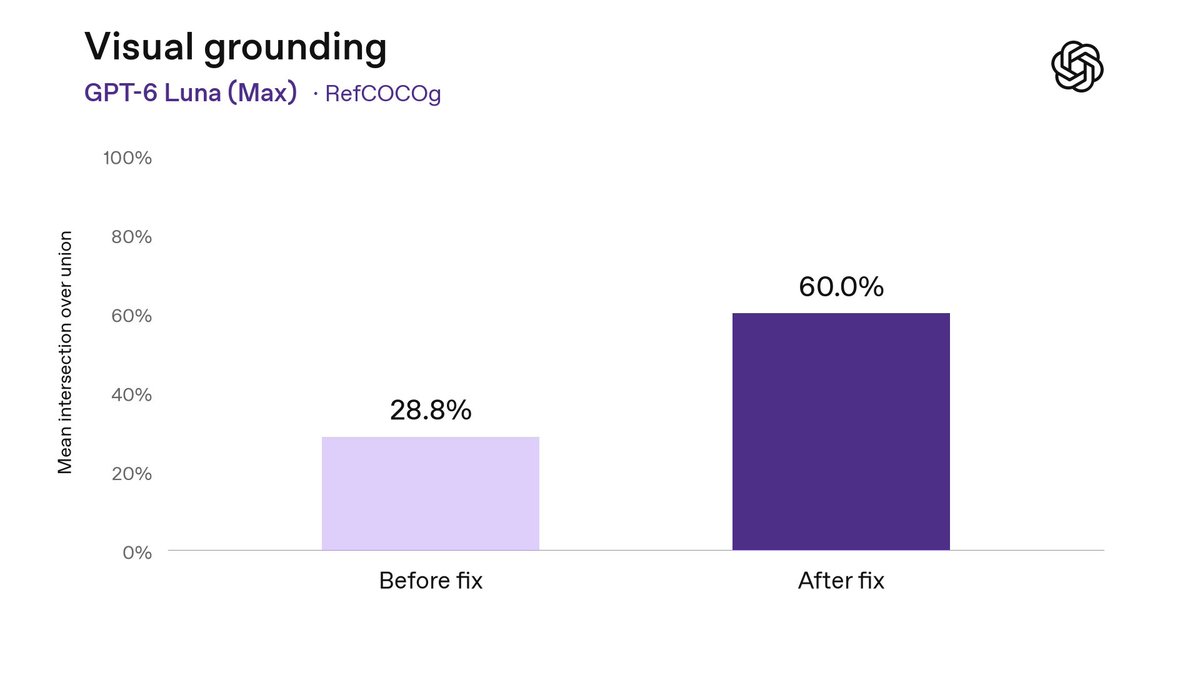
来源:@OpenAIDevs
4. Cursor 改框架后,token 费用合计少 7%
Cursor 调整了智能体框架。这些改动合计让用户的 token 费用下降 7%,质量没有下降。系统提示大约删掉 66%。读、搜、改和终端这些高频工具仍放在每次请求里,其余内置工具用到时再加载。更早把 MCP 工具改成动态加载时,调用过 MCP 的会话总 token 少了 46.9%。GPT-5.6 之后,他们在稳定前缀和仍在增长的对话之间放了显式缓存断点,冷缓存未命中下降 20%。文件行号改为每十行标一次,缓存读取 token 少 1.6%。他们也删掉了强烈鼓励用子智能体探索代码库的指令。子智能体只有在用户或框架指定时,才换另一个模型。
来源:save about 7% on token costs
5. dsh-TUI 补上 Harness 的终端界面
dsh-TUI 给 DeepSeek Harness 补了一层终端界面。它是纯插件,不改核心,卸掉不留补丁。界面包括像素鲸鱼顶栏、实时状态、流式思考、双击 Esc 回滚、上下文进度和 TPS。它还能画 Mermaid,把 LaTeX 画成 Unicode,并支持 Kitty 或 Sixel 图片。DeepSeek 官方账号推荐了它。被引用的官方统计说,约 60% 的 DeepSeek Harness 用户至少用了一个第三方插件。
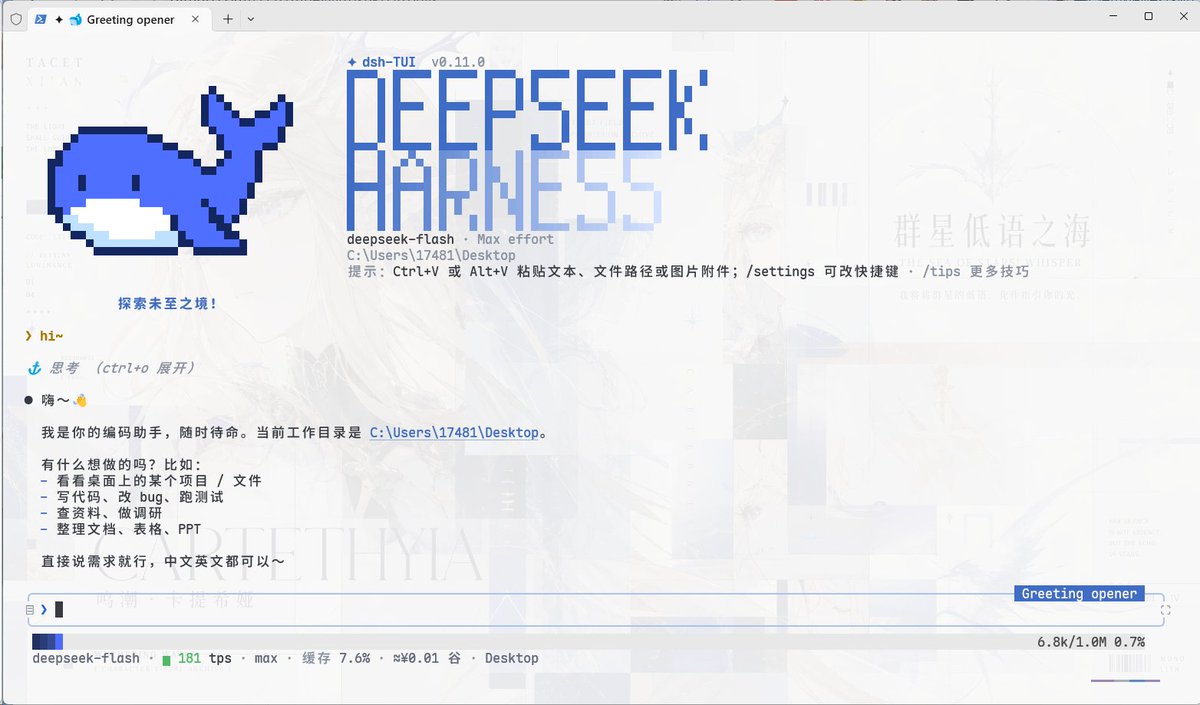
来源:GitHub
Tutorial
1. 十篇周论文看稀疏注意力和错误提示
DAIR.AI 整理了 9 月 21 日到 27 日的十篇论文。小米 HySparse2 面向 MiMo-V3。80B-A3B 上,预填充比 Hybrid SWA 少 5.02 倍,KV 缓存为 2.69 GB。SIFT 先用裁判比较补丁,再跑完整基准。o3-mini 在 30 次扩展后达到 Polyglot 35.1%,DGM 在 80 个节点后是 30.7%。JEV 做裁判时,每千次 0.044 美元、中位 0.152 秒,GPT-6 是 12.182 美元和 1.885 秒。普通判断差距在 3 分内,核对推导时扩大到 9 到 20 分。XYEval 只加一条自信但错误的提示,分数相对最多降 46.7%,模型却常照做。
2. 同一功能上,Astra 搭配 Opus 5.5 的实测
Kevin Kern 在自己的 TypeScript 财务应用里,只用一个功能比较了单模型、分工和互相审查。综合最好的是 Astra 通过 MCP 等 Opus 5.5 做完,再由 Astra 审查,总分 83.3。权重是代码 50%、体验 25%、设计 25%。费用更平衡的是 Opus 5.5 做完后让 Astra 审查,估计 API 费用约 31 到 32 美元。单跑 Opus 是 79.8,单跑 Astra 是 76.5。Luna 最便宜,分数是 66.0。早先用轮询确认 Opus 是否做完,大约花了 9.75 美元。作者还会再用 MCP 这套,但审查漏过一条路径:接口说已保存,提交的新值并没有写入。
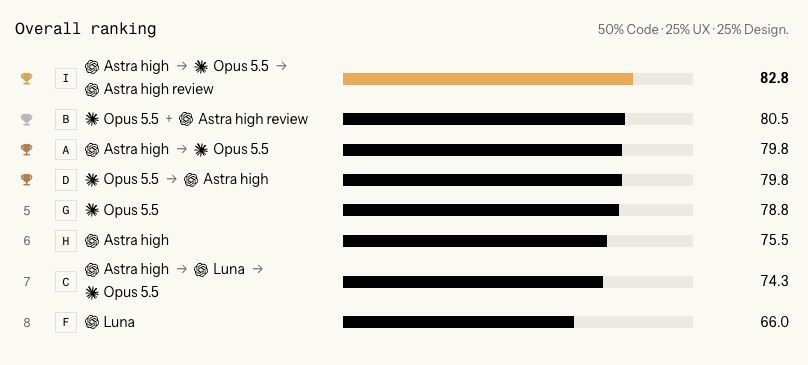
来源:Does pairing Astra & Opus actually help? | Kevin Kern
Opinions/Thoughts
1. 计划模式里的长规格已经不再够用
Ayman Nadeem 在 9 月 24 日写下《Plan mode is dead》。他今年做过一个以计划为中心的桌面编程应用 Nuanced。他认为,计划模式原来有两个用途:给智能体足够精确的指令,以及帮人理解自己在建什么。第一项正在失效,因为模型更能自己看仓库并做合理假设。第二项更重要,但一份要人批准的长规格不是合适的界面,尤其当你并行跑很多智能体。他改推的循环是:理解,行动,检查,澄清,调整,再行动。早期用户对那份规格没什么胃口。人如何在很多智能体同时改系统时保持方向,文章认为仍未解决。
来源:Ayman Nadeem
2. Thariq 考虑用 effort 取代 plan mode
Thariq 说,他们在考虑取消 plan mode。现在的 shift+tab 用来进入计划模式。改动后,这个快捷键将调节 effort 档位。他认为现在的模型不需要先写一份计划。他向仍想保留计划模式的人要具体理由。这是征求反馈,不是已发布的变更。快捷键一旦改掉,现有操作习惯会直接失效。