
AI 日刊 · 2026-09-23
Product
1. OpenAI 今天发布 GPT-6 Sol 和 Luna,接口价格比上一代低一半
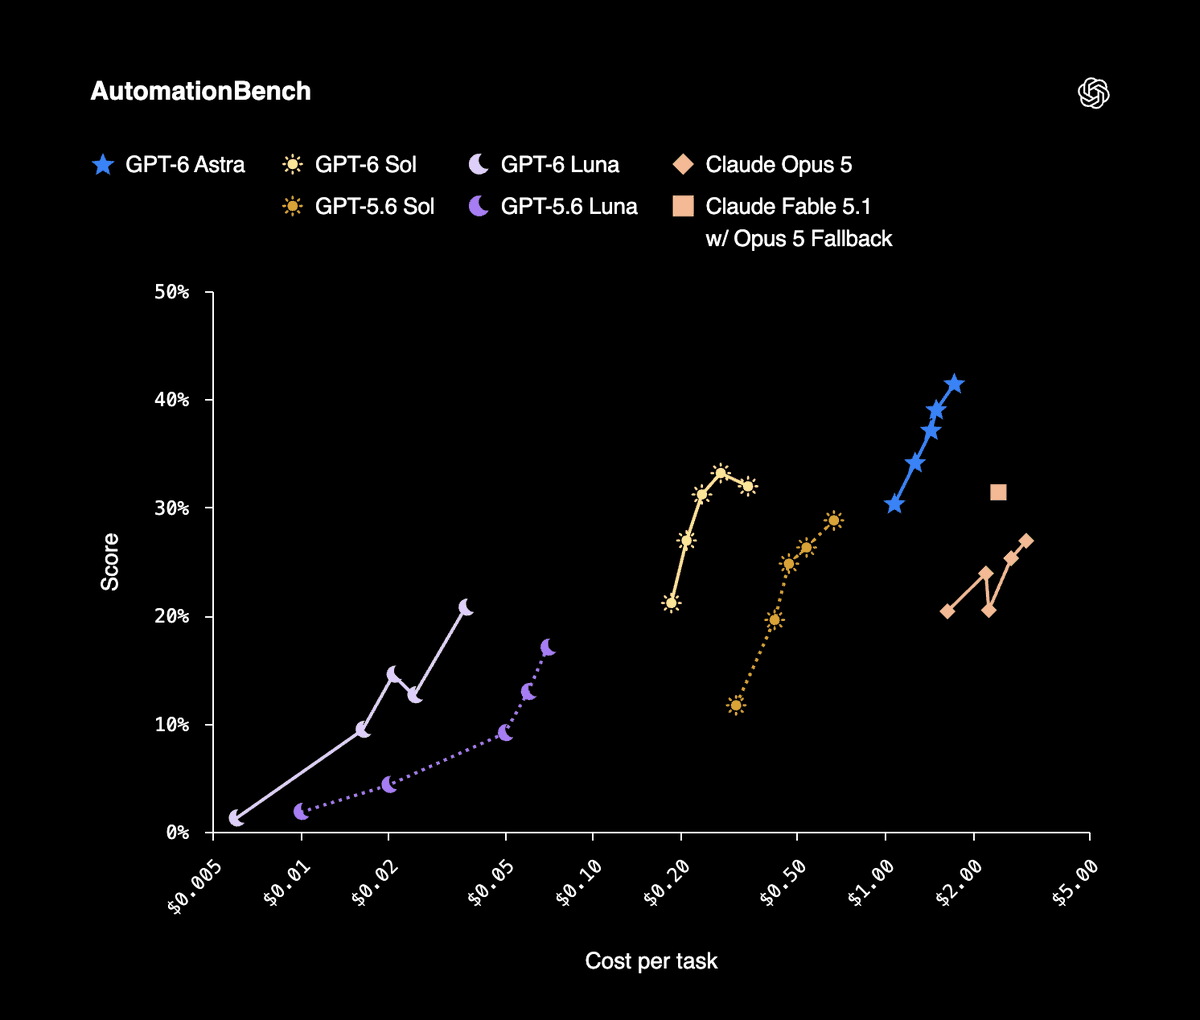
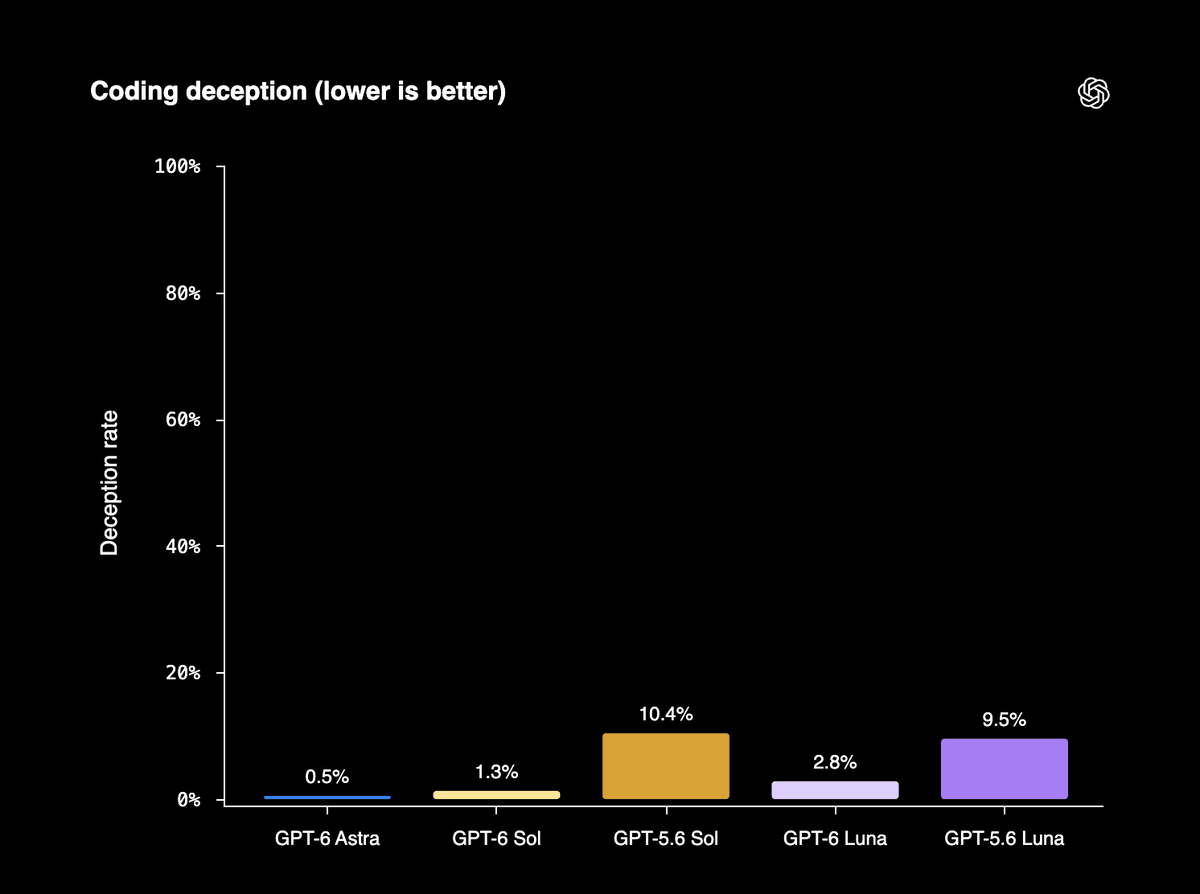
OpenAI 今天发布 GPT-6 Sol 和 Luna。训练方法与 Astra 同类,用来把专业工作、事实性、编码、计算机操作和对齐上的进展放到更快的模型里。接口价格比 GPT-5.6 促销价低 50%。Sol 输入 2 美元、输出 10 美元,Luna 输入 0.10 美元、输出 0.50 美元,单位都是每百万 token。官方 DeepSWE v1.1 上,Sol 最高档 68.8%,比 Fable 5 的 69.9% 低 1.1 个点,单次任务成本约低 80%。模型进入 ChatGPT Work 和 Codex,接口名是 gpt-6-sol 与 gpt-6-luna。普通 Chat 还没有。免费和 Go 用户可在桌面应用试用 Luna。
来源:@OpenAI
2. Anthropic 发布 Opus 5.5,多数工作接近 Fable 且运行成本更低
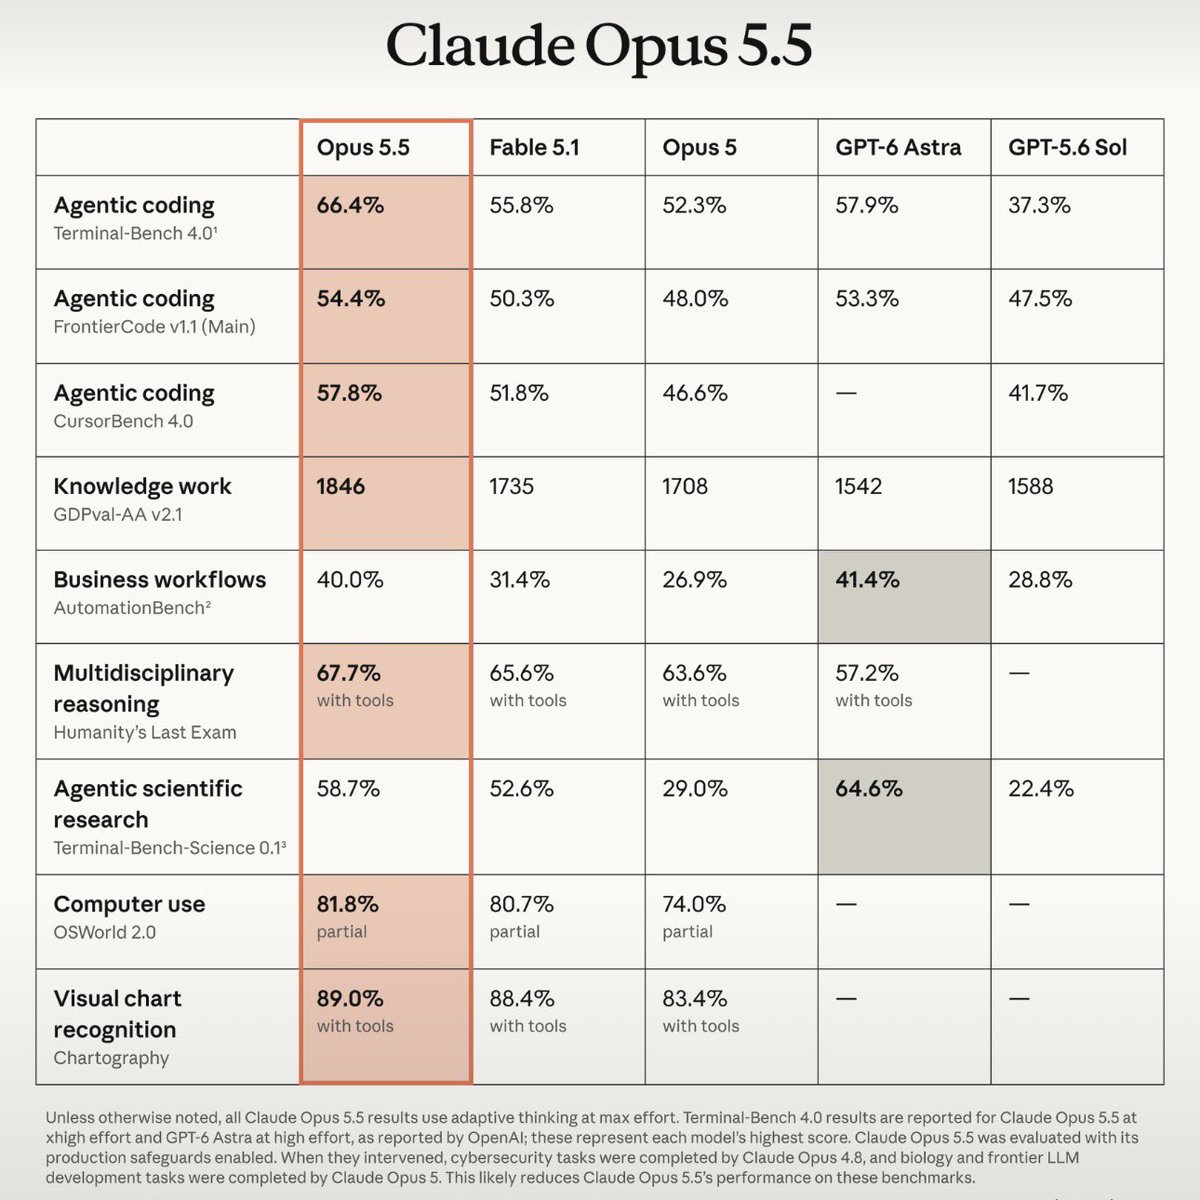
Anthropic 发布 Claude Opus 5.5,这是 Claude 5.5 家族的第一款。官方说多数工作接近 Fable 5.1,典型负载的运行成本比 Opus 5 低 40%。输入 4 美元,输出 20 美元,缓存读取 0.20 美元。后一项比 Opus 5 低 60%。Terminal-Bench 4.0 为 66.4%,FrontierCode v1.1 主榜 54.4%,OSWorld 2.0 部分得分 81.8%。发布前由 Frontier Design 和 METR 做过外部测试。生物和网络安全能力被官方放到 Mythos 5.1 一档,所以沿用更严的防护。Sonnet 5.5 和 Haiku 5.5 还没发。思考模式不能关掉,快速档大约快到二点五倍,输入 8 美元、输出 40 美元。
3. GPT-6 提示缓存默认命中更高,并新增诊断面板
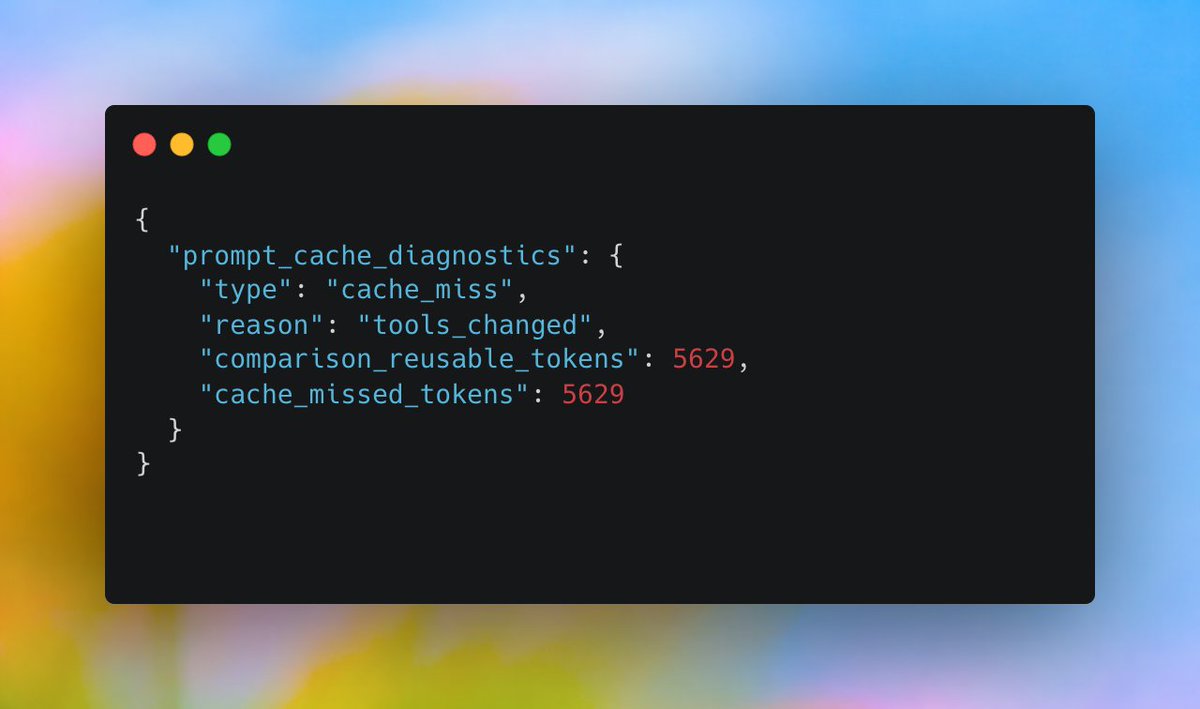
OpenAI 为 GPT-6 改进了提示缓存。符合条件的共享前缀在 30 分钟内复用,缓存输入最高可打九折。新的 Prompt Caching 面板显示命中率,以及缓存和未缓存 token 的构成。诊断接口会指出未命中原因,例如工具变了,并估计受影响的 token 数。GPT-6 上可以追加 configuration_update 来改推理力度,而不必改请求级设置,从而保住已有前缀。工具定义应保持稳定,再用 allowed_tools 限制当次可调用的工具。应用也可以在用户提问前预热说明、工具和参考材料。
来源:@OpenAIDevs
4. Exa 上线 Snapshot,智能体可按指定日期检索过去的网页
Exa 发布 Snapshot,可按日期返回当时的网页。官方称背后有超过 4000 亿个网页快照,时间跨度约 20 年。用途之一是防评测泄漏,六月写的任务如果九月才训练,搜索智能体可能直接找到已经公开的答案。把 snapshotAsOf 设到五月,这些答案就不会返回。金融回测也是同一问题。股价有时点数据,网页没有。Snapshot 仍是研究预览。搜索和内容接口都支持这个参数。完整索引、速率限制和零数据保留要另谈。
来源:Exa Snapshot
5. Grok 语音转写 2.0 发布,同价称准确率约为上代两倍
SpaceXAI 发布 Grok Voice Transcribe 2.0。官方称真实场景评测里它是目前最准的转写模型之一,准确率约为 1.0 的两倍,价格不变。批量转写每小时 0.10 美元,流式每小时 0.20 美元。说话人分离、时间戳和关键词都包含在内。它基于 Grok Voice 的音频基座,已用于每天数万通客服电话、数百万小时视频,以及 Tesla 里的 Grok。短句多语词错率从 20.6% 降到 6.8%。公开榜上,它在 32 个流式模型里准确率第一。Atlassian 称 Loom 会用它转写,再把文本送进 Cursor 改代码。1.0 将在数周内弃用。
6. 智谱用 GLM-5.3 智能体搭好十万加速器推理栈
智谱写了一篇推理基础设施复盘。GLM-5.3-Flash 的生产推理跑在超过 10 万个国产加速器上。显存和带宽有限,还要支持新架构、100 万上下文和多模态。大量工作由 GLM-5.3 驱动的 Infra Agent 完成,不是只靠基础设施工程师。模型从适配到可生产用了不到两周,端到端吞吐约为初始基线的三倍。它曾以 Ox-Alpha 在 OpenCode 和 OpenRouter 上测试,六天处理超过 62 万亿 token。文章把这称为递归自我改进的早期例子,但写明目标、边界和风险仍由人定。帖子里的 Google Research 说法不在这篇正文里,这里不采用。

来源:Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure
Tutorial
1. Opus 5.5 使用说明,先交完整任务并删掉刻意思考提示
Addy Osmani 在 claude.dev 写了 Opus 5.5 的用法。第一次会话先做三件事。把整个任务一次交出去,写明完成标准,以及何时停下来问。删掉“仔细想”和“逐步思考”,因为模型每次回复前都会自己决定想多少。长任务结束时,先看它还要你做什么。Claude Code 里可以在运行中追加要求,不必重开。长任务建议把清单放进文件,因为上下文压缩后滚动记录会丢。设计任务要列出不想要的具体样式,泛泛说“别太普通”只会换成另一种默认。子智能体返回后要先核证据,再收进总表。
来源:Getting the most out of Opus 5.5 in Claude and Claude Code / claude.dev
2. 浏览器扩展用 Jev 跳过 YouTube 口播,时间戳由代码计算
Sponsor Skip 是一个 Chrome 扩展,用来跳过 YouTube 口播。Jev 只负责指出字幕行,或对听到的内容回答是或否。时间戳由代码计算。默认 Transcript 模式读字幕,只在 YouTube 提供字幕时可用,每小时观看成本不到 1 美分。Smart 模式用字幕找出口播,再只在附近听音频。若开始后 12 秒仍未确认,就按字幕跳过。Listen 模式不看字幕,把音频流给 Deepgram。后两种模式大约每小时 0.05 美元,需要 TypeSafe 和 Deepgram 密钥。还有一个网页,可以对粘贴的链接做同样的事。
Opinions/Thoughts
1. Simon Willison 对比三款新模型的价格和鹈鹕测试
Simon Willison 把同一天的 Opus 5.5、GPT-6 Sol 和 Luna 放在一张价格表里。GPT-6 Luna 为每百万 token 输入 0.10 美元、缓存输入 0.01 美元、输出 0.50 美元。Sol 为 2 美元、0.20 美元和 10 美元。Opus 5.5 为 4 美元、0.20 美元和 20 美元。他指出 GPT-5.6 十一月还有 25% 的计划涨价,所以新价格是相对促销价再降一半。Opus 5.5 在 max 档画鹈鹕时两次都顶到 12.8 万输出上限,每次约 2.56 美元,近 20 分钟,没有返回图。Fable 5.1 的 max 档没有这样中断。他已把 Codex 和 Claude Code 的默认模型换成 Sol 和 Opus 5.5。
2. 作者统计大模型发布间隔,从七十三天缩到十八天
Christian Elton 称,主要模型发布的间隔在缩短。他给出的数字是 2023 年大约每 73 天一次,2026 年到目前为止大约每 18 天一次。计数方法在图里,正文没有定义什么算一次主要发布。所以这是作者的统计,不是机构数据。即便口径有出入,方向和这周的发布密度一致。同一周里已经连续出现 Grok 4.7、MiMo、Opus 5.5、GPT-6 Sol 和 Luna。间隔变短以后,单次榜单更难作为长期选型依据。具体日历仍要等他的图被逐项核对。