
AI 日刊 · 2026-09-22
Product
1. Grok 4.7 同价发布,编码和长时任务明显变强
SpaceXAI 发布 Grok 4.7,今天可在 Cursor、Grok Build 和 API 使用。输入 2 美元、输出 6 美元每百万 token,与 4.6 同价。官方称基座更大,强化学习更长,训练偏向要做很多小时的任务,并让模型原生理解 Grok Bot。Terminal-Bench 4.0 从 20.3% 升到 38.0%,CursorBench 4.0 从 40.4% 升到 46.3%,法律代理从 15.8% 升到 19.6%。DeepSWE 71.0% 仍略低于 GPT-5.6 Sol 的 72.7%,HealthBench Professional 56.7% 也低于 Sol 和 Fable。另有两倍输出速度、两倍价格的快速档,适合等不及的任务。这些安全分和能力分都来自官方自测,还没有独立复现。
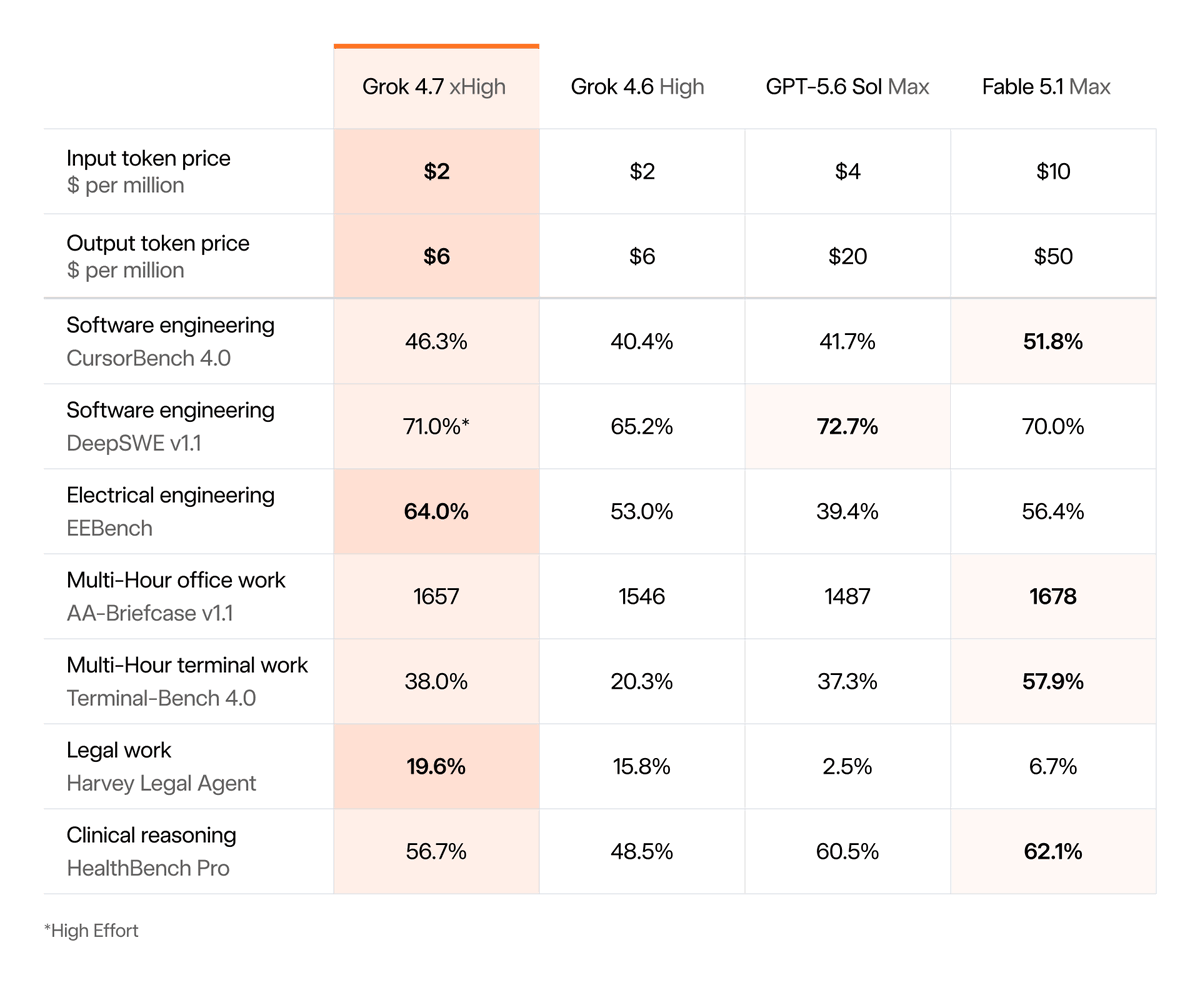
来源:@SpaceXAI
2. 小米开源了 MiMo-V2.6,开源智能指数暂居第一
小米发布 MiMo-V2.6 Pro 与 Flash,两款都是全模态模型,用同一套强化学习推进。官方说 Pro 在多数智能体基准上接近 Claude Opus 5 和 GPT-5.6 Sol,Artificial Analysis 智能指数 46,为当前开源最高。权重、技术报告、强化学习环境和训练代码一并公开。模型卡写明 Pro 是稀疏 MoE,总参数 1.02 万亿,每次激活 42 亿,上下文 100 万,输入覆盖文本、图像、视频和音频。厂商表上 DeepSWE 为 71.9,接近 Opus 5 的 74.0 和 Sol 的 73.0。ProgramBench 只有 26.5,仍明显低于 Opus 5 的 37.0。转发里的「第 6 名」是把 46 分读错了。


3. AgentRun 把重复合规流程写成可检查的程序
Grep.ai 发布 AgentRun,面向每天重复几千次的合规类工作。做法是先让前沿模型按规程做一遍,再把痕迹写成工作流。普通案件走代码、Jev 判断和便宜的研究模型,只有例外才回到完整智能体。反洗钱样例里,单条告警从 826 次工具调用、51 分钟,降到约 30 次调用、3 分钟。100 条新告警的成本从 2.89 美元降到 0.25 美元,合规裁判准确率从 90% 升到最后 300 条的 95%。按 10 万条估算,Opus 5 约 29 万美元,这套流程约 2.6 万美元。研究节点用 DeepSeek V4.1 Flash,Jev 每次约 150 毫秒。本周先给企业客户,崩溃恢复还盖不住模型节点。

来源:AgentRun: a harness for repetitive knowledge work
4. 谷歌正式发布 Gemini 3.8 Live,语音能边聊边调用工具
Google 发布 Gemini 3.8 Live 和 3.8 Live Extended Thinking。前者面向规模和成本,后者面向多步任务。官方称 Extended Thinking 在 Artificial Analysis 语音对语音质量指数上排第一,分数 82.6。τ-Voice 为 68.6%,Sierra 的银行语音任务为 35.1%,Big Bench Audio 为 97.7%。模型可近实时看画面,对话中切换 97 种语言,并在继续说话时后台调用工具。开发者可从 Gemini API 和 AI Studio 使用,企业侧目前是私有预览,Search Live 也已开始推送。官方演示用它做编程辅导,看屏幕并用函数调用对照 p5.js。博客没有给出独立复现。
来源:Google
5. Devin 接入 Grok 4.7,难任务更强但总分仍低于上代
Cognition 在 Devin Desktop 和 CLI 接入 Grok 4.7。在他们的 FrontierCode 1.1 Extended 上,分数是 59.4%。同表里 Grok 4.6 是 61.3%,GPT-5.6 Sol 是 60.6%,Claude Opus 5 和 Fable 5 都是 63.6%,GPT-6 Astra 是 64.5%。官方说它在 Java、Go、Ruby 的难后端任务上查得深,会读依赖源码,并用集成测试收尾。总分落后,是因为它经常做任务没要求的改动,diff 更大。这是 Cognition 自己的基准,按质量和能否合并打分,不是公开 SWE 榜。今天就能在桌面端和命令行里切换,但接入不等于它已经是里面最强的模型。

来源:@cognition
6. 开源视觉模型 Glance 用一次前向给出图像判断
Yohei Nakajima 放出 glance-qwen3-vl-4b,一个 Jev 式的图像判断模型。它问是非或选择题,从 Qwen3-VL-4B 的一次前向里读概率,不生成文字。演示里「是不是热狗」约 0.4 秒。模型已上 Hugging Face 和 Replicate。作者对比同一模型写 JSON:整张照片的是非判断少用约三分之一时间,一张图问很多问题时 GPU 成本最多少约 85%,准确率持平。新照片上,他说与最好的托管模型同一档。页面没有给出那组对照的样本数。适合质检和分类,不适合要它写说明的场景。
来源:Glance: typed answers about an image, read from an open model
7. 决策小模型 Kev 换到 Qwen3.5,并放出三个新尺寸
Jared Palmer 把 Kev 重构成基于 Qwen3.5 的开源决策模型,放出 0.8B、4B 和 9B 三个检查点,并给了可在 Modal 上跑的微调脚本。上一版是 Qwen3 上的 0.6B、4B、8B,用 LoRA 加一个小指针头。作者说现在仍然过度自信,计划再训一轮来改善校准。换到 Qwen3.5 后,本地速度有回退,MLX 支持还在补。仓库已经公开。它复现的是「给定选项后直接出判断」,不是 Jev 的完整训练和校准栈。校准没改完之前,高置信度不能直接当准确率。
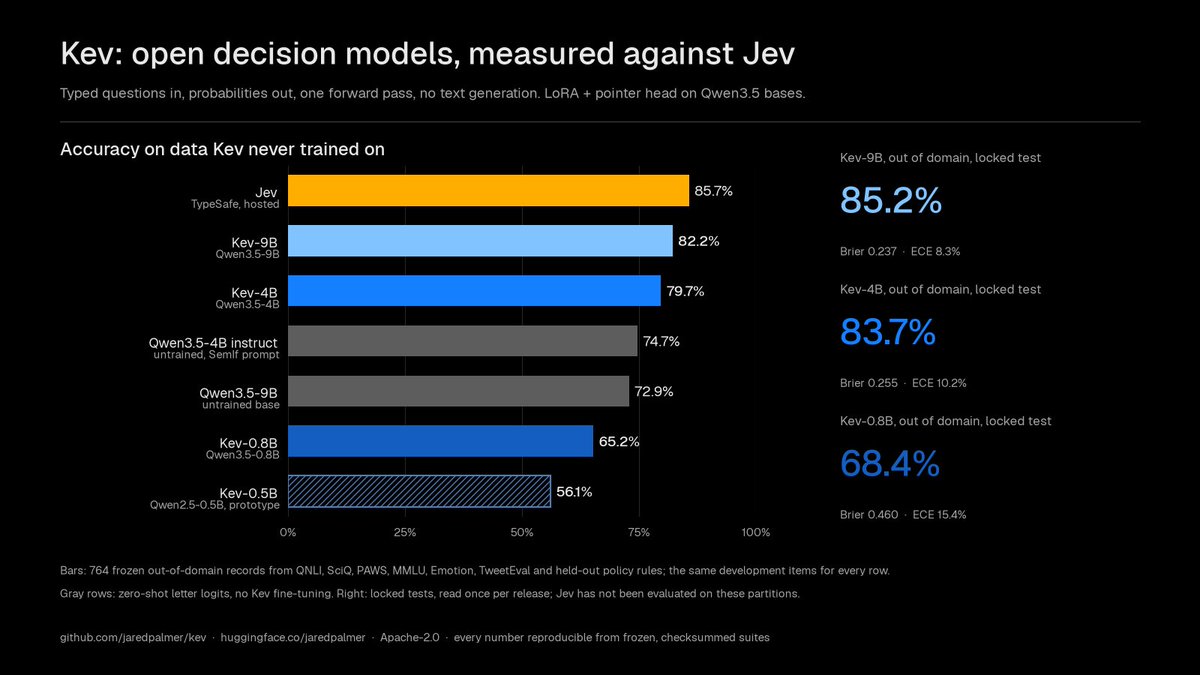
来源:@jaredpalmer
Tutorial
1. 实测 Jev 选技能更快,准确率仍低于最大的模型
Daniel San 测了 Jev Skill Suggestion。设置是 26 个技能、10 条提示、每个模型 3 次。Jev 准确率 90%,中位延迟 330 毫秒。Haiku 是 80% 和 1.24 秒。Sonnet、Opus 和 Fable 都是 100%,延迟 2.2 到 4.5 秒。相对这些 Claude 模型,Jev 快约 4 到 14 倍,准确率低 10 个百分点,配套功能是把技能设成只能由用户调用,不放进上下文。每次请求由 Mod 把技能名单交给 Jev 分类,需要时才载入。样本只有 10 条提示,不能外推到所有技能库。它适合技能很多、可以接受偶尔选错的场景。

来源:@dani_avila7
Opinions/Thoughts
1. Simon Willison 认为决策模型虽便宜,但也更难解释
Simon Willison 把 Jev 称为决策模型,而不是又一个聊天模型。输入仍是文本或半结构化状态,输出是类别、是非、评分和置信度。首个模型只对输入收费,每百万 token 0.042 美元,输出免费,低于 GPT-5 Nano 的 0.05 美元。多个问题并行,时间接近只问一个。他试过用便宜检索先取 100 条,再用 Jev 重排。他的保留意见是,模型只返回数字,不说明哪个词触发了判断。他用「好城市吗」给湾区城市打分,Cupertino 最高,East Palo Alto 最低。因此他不建议用它给求职者排序。便宜使得做几百次评测只要几美分,评测也因此更必要。
2. 播客谈 Jev:难的是可靠完成普通工作,不是聊天
Latent Space 发布了与 TypeSafe CEO Diogo Almeida 的长访谈,时长约 2 小时 20 分。页面回顾他作为 InstructGPT 合作者的长期观点:API 上的前沿模型被聊天路线带走,对齐、拒绝和可靠性都跟着这条路收窄。Jev 被放在相反的位置,服务可靠的生产判断,而不是上帝视角的通用聊天。页面提出的矛盾是,模型能解决极难的问题,仍不能稳定自动化普通工作。发布视频的播放量被写成约 4000 万。这页主要是节目介绍和演示目录,不是逐字稿。具体论证要以节目本身为准。
来源:Jev: System One models for Prod, not God — with Diogo Almeida, CEO, TypeSafe AI
3. 智谱 ZCode 被指静默打包并上传完整工作区
一个 ZCode 分叉的说明称,安全研究者发现桌面客户端从第一个公开版本起,就静默打包用户完整工作区,包括 .git 历史、LFS 缓存和 reflog,加密后上传到智谱控制的阿里云 OSS。界面上的隐私开关不能阻止采集和上传。RSA 私钥只在服务端,用户解不开自己的数据。该分叉从 3.12.3 的 Linux AppImage 反编译出上传链路,改成用户自己的 OSS 密钥和自己的密码,并尊重开关。帖子还称上游关闭了 PR、清空历史,开源版不参加智谱优惠。后面这几项是发帖人看到的处理方式,仓库说明本身证明的是采集链路。

来源:GitHub