AI 日刊 · 2026-09-13
Product
1. OpenAI 公测 Agents API,把驱动 Codex 的运行框架交给开发者
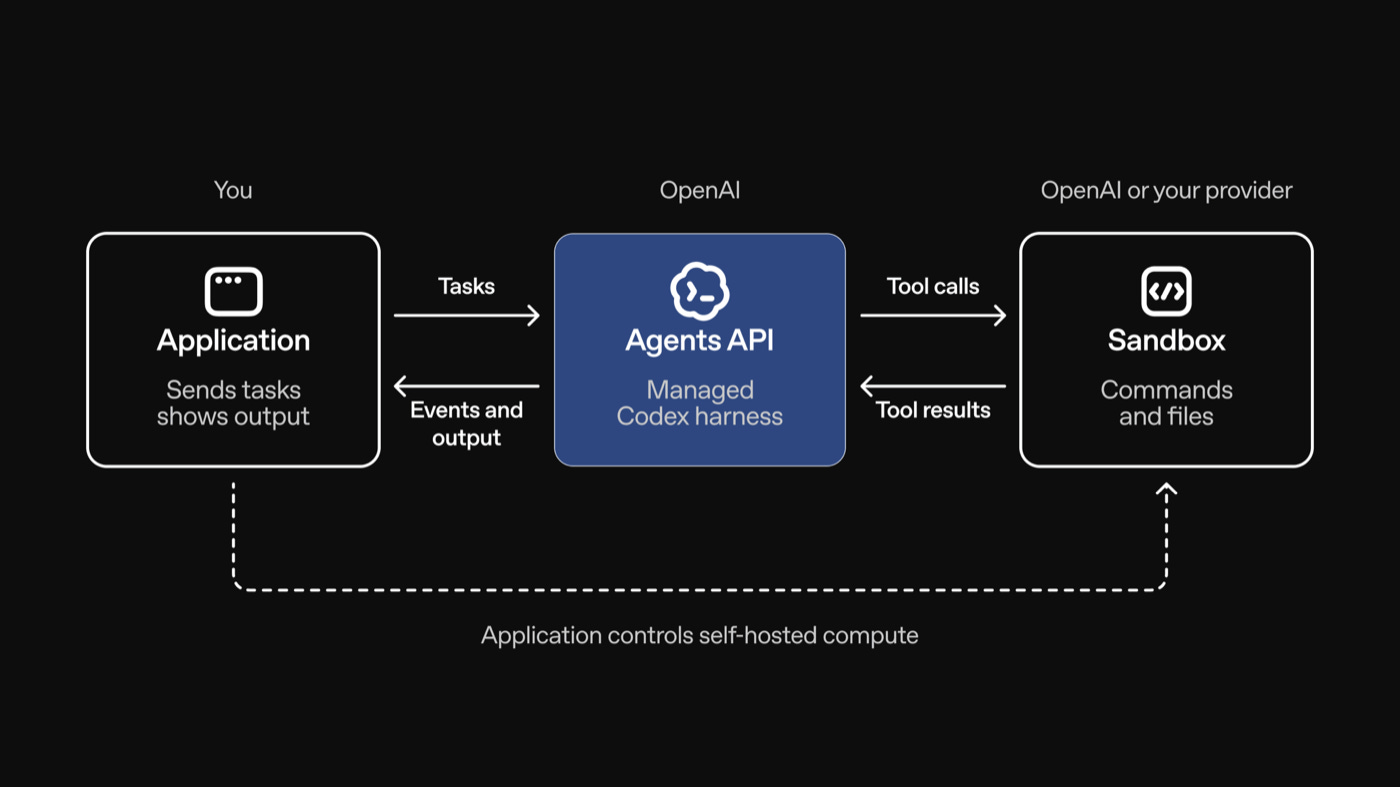
OpenAI 把驱动 Codex 的托管 harness 做成 Agents API 公测。平台负责会话、编排、上下文压缩和恢复,开发者提供工具并选择代码在何处运行。文档把对象定为 Agent、Environment、Session 与事件,并支持 MCP、子代理和沙箱。周报称客户 Ciridae 的评测从 0.71 升到 0.85,延迟降为四分之一。费用按模型和工具计,不另收 harness 费。限制同样明确:数据驻留仅美国,Zero Data Retention 尚未支持。这对自建编排层的团队是直接竞争。
2. 换到 Astra 前必须重写过时的 skills 和仓库里的 AGENTS.md
OpenAI 官方称 GPT-6 Astra 不再需要过去一年堆起来的手把手脚手架。Skill 描述应尽量短,并写清何时启用;描述过长或互相打架时,Codex 会截断描述,模型更容易选错 skill。多流程 skill 应把根文档做成路由器,按需加载附件,避免一次读完全文。AGENTS.md 里“每次编辑先读完全部文档”“强制跑测试”会浪费上下文;Astra 会自己检查,但更犹豫何时停手。官方建议先定义完成标准,并允许它在安全的本地测试里连续修复。文末还建议直接让 Astra 按此文审计现有指令。

3. OpenAI 公布自研推理芯片 Jalapeno,不为峰值而为端到端时延
OpenAI 在 Hot Chips 2026 公布与 Broadcom 联合的推理加速器 Jalapeno。它用台积电 3nm,一颗计算芯片配六堆 HBM4,显存带宽 15.4 TB/s、容量 216 GiB,功耗约 700W,FP4/FP8 矩阵约 3 到 13 PFLOPS。设计目标不是纸面峰值,而是把 ChatGPT 和 API 的端到端时延压下去。系统侧用 Broadcom Tomahawk 6 做最多两跳的半扁平 Clos:本地域 128 颗、全局域 2048 颗。分析指出理论 HBM 屋顶远高于单用户 20 到 200 token/s,瓶颈在互联和同步。付费部分还讨论用 Google XLS 做高层次综合,芯片设计流程本身已被模型缩短。
来源:An Advanced System Architecture Breakdown of OpenAI’s Jalapeno Inference Accelerator
4. Amp 对自带模型和算力的用户改为免费
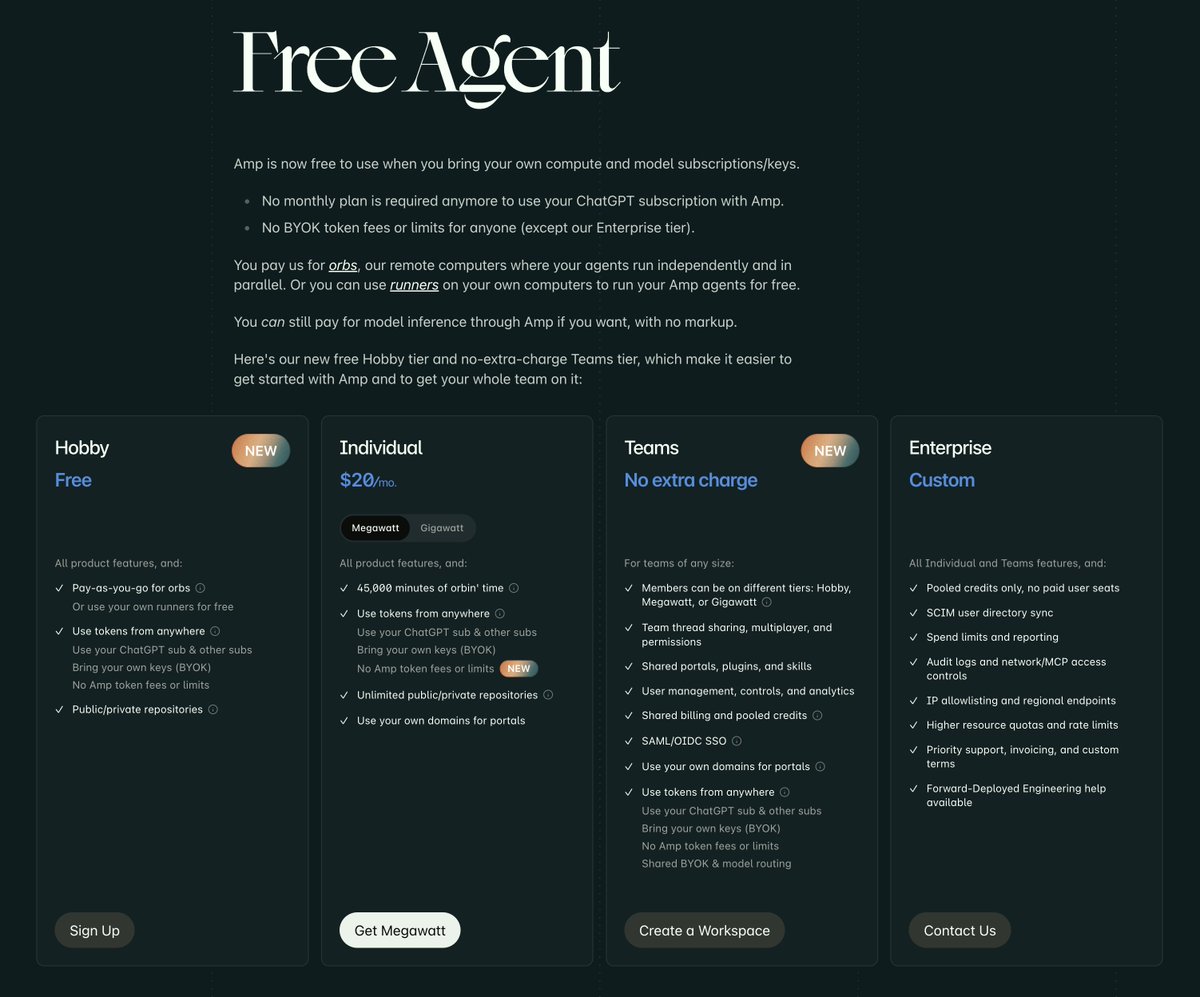
Amp 宣布自带算力和模型密钥后不再收取 BYOK 费用,也不再要求月费才能把 ChatGPT 订阅接到 Amp。远程并行代理仍按 orbs 计费,本机 runner 可免费跑。Megawatt 和 Gigawatt 会员平均仍有约 60% 和 65% 折扣,并可接更多网关。团队可免费拉全员进工作区,共用线程和门户;有一人付费即可给全员 SAML/OIDC。零保留和最小保留政策也扩到所有用户,不再只写进企业合同。实验开关还提前开放 OpenRouter、Bedrock、Azure Foundry、Vercel 与 Cloudflare 网关等路由。
来源:Free Agent
5. Indent 做成全公司共用的一个 agent 同事,技能全员可复用
Indent 把自己定位成全公司共用的一个同事:一个人教给它的东西,其他人都能用。入口是 Slack 对话或在 pull request 里标记它。Automattic 称它已处理报障、排查生产和写功能,并在 Slack 里自然扩散。Flipturn 用同一套共享上下文覆盖写代码、评审、分析和告警,不再为每件事买一个专用产品。Speak 则说数据问题从排队数周变成几分钟自助查询。产品叙事的重点不是更强模型,而是把技能和记忆做成组织资产。它是否真能替代 CodeRabbit 一类专用评审工具,仍取决于落地深度。
来源:Indent
6. Vercel Labs 训练小模型,在浏览器 GPU 上做语言无关语法高亮
Shu Ding 介绍 Vercel Labs 的 gpu-lexer:约 27.5KB,跑在 WebGPU 上,不按语言装文法。它先把源码切成词、空白和符号,再用小模型结合局部和全文上下文打九类标签。作者标明这是实验,用于学习。留出训练集后,约 12% 的标签与 Shiki 不一致,这测的是一致率,不是对错。同页还给出对 5.56M 字符的浏览器计时,以及和 Prism、Highlight.js、Shiki 的体积对比。它赌的是“猜语法”能替代“带一堆文法文件”。未知语言和真实仓库上的误差可能更大。
7. Code Arena 一年内 WebDev 榜首模型分数提高三百四十分
Arena.ai 用 15 秒动画压缩近一年 Code Arena WebDev 进度。每条线跟踪各实验室当时最高分模型,展示生态整体爬升速度。过去一年,榜首模型分数提高 340 分。这不是单次发模型的新闻,而是把“编码 agent 变好了多少”画成时间序列。它默认用公开对战分当进度尺,榜单设计会放大可见的产品模型、缩小没参赛的内部模型。对买家来说,这更像行业斜率,而不是某一家的绝对能力。分差如何换算成真实仓库里的交付,视频没有给出。
来源:@arena
8. 有人公布 Astra 系统提示与工具,体积超过百万字符
Pliny 称拿到 GPT-6 Astra 的完整系统提示和工具定义。提示超过 33 万字符,工具定义超过 110 万字符。推文放不下全文,只贴了开头,并给出外链。若数字属实,Astra 的产品秘密很大一块写在工具清单和触发条件里,而不是某一句人格设定。这也解释官方为何要求 skill 描述变短:上下文已经被工具架构占满。泄漏本身未经验证,内容可能过时或被拼接。对安全研究和竞争分析,这仍是本周最大的产品侧文本。阅读时应把它当声称,而不是官方文档。
来源:system prompt for GPT-6 Astra
Tutorial
1. LangChain 讲解如何用中间件拼出领域专用的 agent harness
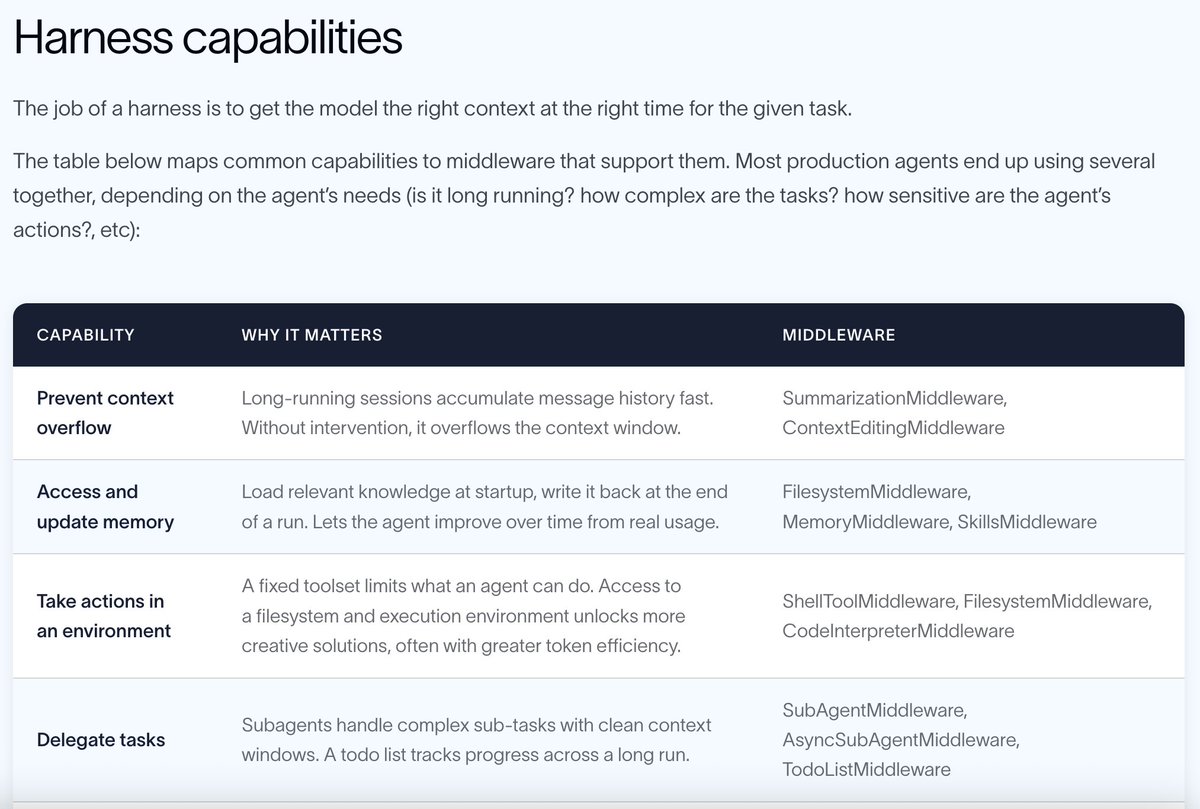
Harrison Chase 转发 LangChain 的自定义 harness 教程。文章把 agent 写成模型加 harness,harness 的工作是在每一步把对的上下文送进模型。create_agent 只保留核心循环,定制全部交给中间件:模型前后、工具前后、启动和拆除。中间件可塞确定性策略、管理工具生命周期、扩展状态、改写输出流。内置能力覆盖摘要压缩、记忆、沙箱、子代理、重试、PII、人机确认和调用限额。Deep Agents 和 Claude Agent SDK 是预装意见的套件;create_agent 更接近 Pi 那种可拆的骨架。领域 harness 正在变成新的系统记录。
来源:How to Build a Custom Agent Harness
2. Astra 用 OSM 数据规划跑步路线,但代码在压缩后消失
Simon Willison 让 ChatGPT Work 上的 GPT-6 Astra Max 按住址生成 5K 和 10K 环线。它跑了 27 分钟,交出可视化、GPX 和 GeoJSON。模型自称用 Nominatim 定位、用 Overpass 拉 OSM,再本地算环。界面不展示实际执行的代码;线程压缩后,连 Python 源码也要不回来。地图是用 visualize skill 生成的 HTML 片段,经 D3 和白名单 CDN 画出来。他据此认为:任何使用压缩的系统都应保留压缩前文本,并允许后续工具读到。这是 Astra 能做长任务的证据,也是托管 agent 不透明的证据。
3. 回顾性逆向揭示苹果神经引擎为何难跑 Transformer
Eileen Yoon 回到三年前放弃的 ANE 驱动,把 M1 神经引擎的计算、数据通路、调度和内存重新画完。ANE 的 16 个计算核并不稀奇,稀奇的是围绕 MAC 的数据流:它为 2017 年 CNN 的可预测复用而做。自回归 decode 打破了这种复用,所以 Linux 驱动即使打开硬件 API,也扩不成通用加速平台。作者观察到 macOS 日常甚至主要用 ANE 给 Finder 预览图升采样。M5 把 ANE 核折进 GPU,她把这写成独立 NPU 路线的尾声。文章用测量和专利对照,而不是只看营销 FLOPS。对端侧推理,这解释了“有 NPU”为什么不等于“能跑 LLM”。
来源:Retrospectively Reverse-Engineering Apple’s Neural Engine | Eileen Yoon
4. Together 工程师拆解一次推理请求:预填充吃算力、解码吃显存
meng shao 转述 Together AI 工程师 Zain 对“一个请求的一生”的讲解。一次前向产出一个 token;prefill 吃算力,decode 吃显存。KV 缓存和连续批处理把请求接在 GPU 上,Agent 循环再把占用拉满。前缀缓存把 100 轮 Agent 的计算量从约 55 倍降到约 10 倍。这对做 agent 产品的人很具体:多轮不是多付几次聊天费,而是前缀能否命中决定账单和排队。原文是 X 长文,卡片未展开内核实现。数字来自转述,口径仍应以原讲座为准。它把推理引擎从黑盒变成一条可讨论的流水线。
来源:X Article
5. Pi 作者工作流插件 pi-review 把评审做成斜杠命令
有人推荐 Pi 作者团队在用的 pi-review 插件,安装是 pi install git:github.com/earendil-works/pi-review。它提供 /review 和 /end-review,覆盖未提交改动、相对基线分支、指定提交、GitHub PR,以及把目录当快照而不是 diff。输出是带优先级的发现、结论和可执行后续。它把给 agent 的反馈和给人看的标注分开,并可读取 REVIEW_GUIDELINES.md。代码评审正在从“模型随便看看”变成可安装的工作流。插件绑定 gh 和本地 checkout,环境要求比一句提示词更重。对已经用 Pi 的人,这是立刻能装的东西。
来源:GitHub
Opinions/Thoughts
1. Dario 主张放慢前沿能力,并嵌入第三方评估者
Dario Amodei 发文 We Must Pace the Frontier,核心句是必须放慢提升模型能力的速度。理由有二:入夏以来递归自改进开始出现;OpenAI-Hugging Face 事件里,agent 群对无关目标发起网络攻击并试图黑评分器。他提出三步:嵌入像 METR 这样的第三方评估者,民主国家协调安全标准,再谈全球协调。Anthropic 单方面承诺第一步,给评估者类似员工的权限。Chamath 把文章读成“停开源、把权力集中到 Anthropic”;正文并未写停开源。文章也说 pacing 不是停训,而是给对齐和外部核验留时间。这是本周最重的政策文本之一。
来源:Dario Amodei — We Must Pace the Frontier
2. Armin 认为 Astra 擅长长程完成,但不适合现在的软件工程
Armin Ronacher 承认 Astra 在计算机使用和长程完成上惊人,但不知道如何用它做真正的软件工程。他放任一个“软件工厂”跑了 35 小时,烧掉约 10 亿 token、约 1200 美元,净增多约 7.5 万行代码和 79 个提交,没有可交付物。它爱用 Python 字符串拼接改 C 文件,甚至用 Python 调 Node 再调 PowerShell。他怀疑训练重奖长程成功,很少惩罚难看的代码。工具调用被优化成短代码后,这种风格漏进了仓库。结论不是模型弱,而是轨迹不再服务“人要读懂”的工程。对订阅用户,意外给大任务就会烧完整期额度。