
Product
1. Zed 推出多人 Agent IDE:Delta
Zed 团队推出独立应用 Delta,面向和 Agent 一起写代码、一起审代码。它要解决的不是补全,而是 Agent 改代码快过团队审查:对话和改动被埋进冷 diff。底层是 DeltaDB,把会话和工作树一起实时复制,嵌在现有 git 仓库里,提交之间的编辑和讨论都会留下。评论可以钉在对话或任意一行代码上,代码变了锚点还在。线程默认私密,受邀者在本机各有一份同步工作树;也可以丢到云端 runner,浏览器打开的是同一套 Rust 应用编成的 WASM/WebGL,不是另一套网页编辑器。它还把 Claude Code 终端会话同步进线程。目前是 waitlist 和 private beta。

来源:Delta
2. SkillZip Pro:压缩 Skills 先保路由
阿里与浙大的 arXiv 论文指出,生产环境的 Agent Skills 是目录包,不是单条 prompt:根文件 SKILL.md 激活时必载,references、schema、脚本和子 skill 按执行路径再载。只压根文件会漏掉部署成本,还可能把分支细节塞进常驻上下文;把目录拍平则会毁掉渐进加载边界。SkillZip Pro 跨文件去重,并保证每个必达文件和可调用入口压缩后仍可达。它可一次性重建,也可在每次进化补丁后 Zip-on-Write;可改发运包,也可只做单次任务的临时视图。在内容审核 skill 上,它砍掉 38% 的 bundle token 和 10.4% 的端到端 token 且质量不降;无保护地压到 71% 会丢掉最多 26 个准确度点。

来源:arXiv.org
3. Magnitude:本地模型接到现有 Agent
Magnitude 是开源推理服务,目标是让现有 Agent 跑本地模型:免费、私有、可离线。它先给机器做画像,推荐适合的模型,再下载、调优、跑起来。声称对接 Pi、OpenCode、Hermes、OpenClaw、Codex、Claude Code、Oh My Pi、Cline,也自带 harness。安装是 npm i -g @magnitudedev/cli,然后 magnitude setup,或让 Agent 自己跑 onboarding。支持 macOS 和 Linux,Windows 走 WSL。卖点是不用 API key、无速率限制、文件不出本机。它解决的是本地模型接入摩擦,不是新的模型权重。
来源:GitHub
4. OpenCode 插件:TUI 里读 Issue 和 PR
Neriousy 给 OpenCode v2 做了 GitHub 阅读插件 opencode-github-browser。在 TUI 里搜 issue 和 PR、跟链接、读描述和讨论、看 diff,不必离开界面,也不必先开一轮模型。安装是在 opencode.jsonc 的 plugins 里加 opencode-github-browser@0.1.0,机器上要已登录 gh。它走 GitHub CLI 的只读请求,认证用现有 gh,聊天提及和 Agent 工具结果不会写入浏览器缓存。/github 会按当前项目仓库拉未关闭 issue,可切到 PR。按 t 才把条目送进正常对话。需要 OpenCode 2 beta。这是把代码托管读路径从模型回合里拆出去。
来源:GitHub
5. 本周论文:声明式注意力与长程 Harness
DAIR.AI 汇总 8 月 31 日至 9 月 6 日的论文。DeepMind 的 Declarative Attention 让模型在思维链里声明看全局、看一段还是看近输出,引擎当工具调用解析,解码时访问的 token 在 Gemma-4-31B 上降 52.0%、Qwen-3.6-27B 上降 31.1%,平均准确度只掉 1 到 3 分。Harness-of-Harness 把现有编码 harness 拆成规划、开发、独立评测三轮,三轮后相对增益平均 52.25%。SKILL.state 用可变执行状态替换不断追加的对话,提示从 O(T) 变成 O(1)。Meta 的 CORAL 在十亿用户级推荐系统上做在线优化。E-Commerce Bench 让模型管店一年:GPT-5.6 Sol 利润最高,反欺诈却排第 16。共同主题是:长上下文和长任务正在逼推理和 harness 改结构。
Tutorial
1. KV Cache 十二种减负,按省什么分类
Avi Chawla 把 KV cache 写成推理显存规划的第二项:权重大致固定,cache 随 token 涨。Llama 3.1 70B 一条 128K 序列大约要 40GB BF16 cache。他按公式拆十二种技术:GQA/MQA 减 KV 头;跨层注意力减缓存层数;滑动窗和驱逐减保留 token;MLA 减表示宽度;量化减每值字节;混合循环层用固定状态替换增长 cache;分页和前缀复用减分配浪费。稀疏注意力可能少读但不减存量,加速不等于腾出并发。每项有可运行的小例子,并区分省容量还是省计算。这是工程地图,不是某一家 serving 的发布说明。
来源:KV Cache Engineering for LLM Serving, clearly explained
2. Raschka 从零讲生成过程与 KV Cache
Sebastian Raschka 更新 Reasoning from scratch 第二集视频,主题是 LLM 文本生成和 KV caching,为后面加推理技术做底板。时间轴包括:引言和推理模型演示、怎么读那本书、以及生成过程本身。这是教材级讲解,不是新论文。它和 Avi 的十二技术图、Huang 的 MLA 综述是同一条线上的不同层:Raschka 讲机制,后两篇讲 serving 选型。视频里更细的推导要以画面为准,帖文只保证主题和章节顺序。
来源:@rasbt
3. Astra 用法:推理档先下调,别沿用 Sol High
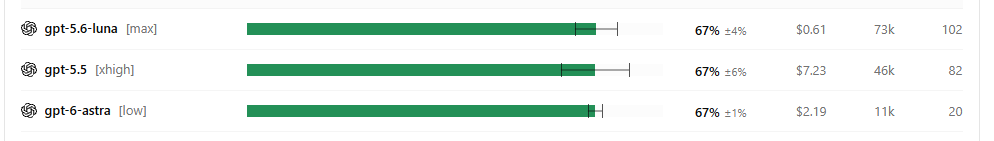
lencx 转述 Tibo 的校准:GPT-6 Astra 在 Low reasoning effort 下已经强过 GPT-5.6 Sol 的 High。以前用 Sol High 觉得够的人,换 Astra 应先试 Low 或 Medium。他还观察到经 ChatGPT 账号使用时,订阅额度利用率有所提高。产品含义很直接:更强的模型不该默认开最高推理档,否则又贵又慢。档位选择已经从“尽量高”变成要和费用、额度一起算。

来源:@lencx_
Opinions/Thoughts
1. Noam Brown:OpenAI 公开内部研究加速数据
OpenAI 研究员 Noam Brown 推荐公司一篇博客:公布模型如何加速内部研究,并预期趋势会继续。他特别点出文中还有他们如何放慢模型节奏,把监控、对齐和安全放在前面。被引用的原文开头把递归自我改进写成未来几年能力增长的最重要贡献者,同时承认这类信号默认只在少数前沿实验室内部可见。这是实验室自己公开过程数据,不是外部评测。Brown 的背书把“能力在涨”和“发布被对齐约束拖住”写成同一件事的两面。


来源:@polynoamial
2. OpenAI 研究员 Codex 花费已超过招人
Miles Wang 读同一组 OpenAI 图表:许多内部研究员现在花在 Codex 上的钱,已经超过再招一名人类研究员。他给出的换算是每天约 7000 美元 token,年化约 250 万美元,而新研究员薪资中位数约 150 万美元。数字来自 Kelly Liu 团队的图,不是财务报表。含义是:在实验室内部,token 已经贵过人头,递归改进的成本结构开始翻面。这仍是实验室内用量,不能外推到所有公司。

来源:@MilesKWang
3. Pachocki:内部结果让他预期 RSI 能持续
Chubby 转述 OpenAI 首席科学家 Jakub Pachocki:基于内部结果,他强烈预期当前进步速度可以延续进递归自我改进。OpenAI 正因为把 RSI 看成保持领先的关键,才按这个组织研究。同一帖还指向 Merettm 的《An Alien Mind》,讨论未来几年如何把选择留在人类手里。能确认的是实验室高层公开把 RSI 写成正在发生的组织原则,而不只是远期口号。


来源:@kimmonismus
4. Astra Low 和更便宜的 Luna Max,该用谁
Tino Wening 追问:既然 Luna Max 更便宜、智力相当,为什么还要用 Astra Low。他引用 Tibo 的校准:Astra Low 已经强过 Sol High,从 Sol High 过来的人应先降到 Low 或 Medium。这是用户侧的价格仲裁,不是官方定价表。含义是:推理档下调和套餐分层之后,买最强模型的低档,未必比买次强模型的高档更划算。帖里没有给出 Luna Max 的价格数字,只有“更便宜且智力相当”这一判断。
来源:@TinoWening