
Product
1. Vercel 发布 AI SDK Python 版,进入公测
Vercel 把原本以 TypeScript 为主的 AI SDK 正式带到 Python,目前已进入公开 Beta。它定位为构建 LLM 应用与 agent 循环的工具包,安装只需 uv add ai;网关与 API key 用法包含在基础包中,而 OpenAI 兼容、Anthropic 兼容等直连 provider 会在用到时按需懒加载官方 SDK,也可通过可选 extra 接入 Vercel OIDC。对于一直苦于在 Python 生态里拼装 agent loop、工具调用与流式输出的团队,这意味着可以与 Vercel 的 TS 侧共用同一套抽象与网关。需要留意它仍处 Beta,API 与依赖结构可能继续变动。

来源:GitHub
2. Voicebox:开源本地语音工作室,对标 ElevenLabs 与 WisprFlow
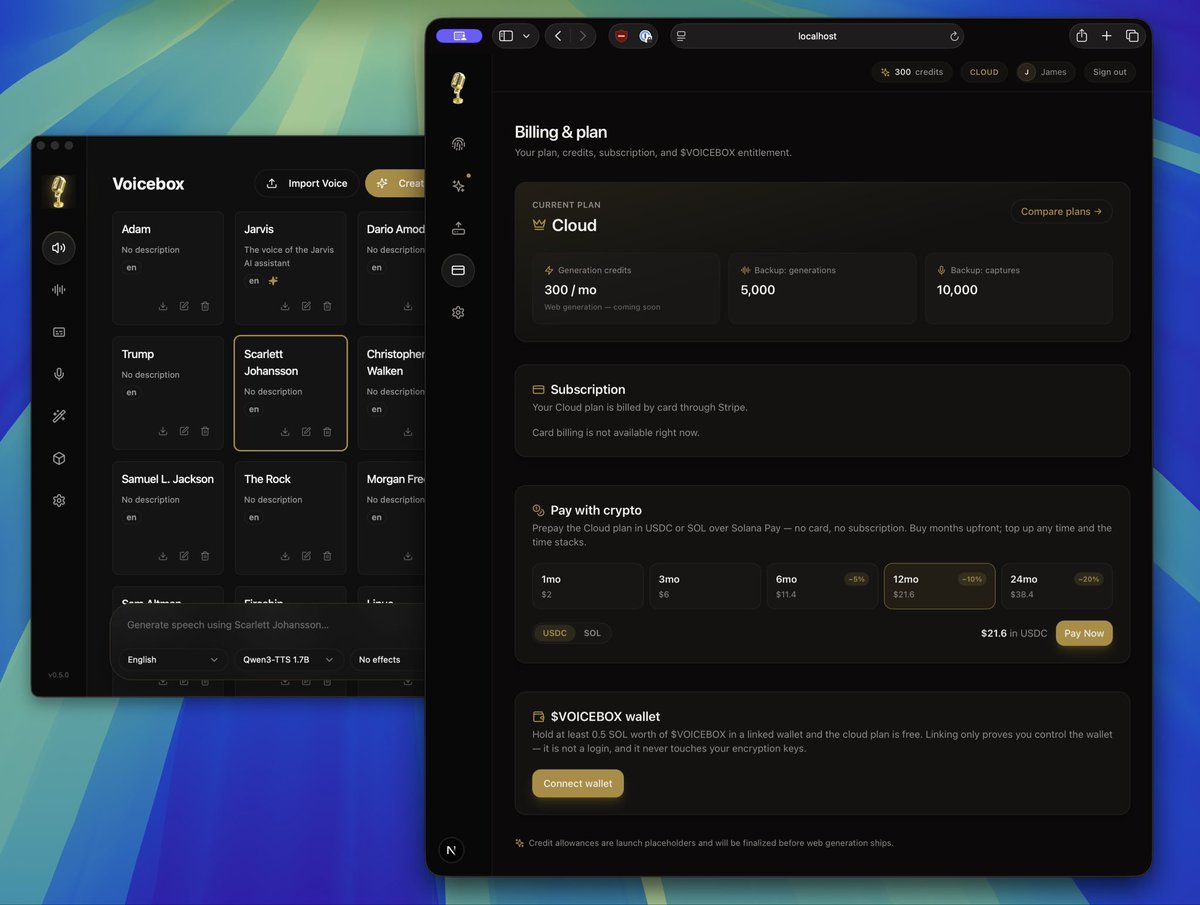
jamiepine 开源的 Voicebox 把“让 AI 说话”和“把你说的转成文字”合进同一个本地应用,定位为 ElevenLabs 与 WisprFlow 的免费替代。它支持用几秒音频克隆声音、跨 7 个 TTS 引擎生成 23 种语言语音,并提供全局热键把语音听写注入任意输入框;对 MCP 感知的 agent 还能赋予你自选的嗓音,整套语音 I/O 栈都在本地运行。作者强调它可与 Claude Code、Codex 等编程 agent 结合,仓库已获 4 万多 star。对不想再把语音数据与订阅费交给云端的开发者,这是一个值得评估的本地化栈。
来源:GitHub
3. PrismML Bonsai:27B 模型压缩到 3.9GB,跑在 iPhone 上
PrismML 的 Bonsai 让一个原本需要机房级算力的 27B 参数模型,能够运行在 iPhone、Android 与 Mac 上:采用 1-bit 权重,27B 参数只占约 3.9GB,据其自评保留约 90% 的全精度质量,并优于占用不到一半体积的 2-bit 版本。Run Anywhere 应用已上架 App Store 作为承载。这把“端侧大模型”的可用门槛进一步压低,意味着更多推理可以脱离云端在本地完成;但 90% 质量与“优于 2-bit”均为厂商自评,缺乏第三方对照,实际抽卡与退化幅度仍需独立验证。
来源:App Store
4. WrenAI:在浏览器里跑语义 SQL,统一业务语义层
WrenAI(Canner 开源)把“语义层”做进了浏览器:你用 MDL 一次性定义好实体、关系、指标口径与访问规则,随后 Claude、Cursor、ChatGPT 或内部 copilot 都通过同一层去查询数据,底层由 Rust 引擎执行。它解决的是多 agent/多工具各自理解业务口径不一致的问题——把“业务建模一次、处处复用”变成显式契约。对数据团队而言,这相当于给 AI 查询加了一道可控的语义与权限边界,而不是任由模型猜表结构和口径。

来源:@hasantoxr
5. Anthropic 调整 Fable 5 限额:7 月 20 日起再降 25%
据 op7418 解读,Anthropic 从 7 月 20 日起会把 Fable 5 的周限额相较当前再下调约 25%,相当于“腰斩”。背景是自 5 月至 7 月 19 日会员限额上浮 50%,即这段时间总量为正常的 150%;促销结束后,Fable 5 的限额实际上只是回归到“原本应有额度”的约 75%。换句话说,此前的高限额是阶段性政策而非新基线。这对重度依赖 Fable 5(在 Claude Code 等场景)的用户意味着需要重新规划用量与订阅档位。

来源:@op7418
6. Anthropic 内测:Cowork 开关换位,Projects 进入侧栏
据 testingcatalog,Anthropic 正在内测新的界面布局:Chat / Cowork 切换开关测试新位置,并把 Projects 收进侧边导航——“你的项目现在有了独立分区,置顶项目会停在顶部”。该变化尚未对公众开放(标注 * Not available to the public yet)。这与近期 Anthropic 把 Cowork、Projects 等概念前置的方向一致,暗示其正把“项目/会话”作为一等公民的组织方式。属于值得关注的 UI 演进信号,但最终形态以正式发布为准。

7. Google 准备把 Gemini Live 推向桌面网页端
据 testingcatalog,Google 正在为 Gemini Live 登录 Gemini 网页桌面端做准备,相关功能近期已进入可信测试阶段。除此之外,预计 Skills 也会进入普通对话可用,更多能力在路上。这意味着 Gemini 的实时语音/多模态 Live 体验不再局限于移动端,而是向桌面工作场景扩展。属于泄露/测试阶段的传闻,具体上线时间与范围以 Google 官方为准。

8. Kimi K3 登顶 DeepSWE 第三,首个开源前沿级编程模型
datacurve 报道,月之暗面的 Kimi K3 在 DeepSWE 编程基准上首秀位列第三,并称其为首个达到前沿级表现的开源权重模型,成绩接近 Claude Fable 与 GPT-5.6 Sol。这意味着开源阵营在“会写代码、会跑工程任务”这条赛道上首次摸到与闭源前沿模型同一档的成绩线,对依赖开源模型自建 agent/编程助手的团队是重要信号。不过单榜单成绩不能等同于综合能力,且存在 benchmark 过拟合的争议(见同期其他讨论),真实工程表现仍需多场景验证。
来源:@datacurve
Tutorial
1. 一图看懂 RLHF、DPO、GRPO 的本质差别
_avichawla 用可视化方式拆解了 RLHF、DPO、GRPO 这三个常被混为一谈的“同类算法”,指出它们其实是“用完全不同方式教模型按你期望行动”,并点明这些差异会直接体现在训练效果上。这是 LLM 面试的高频题,也是理解当下开源模型(如 GRPO 系)为何能低成本对齐的关键。对想从“知道名字”进阶到“能讲清机制差异”的工程师,这条线索值得收藏。具体细节以原帖图解为准。
来源:@_avichawla
2. 递归语言模型(RLM):处理超长上下文的新范式
Amit Shekhar 的这篇文章讲解递归语言模型(RLM):一种处理“超出模型上下文窗口的超长输入”的新思路。文章覆盖了什么是 RLM、为何需要它、它如何工作、模型如何自己写并运行代码、为什么效果更好、RLM 内部的递归、它与简单分块的差别、优势与局限、何时使用,以及 RLM 与 RAG 的对比和一个真实用例。核心区别在于 RLM 不是被动切块再检索,而是让模型以递归方式主动组织与消化超长内容。对处理巨型文档/代码库的人,是值得了解的替代路径。

来源:Outcome School | Get a High-Paying Tech Job
3. 多智能体协作的下一个跃迁:突破“相互试探”瓶颈
dair_ai 解读了一篇关于多智能体探索的论文,指出“AI agent 之间的协调”将是 AI 的下一个跃迁。它点破了一个常被默认的假设——把几个强大的 LLM 放在一起,它们就会自动相互试探、协同——并说明真实的多智能体协作远比这复杂,论文聚焦如何改进这一过程。对在构建多 agent 系统的人,这条线索指向了“协调/探索”这一具体研究前沿。论文细节与方法论以原文为准。

来源:@dair_ai
4. 用 X MCP 工具自建“高信号账号追踪” Skill
omarsar0 分享了他新建的 skill:自动跟踪一批高信号 𝕏 账号,汇总顶级 AI 新闻、论文与项目,并称其“彻底改变了我的信息流”。他用 X MCP 工具构建,把 skill 交给 agent 后让 agent 生成“热门故事”产物,兼容 Codex、Claude、Hermes 等。这示范了“把信息源追踪做成可复用 agent skill”的范式,对想自定义每日信息流的人可直接借鉴思路与实现。skill 的具体账号清单与产物格式以作者发布为准。
来源:@omarsar0
Opinions/Thoughts
1. SemiAnalysis:Kimi K3 的线性注意力对 NVIDIA/HBM 其实是利好
针对“Kimi K3 用线性注意力(KDA)会因 KV-cache 需求较低而利空 NVIDIA、HBM、DRAM 与网络”的恐慌情绪,SemiAnalysis 给出相反判断并解释为何。这与此前 DeepSeek R1 引发的类似恐慌同构——市场常把“效率提升”误读为“需求萎缩”。文章的价值在于把硬件产业链影响从情绪化解读拉回技术基本面:更高效的注意力机制不一定意味着更少的算力与存储总需求,反而可能因更大量级应用释放更多需求。具体论证以原帖与报告为准。

2. 对话月之暗面杨植麟:Kimi K3 发布之际回看 K2
在 Kimi K3 发布之际,zhang_benita 回顾了她与 Kimi 创始人杨植麟早期的一期播客访谈——录制于 K2 发布之后,并感慨过去一年变化巨大。对想理解 Kimi 这家公司思路演进的人,创始人的第一手讲述比模型发布稿更有信息量,能把 K2→K3 之间的战略与技术取舍放在更长时间轴上看。这是一次“借新节点回看旧访谈”的解读视角;具体内容以播客原文为准。
3. 警惕:agent 持久记忆正成为 prompt 注入的攻击面
dair_ai 介绍的新研究聚焦“agent 记忆里的坏数据”:持久记忆是让 agent 跨会话有用的关键,但同时也是攻击者可以“留下东西”的地方。该工作针对 Claude Code 与 OpenAI Codex 的记忆,跨不同模型测试了 prompt 注入攻击。它把一个被忽视的安全问题摆上台面——当我们把记忆/上下文当作资产累积,恶意指令一旦混入其中,会在后续每次会话被反复“信任式”调用。对构建带持久记忆 agent 的人,这是必须正视的威胁模型。

来源:@dair_ai