
Product
1. 月之暗面发布 Kimi K3:2.8 万亿参数、百万上下文的开放前沿模型
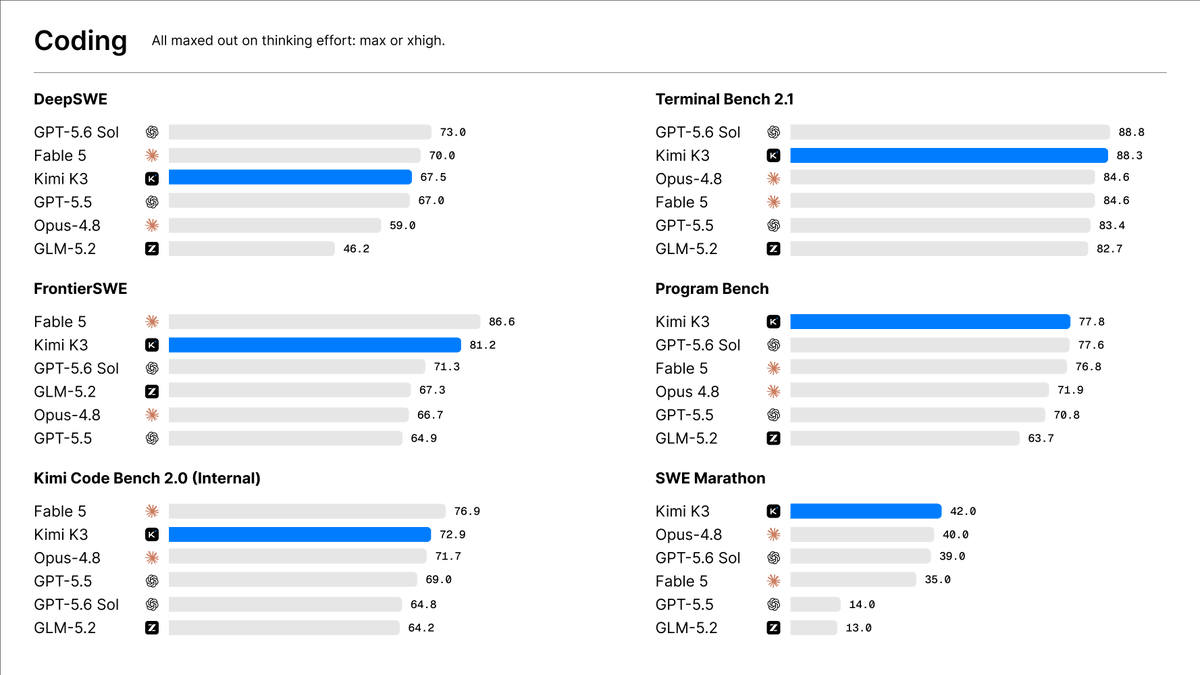
Moonshot AI(月之暗面)正式发布 Kimi K3,定位为其最强模型,规格为 2.8 万亿参数、100 万 token 上下文、原生多模态。技术上引入两项关键设计:Delta Attention 让百万 token 解码速度提升至 6.3 倍;Attention Residuals 以不到 2% 的额外开销带来约 25% 的训练效率提升。模型已上线官网与 API,官方承诺 7 月 27 日前开放权重,并自称首个开放 3T 级模型,意在从 DeepSeek 1.6T v4 Pro 手中接过开放模型榜首。值得注意的是,开放权重日期与自测基准成绩都仍待第三方验证。

2. Vercel Next.js 基准:Kimi K3 首次让开放模型登顶
Vercel 的 Next.js Evals 是一套覆盖代码生成与迁移的综合 Web 工程基准。最新结果中,Kimi K3(经 OpenCode)以 92% 成功率、平均 199.89 秒登顶,与 Claude Fable 5、Cursor Composer 2.5 并列成功率第一,但耗时更短。Rauch 强调这是开放模型首次在该综合基准上超越所有闭源模型。紧随其后的还有 GLM 5.2(88%)、Claude Opus 4.8(88%)、Grok 4.5(83%)。需注意成功率配合 AGENTS.md 后多数模型可达 96%,说明基准对工程配置相当敏感。

来源:AI Agent Evaluations | Next.js by Vercel - The React Framework
3. Claude Code 推出 /code-review ultra:多 agent 云端深度审查
Claude Code 在 high 之上新增 /code-review ultra(研究预览)。它在 Claude Code on the web 的远端沙箱里启动一整支审查 agent 编队,定位并独立复现每一个发现,号称在保持与 high 相同的严重问题覆盖率的同时大幅降低误报,Anthropic 表示内部每个 PR 都跑这套。它支持 CLI 调用、定价与免费额度、跟踪运行中的审查、非交互式运行,并与本地 /code-review、/review 对比。定价与可用性标注为可能随反馈调整。
4. OpenAI 卖硬件了:售价 230 美元的 Codex Micro 键盘
OpenAI 开始卖硬件:Codex Micro 是与 Work Louder 合作的 230 美元键盘,面向整天运行 AI agent 的用户,带一个实体旋钮,用来调节 AI 思考的力度(推理强度)。这是 OpenAI 首次把品牌硬件伸向开发者桌面,意义在于把模型推理强度这类抽象参数物化为物理控件,也为 agent 工作流提供专用外设。一条动态显示该键盘 14 小时内即售罄,说明早期需求超出预期。

来源: https://openai.com/zh-Hans-CN/supply/co-lab/work-louder/
5. Codex 上线 PR Chat:在 PR 上下文里审查与改代码
OpenAI 为 Codex 推出 PR Chat:用户可针对某个具体 PR 向 Codex 提问,并获得处于该 PR 上下文中的回答;内联代码编辑支持把审查意见发给 Codex、在页面内查看建议补丁,并编辑、接受或拒绝。其价值在于把 PR 审查与后续修改收进同一界面,减少在 GitHub 与编辑器间的来回切换。对重度使用 Codex 的团队,这进一步把它推向端到端的代码协作枢纽。
来源:@OpenAIDevs
6. ChatGPT 桌面端更新:历史会话与云项目进侧边栏,聊天模式独立
ChatGPT 桌面应用迎来更新:历史会话与云项目(cloud projects)进入侧边栏;chat 模式不再仅见于 quick chat,而是与 work 模式并列常驻;并修复了一批其它问题。同日工程师 Thsottiaux 也发文承认新桌面端首版没完全做对,正根据大量反馈持续调整。两项合在一起,说明桌面端正从早期粗糙版本向可用工作台收敛,模式区分也暗示了消费级与工作级体验的分野。

来源:@ajambrosino
7. 1Password 联手 Anthropic:让 Claude 登录网站而不暴露你的凭据
1Password 与 Anthropic 合作推出 1Password for Claude:解决 agent 时代的新安全问题——过去让 agent 替你登录网站,意味着把凭据暴露给模型。新方案让 Claude 代为登录与操作时,无需把用户名密码交给模型本身。在 agent 开始预订行程、登录账号、代为行事的背景下,凭据隔离是 agent 安全从理论走向基础设施的关键一环,也确立了凭证中介这一新合作范式。

来源:@1Password
Tutorial
1. 自我改进型 Agent 综述:从研究 demo 走向部署系统
Sebastian Raschka 推荐一篇关于自我改进型 agent 系统的综述:自改进 agent 正从研究 demo 走向真实部署系统。该综述把现代 agent 形式化为基础模型加操作脚手架,并据此给出自改进机制的分类。这类框架的价值在于,为 agent 如何从自身运行中学习并变得更好提供共同语言与设计坐标,避免各家各说各话。对构建长期运行、需要自我修复与优化的 agent 系统的工程师,是一份值得收藏的地图。

来源:@omarsar0
2. 拆解廉价玩具机器人:把它改成 LLM 驱动的 STEM 项目
Mario Zechner(badlogicgames)写了一篇详尽的拆解实践:买一只廉价玩具机器人,用暴力拆解、逆向 PCB 与机械结构、重布线、用纸板做结构件,再接入语音识别、TTS、LLM 与 agent,做成给孩子和邻居小孩的 LLM 玩具与 STEM 项目。文章覆盖从硬件拆解到语音管线再到 agent 接入的完整链路。这同时也是他与 HuggingFace/Pollen Robotics 的 Reachy 机器人纸板对真机的对决背景——他笑称这根本不算一场打斗。作为低门槛硬件加 LLM 的端到端教程极具启发性。
来源:How to build a shitty robot
Opinions/Thoughts
1. Simon Willison 评 Kimi K3:鹈鹕基准之外更该看什么
Simon Willison 给出 K3 速记与冷静解读:Moonshot 自测基准显示 K3 多数指标胜过 Claude Opus 4.8 max 与 GPT-5.5 high,但整体仍落后于 Claude Fable 5 与 GPT-5。开放权重承诺在 7 月 27 日前放出,将其称作首个开放 3T 级模型(把 2.8 万亿四舍五入到 3 万亿),从 DeepSeek 1.6T v4 Pro 手中接过开放王座。他借此提醒:被戏称为鹈鹕基准的那类花式能力展示,正越来越脱离真正重要的能力(如长对话中的 agentic 工具调用),从业者应把注意力放回后者。