
Product
1. Claude Code 引入动态工作流,实现复杂任务端到端自动化
Anthropic 在 Claude Code 中发布了“动态工作流”(Dynamic Workflows)研究预览版。该功能允许 Claude 动态编写编排脚本,在单次会话中并行调度数百个子智能体,完成代码库级审计、大规模迁移等复杂任务。Bun 作者 Jarred Sumner 利用该功能在 11 天内完成了 75 万行代码的跨语言移植,且测试通过率高达 99.8%。其核心在于“确定性+断点续跑”机制,通过缓存键实现任务韧性,并利用 agent-as-judge 结构兜底质量。该功能目前已向企业版、团队版及 Max 用户开放,支持多种 API 及云平台。
来源:Claude
2. Anthropic 发布 Claude Opus 4.8,强化推理与代理能力
Anthropic 正式发布 Claude Opus 4.8,作为 4.7 的全面升级版,价格保持不变。新模型在编程准确性、判断稳健性及诚实度方面有显著提升,代码缺陷未察觉率降低了 4 倍。同步推出的“投入度控制”滑块允许用户根据任务需求调整推理深度,而“Fast mode”则在保持智能水平的同时将速度提升至 2.5 倍,成本降低至前代的 1/3。此外,Messages API 新增了中间插入 system 指令的功能,进一步提升了开发者的上下文控制能力。

来源:Introducing Claude Opus 4.8
3. Hermes Agent v0.15.0 发布,大幅提升代理运行效率
Nous Research 发布了 Hermes Agent v0.15.0,代号“Velocity Release”。此次更新重点在于性能优化,通过将核心代码库从 16,083 行精简至 3,821 行(减少 76%),显著提升了代理的启动速度与执行效率。该版本通过 14 个内聚模块重构了代理架构,并引入了 Kanban 风格的任务管理。此次更新标志着 Hermes 在处理大规模任务时的响应速度和稳定性迈上新台阶,进一步巩固了其在开源代理框架中的地位。
来源:GitHub
4. Anthropic 完成 650 亿美元 H 轮融资,估值近万亿
Anthropic 宣布完成 650 亿美元的 H 轮融资,估值达到 9650 亿美元,由 Altimeter Capital、Dragoneer、Greenoaks 和 Sequoia Capital 领投。公司表示,其年度经常性收入(ARR)已突破 470 亿美元。这笔资金将用于加速安全与可解释性研究,并扩充算力以满足 Claude Code 和 Cowork 等产品的爆发式需求。此次融资规模反映了全球企业对 Claude 代理能力的极高依赖度。
来源:Anthropic raises $65B in Series H funding at $965B post-money valuation
5. Vercel CLI 推出原生二进制版本,移除 Node.js 依赖
Vercel CLI 现已支持实验性的原生二进制版本,无需 Node.js 运行时即可运行。此举旨在解决代理基础设施中的瓶颈,提升启动速度与安全性。原生二进制文件经过代码签名,且在 macOS 上实现了系统 Keychain 级别的凭据隔离。Guillermo Rauch 指出,随着 OpenClaw、Claude Code 等代理工具的普及,CLI 已成为“代理云”的关键接口,原生化将极大提升其在各种自动化环境中的部署效率。
来源:Vercel
6. Polar:无需代码更改的模型微调工具
Polar 允许用户利用现有的智能体环境作为训练平台,无需修改代码即可对模型进行微调。
7. Claude Code 新增安全插件
Claude Code 引入安全插件,可在代码编写过程中实时检测不安全命令、HTML 处理及危险 Python 代码。
Tutorial
1. howtoeval:AI 智能体评估指南
一份直截了当的 AI 智能体评估指南,旨在帮助开发者科学地衡量智能体性能。
Opinions/Thoughts
1. 异步代理时代:从 Devin 实践看 AI 软件工厂的崛起
Latent.Space 播客探讨了从“前台 AI 工具”向“异步后台代理”的范式转移。Cognition 的 Devin 数据显示,其自主提交的代码比例已从 16% 跃升至 80%。专家指出,未来的工程团队将演变为“软件工厂”,人类工程师的角色从代码编写者转变为系统架构师。核心挑战在于如何构建安全的“盒外”代理架构,以及如何解决长效记忆与复杂测试问题。纯粹的“vibe coding”若缺乏代码审查,极易导致代码库在两周内出现严重退化。
来源:Latent.Space
2. 深度测评:Claude Opus 4.8 是否足以挑战 GPT-5.5?
Every 团队对 Claude Opus 4.8 进行了深度测评,认为其在高级工程任务和写作表现上已超越 GPT-5.5。测评显示,Opus 4.8 在 Senior Engineer 基准测试中得分 63,略高于 GPT-5.5 的 62,且在 PPT 生成等知识工作任务中表现出色。测评指出,模型表现高度依赖“投入度”设置,建议在 xhigh 模式下使用以获得最佳效果。尽管模型能力极强,但测评者认为 Claude Desktop 应用在交互体验上仍落后于 Codex,这是目前阻碍其成为首选工具的主要因素。
来源:Vibe Check: Opus 4.8—Anthropic Should’ve Rounded Up to 5
3. Simon Willison:Claude Opus 4.8 的诚实度提升
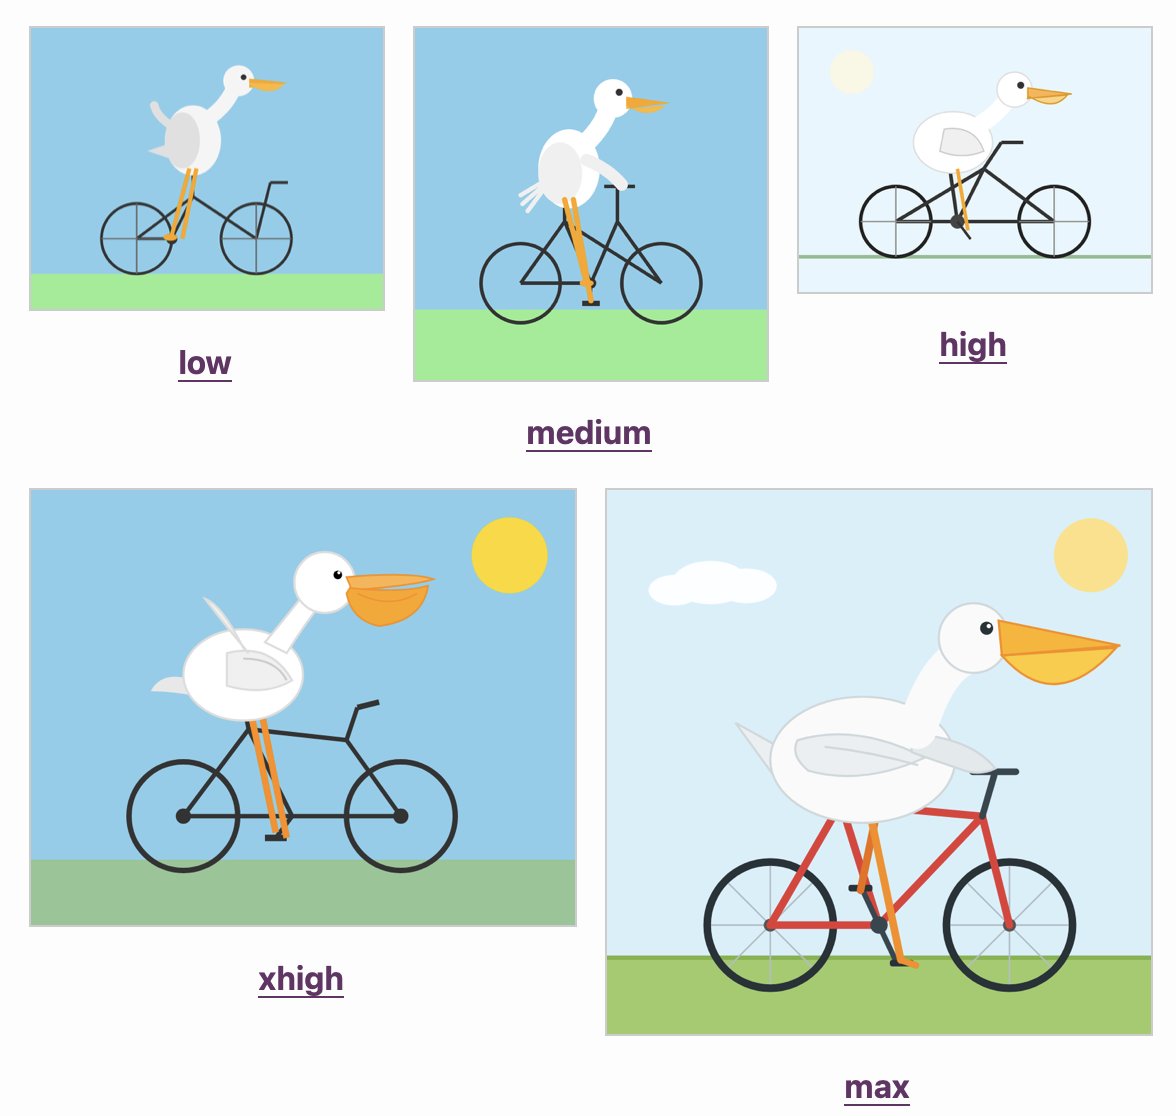
Simon Willison 在博客中评价 Claude Opus 4.8 为“适度但切实的改进”。他特别赞赏 Anthropic 在系统卡中坦诚模型仍有局限,并强调了 Opus 4.8 在“诚实度”上的提升——模型更倾向于标记不确定性,而非自信地输出错误代码。Willison 认为这种透明度是 AI 实验室成熟的标志。此外,他通过鹈鹕骑自行车的视觉隐喻,生动展示了模型在不同推理努力等级下的表现差异。
4. Theo:SOTA 模型在正确答案上消耗更多 Token
Theo 基于 Datacurve 的数据分析指出,SOTA 模型在处理 DeepSWE 任务时,正确答案消耗的 Token 数量反而比错误答案多出约 7%。这一发现挑战了“模型越聪明越省 Token”的直觉。Theo 认为,这反映了模型在处理复杂任务时,为了确保正确性会进行更深度的推理和验证。该数据对于评估 Agent 成本模型具有重要参考价值,提醒开发者在预算规划时需考虑推理深度带来的成本波动。

来源:@theo
5. Ramp:利用安全智能体自动修复漏洞
Ramp 使用 10,000 个自研安全智能体,在 6 天内发现并修复了近 100 个安全漏洞,全程由人类审核 PR。
6. Software after software:深度阅读推荐
推荐阅读 Thorsten Ball 关于编程环境与软件开发的深度见解。