
Product
1. 研究:通过“睡眠”机制优化长周期 AI 代理的上下文处理
arXiv 最新论文《Language Models Need Sleep》提出了一种针对长周期代理的上下文处理新方法。研究指出,Transformer 的注意力机制在处理长序列时存在二次方计算成本,导致代理效率低下。作者提出了一种“睡眠”机制:模型定期将近期上下文压缩为持久化的快速权重(fast weights),随后清空 KV 缓存。这种方法将额外的计算压力转移到“睡眠”阶段,从而保持了推理阶段的低延迟。实验表明,该方法在多跳图检索和数学推理任务中表现优于传统 Transformer,为长周期代理提供了一种替代超大 KV 缓存的方案。

来源:arXiv.org
2. Claude Code 安全指南插件:在编码过程中实时捕获漏洞
Claude Code 引入了 security-guidance 插件,旨在让 Claude 在编写代码的同时自动审查漏洞。该插件支持在文件编辑、回合结束或提交/推送时自动运行,能够捕获注入、不安全反序列化及不安全 DOM API 等常见安全问题。用户可以通过在仓库中添加
claude-security-guidance.md文件来定义组织特定的安全策略。Anthropic 内部数据显示,该插件的使用使 PR 中的安全相关评论减少了 30-40%。这一工具将安全审查前置,减少了下游人工审查的压力。
来源:Catch security issues as Claude writes code - Claude Code Docs
3. Software Factory:构建 AI 原生软件开发控制平面
Software Factory 旨在解决企业在 AI 编程时代面临的协作与治理挑战。该平台通过 Requirements(业务意图)、Blueprints(架构映射)、Work Orders(结构化任务)和 Tests(验证)等模块,将 AI 代理纳入统一的工程系统。它利用知识图谱将代码、文档和任务关联,确保 AI 代理的输出符合架构决策和合规要求。EY 等企业的部署案例显示,该平台显著提升了生产力并实现了高自动化测试覆盖率。Software Factory 试图将 AI 编程从“个人单机”提升为“团队协作”的工程化流程。
来源:8090 — AI-Native Software Development Platform
4. DeepSWE:面向代理编码能力的全新基准测试标准
DeepSWE 旨在成为代理编码能力的新基准测试标准。研究人员指出,现有的公共排行榜往往无法反映模型在真实开发场景中的实际表现。DeepSWE 通过模拟开发者日常工作中的真实挑战,揭示了顶级模型在处理复杂工程任务时的实际差异。该基准测试旨在为评估 AI 编码代理提供更具参考价值的指标,帮助开发者识别模型在实际生产环境中的能力边界。
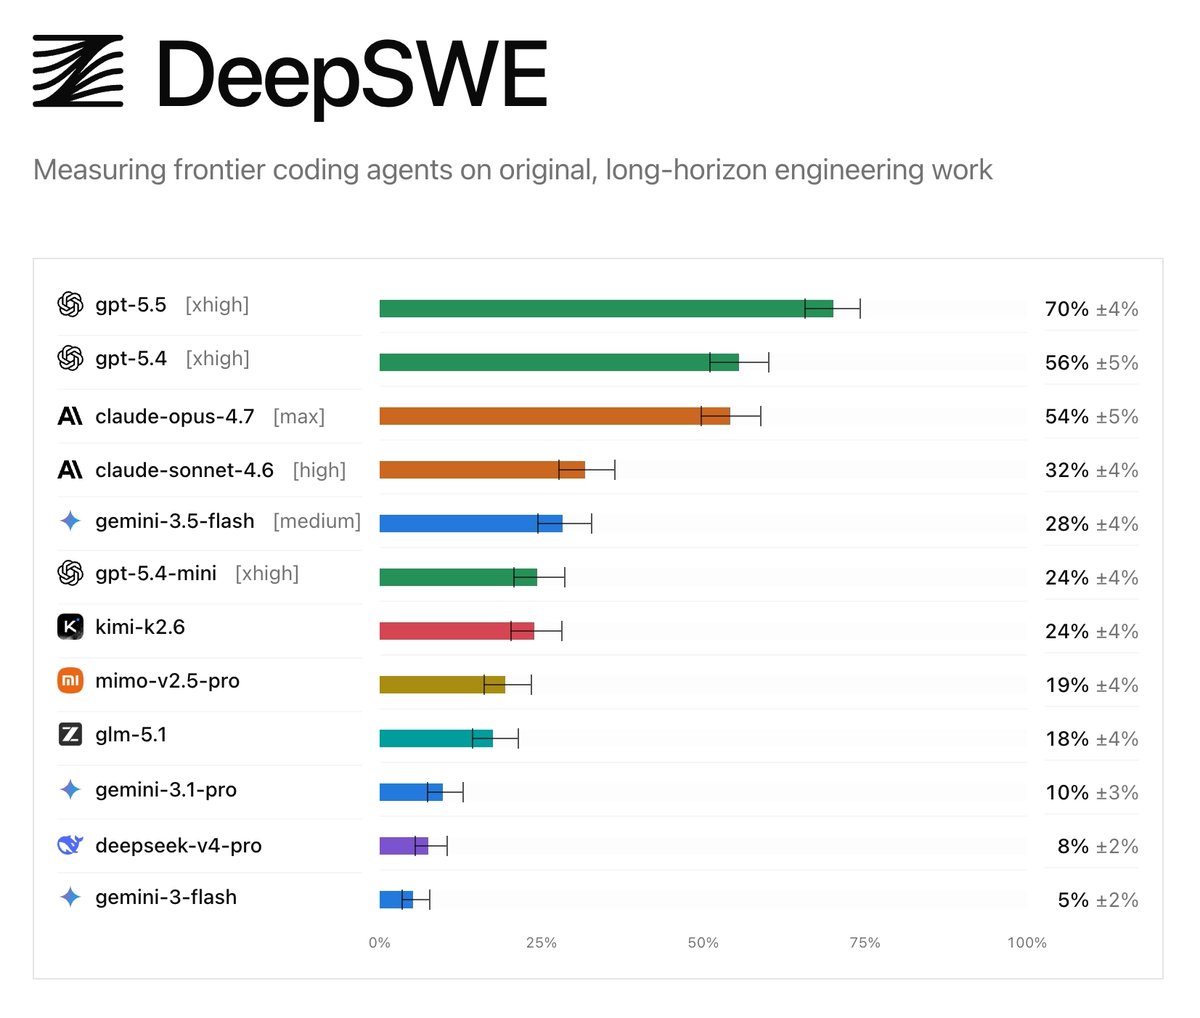
来源:@serenaa_ge
5. Superset:支持并行编排 100+ 编码代理的开发环境
Superset 是一款专为 AI 时代打造的开发环境,支持在本地机器上并行编排 100 多个编码代理。它允许用户在等待当前代理完成任务的同时,快速切换并启动新的编码任务。Superset 兼容多种代理工具,并提供工作空间管理、端口转发和变更审查等功能。通过将开发环境与代理工作流深度集成,Superset 旨在解决多代理协作中的上下文切换和资源管理难题,提升开发者的多任务处理效率。
来源:Superset
6. MiniMax 预告 M3 模型:采用稀疏注意力架构并计划开源
MiniMax 预告了其下一代模型 M3。该模型将采用全新的稀疏注意力(Sparse Attention)架构,旨在提升处理效率和性能。更重要的是,MiniMax 计划将 M3 模型开源,这将进一步丰富开源大模型生态。稀疏注意力架构是当前提升长上下文处理能力和推理效率的关键技术方向,MiniMax 的这一动作表明其在模型架构创新上的积极布局。开源计划将为开发者提供更多高性能模型的选择,值得持续关注。


7. release.bar:GitHub 活跃仓库追踪
release.bar 提供了一个展示活跃 GitHub 仓库及其开发者仪表盘的平台,填补了 GitHub 在项目动态追踪方面的空白。
8. Hyper:Bun API 框架
Hyper 是一个 Bun API 框架,采用直接复制到代码库的方式使用,而非作为依赖项安装,简化了项目集成。
9. MCP 协议重大升级
模型上下文协议(MCP)将于 7 月 28 日发布重大更新,增强了大规模运行的可靠性,并增加了对应用界面、长任务及安全规则的支持。
Tutorial
1. Lenny Rachitsky:产品构建者的 36 本必读经典书单(第一部分)
Lenny Rachitsky 策划了一份包含 36 本必读经典的书单,旨在帮助产品构建者、领导者和专业人士提升技能。书单分为 12 个类别,每个类别精选 3 本书,强调 timeless(永恒)的价值,优先推荐出版超过 10 年的书籍。作者认为,在 AI 驱动的开发时代,分发能力(distribution)已成为比构建能力更大的瓶颈。该书单涵盖了沟通、执行、战略、管理、领导力等多个维度,为产品专业人士提供了系统性的知识框架。
Opinions/Thoughts
1. Anthropic 工程博客:如何通过沙箱化控制 AI 代理的破坏半径
Anthropic 在其工程博客中探讨了如何为具备高权限的 AI 代理设置安全边界。随着代理能力从简单的代码补全演进到能够执行复杂任务,其潜在的“破坏半径”也在扩大。Anthropic 强调,通过环境控制(如沙箱化)和人机协作(human-in-the-loop)来限制代理的权限是实现高价值部署的前提。文章指出,虽然模型能力是风险的一部分,但通过工程手段限制代理的行动范围,可以使高风险任务变得可控。这一策略反映了 AI 实验室在追求模型能力提升的同时,对生产环境安全治理的深度思考。
来源:How we contain Claude across products
2. AI 编程的下一阶段:从提示词竞赛转向工作系统竞赛
本文深度分析了 AI 编程工具的演进趋势,指出行业正从“生成能力竞赛”转向“工作系统竞赛”。作者认为,真正的 AI-native 工程能力不在于更强的提示词,而在于如何构建包含上下文、工具、权限、测试和治理的共享资产系统。文章引用了多项行业实践,强调了 harness engineering(脚手架工程)的重要性,即通过构建 planner、evaluator 和反馈回路,将 AI 代理纳入可维护的工程循环中。AI 编程的未来在于让人类工程师从“逐行审查”转向“设计和维护产生代码的系统”。
来源:X 观察 #1: AI 编程的下一阶段,不是更强的提示词,而是更好的工作系统
3. Stack Overflow 的转型:从问答社区到 AI 数据矿
尽管 Stack Overflow 的论坛流量因 AI 编程助手的普及而大幅下滑,但其公司层面的收入却实现了翻倍。Stack Overflow 通过将十几年积累的高质量问答数据授权给 AI 公司进行训练,并推出企业级知识库产品 Stack Internal,成功实现了商业模式的转型。CEO Prashanth Chandrasekar 指出,虽然简单问题被 AI 取代,但复杂问题仍依赖社区。然而,随着新问答产出的减少,这一“数据矿”的长期可持续性仍面临挑战。这一案例揭示了 AI 时代知识平台在面临颠覆时的生存策略。

4. 最小化实用技能开发法
建议通过分析近期工作流中的重复性任务,仅针对性地创建最小化的实用技能、子代理或自动化工具,以提升效率。
5. Armin Ronacher:为什么我倾向于使用“Clanker”而非“Agent”
Armin Ronacher 探讨了为何在 AI 语境下倾向于使用“Clanker”而非“Agent”。他认为,“Agent”一词带有拟人化色彩,暗示了机器具备责任和代理权,而实际上机器只是工具。使用“Clanker”有助于在人类与机器之间建立必要的距离,强调机器不具备情绪、意识或责任。这一观点反映了当前 AI 社区对过度拟人化 AI 系统的反思,提醒开发者在构建和使用 AI 工具时保持清醒的认知,明确机器的工具属性。
6. 深度解析:华为芯片堆叠技术与 Tau Scaling 定律
本文从芯片架构师视角深度解析了华为的芯片堆叠技术与所谓的“Tau Scaling”定律。作者认为,华为的创新本质上是通过高设计复杂度、高制造成本和超前散热技术,在受限的工艺节点上弥补性能差距。Tau Scaling 并非新物理定律,而是对互联 RC 延迟瓶颈的营销包装。文章详细分析了 LogicFolding 的技术代价(散热、复杂度、成本)及其带来的 topology 红利,指出该技术路线虽然在当前环境下极具价值,但存在边际收益递减的天花板。这一分析为理解华为在制裁环境下的技术突围提供了专业视角。


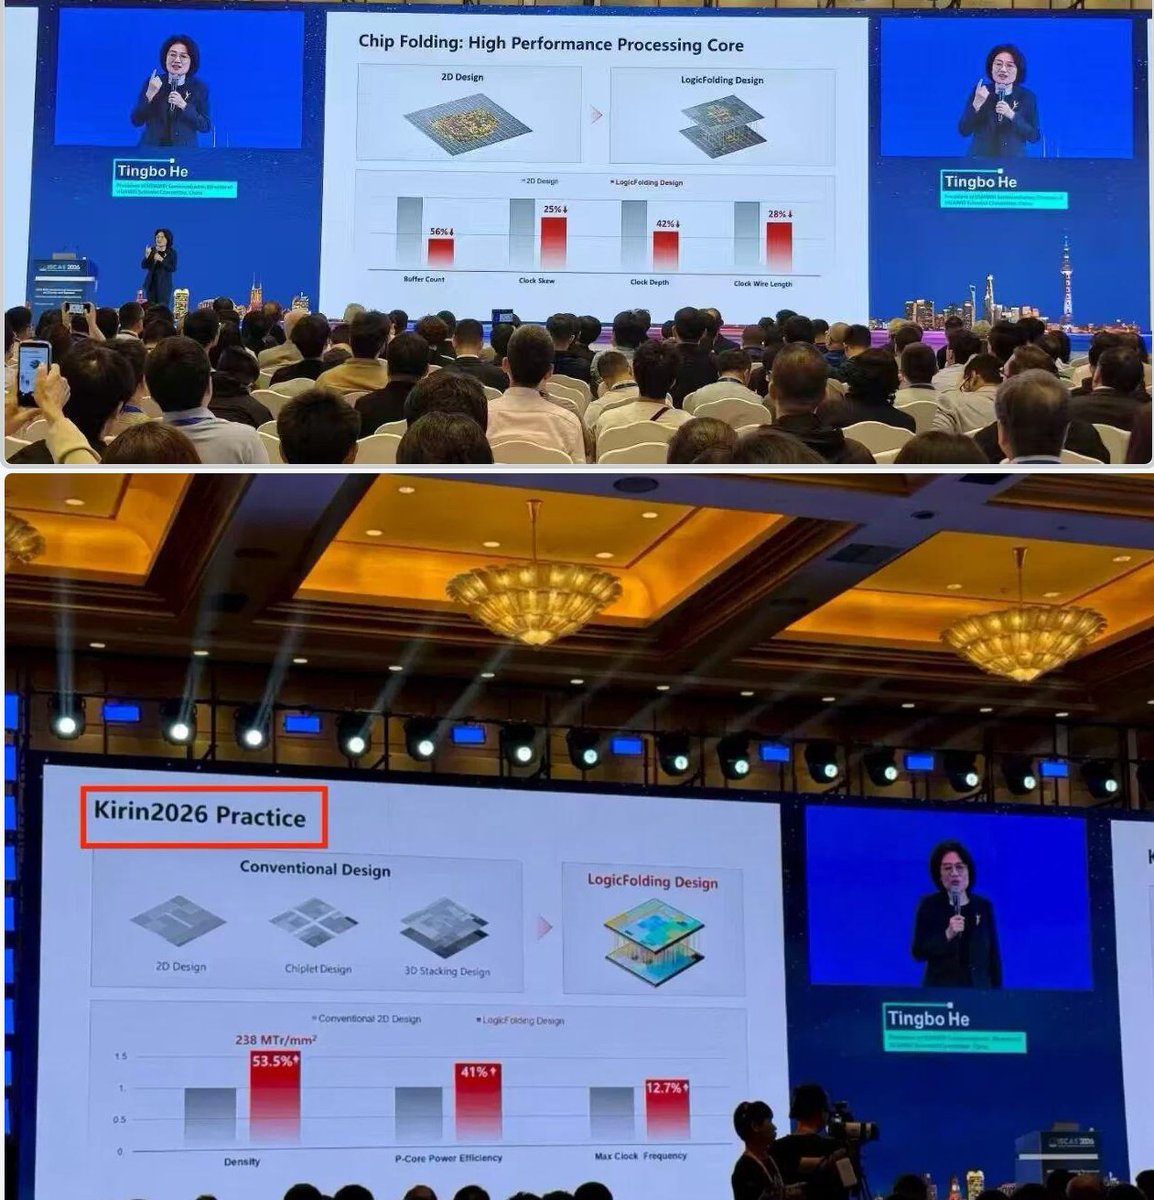

来源:@fi56622380
7. AI 代理驱动的个人创业模式
分享了如何通过 AI 代理(如 OpenClaw、Codex/Devin)处理行政、工程及日常办公任务,实现单人运营初创公司。