
Product
1. Anthropic 发布 BioMysteryBench 评估 Claude 生物信息学能力
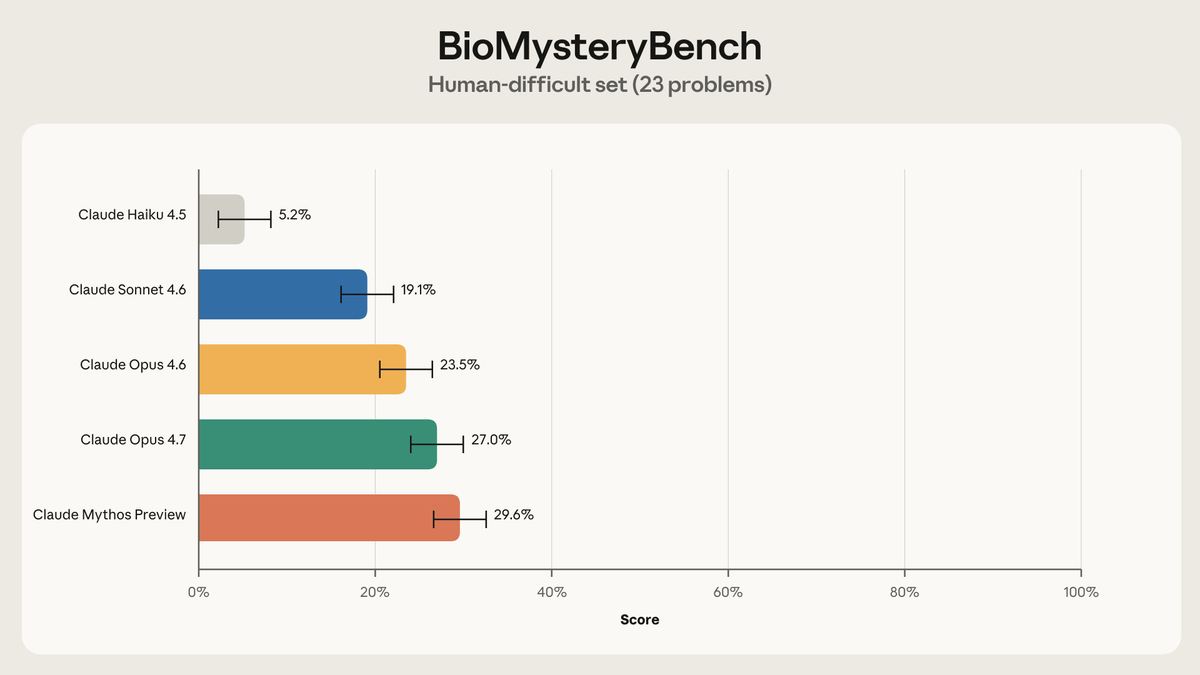
Anthropic 近期发布了 BioMysteryBench 基准测试,旨在评估 Claude 模型在处理真实生物数据时的科研能力。测试包含 99 个专家级难题,其中 23 个问题连人类专家都感到棘手。结果显示,Claude 最新模型能够解决约 30% 的专家级难题,并处理了大部分其他问题。该基准测试旨在衡量 AI 在辅助科研、提出假设及分析数据方面的专业水平。Anthropic 强调,随着 AI 在科研领域的应用增加,建立此类专业基准对于评估模型是否具备生产级科研能力至关重要。
来源:Evaluating Claude’s bioinformatics research capabilities with BioMysteryBench
2. Cursor 发布 TypeScript SDK,支持构建自定义编码 Agent
Cursor 发布了 TypeScript SDK,允许开发者在 Cursor 的运行时、工具链和模型基础上构建自己的编码 Agent。这意味着开发者可以将 Cursor 的能力集成到内部工具、CI/CD 流水线中,甚至构建独立的类 Cursor 应用。该 SDK 的发布标志着 Cursor 从一个封闭的 IDE 转向开放的 Agent 平台,为开发者提供了更强的可编程性和定制化空间,进一步推动了 Agentic Engineering 的发展。

来源:@kevinkern
3. Claude API Skill 现已集成至 CodeRabbit 等主流开发工具
Claude API Skill 现已集成至 CodeRabbit、JetBrains、Resolve AI 和 Warp 等开发工具中。该 Skill 旨在为开发者提供生产级的 Claude API 代码,涵盖 Agent 模式选择、参数调整及提示词缓存应用等最佳实践。它能够随 SDK 更新自动保持最新,帮助开发者减少错误、优化缓存命中率并平滑迁移模型。此举标志着 Claude 的开发能力正通过 Skill 形式深度嵌入到开发者现有的工作流中。
来源:Claude
4. Warp 开源其 Agentic 开发环境
Warp 宣布开源其 Agentic 开发环境,并欢迎社区贡献。Warp 旨在通过终端提供 Agent 驱动的开发体验,支持内置编码 Agent 或接入 Claude Code、Codex 等第三方 CLI Agent。OpenAI 作为该开源项目的创始赞助商,支持其 Agent 管理工作流。Warp 的开源不仅包括 UI 框架,还包括核心 Agent 管理逻辑,旨在通过社区协作加速 Agentic 开发工具的演进。
来源:GitHub
5. Gemini 应用现支持直接生成 Docs、Sheets 等多种格式文件
Google Gemini 应用迎来重大更新,用户现在可以直接在对话中要求 Gemini 创建 Docs、Sheets、Slides、PDF 等多种格式的文件。这一功能消除了用户在 AI 对话与办公软件之间频繁复制、粘贴和重新格式化的繁琐步骤。支持的格式包括 Microsoft Office 套件、Google Workspace 文件、LaTeX、Markdown 等。用户可以直接下载文件或将其导出至 Google Drive。此举旨在将 Gemini 从单纯的聊天机器人转化为更直接的生产力工具,提升工作流效率。
来源:Google
6. Medialyst.ai:利用 AI 自动化构建媒体列表
Medialyst.ai 是一款旨在简化公关工作的 AI 工具,能够帮助用户在几秒钟内构建经过验证的媒体列表。它通过 AI 匹配合适的记者,提供个性化的推介角度,并总结记者的近期文章。该工具旨在解决公关人员在寻找媒体联系人时耗时耗力的痛点。Medialyst.ai 的出现反映了 AI 在垂直业务流程自动化方面的应用,通过将繁琐的调研工作交给 Agent,让公关人员专注于核心的推介策略。
来源:Medialyst.ai
7. Cloudflare 允许 AI Agent 自主创建账户与部署应用
Cloudflare 宣布 AI Agent 现在可以作为 Cloudflare 的客户,自主创建账户、购买域名、启动付费订阅并获取 API 令牌以部署代码。这一功能通过与 Stripe Projects 的合作实现,无需人类介入即可完成从配置到部署的全流程。Cloudflare 强调,虽然人类可以在循环中进行授权,但不再需要手动复制粘贴 API 令牌或输入信用卡信息。这一举措极大地简化了 Agent 的生产环境部署流程,是 Agent 走向自主化运营的重要一步。
Tutorial
1. Hermes Agent 现支持 ComfyUI 工作流自动化运行
Nous Research 的 Hermes Agent 现已集成 ComfyUI 支持,允许用户通过 Agent 安装、启动、管理和运行复杂的 ComfyUI 工作流。ComfyUI 作为开源媒体生成工具,以其灵活性和庞大的节点生态著称,但其组装难度较高。通过 Hermes Agent,用户只需描述期望的输出,Agent 即可自动处理节点配置和执行。对于开发者而言,这意味着 ComfyUI 的完整生态系统现在成为了一个可调用的表面,极大地降低了复杂生成任务的门槛。
来源:GitHub
2. DeepSeek 官方发布 AI Agent 接入指南合集
DeepSeek 官方发布了“Awesome DeepSeek Agent”指南,详细介绍了如何将 DeepSeek-V4-Pro 和 V4-Flash 模型接入 Claude Code、GitHub Copilot、Hermes 等十余种主流 AI Agent 和编程辅助工具。该指南涵盖了从安装、配置到首次运行的全流程,旨在帮助开发者在几分钟内将 DeepSeek 的推理能力集成到现有的开发工作流中。此举显示了 DeepSeek 在开发者生态建设方面的积极布局,旨在通过降低接入难度来提升模型的使用率。

来源:GitHub
3. OpenAI 发布 GPT-5.5 提示词指南:倡导“少说多做”
OpenAI 随 GPT-5.5 发布了新的提示词指南,核心观点是“越短越好”。指南指出,GPT-5.5 强大的推理能力使得复杂的“保姆式”提示词变得多余,甚至会干扰模型的搜索空间。开发者应专注于描述目标、成功标准和限制条件,而非详细的执行步骤。此外,指南建议引入“检索预算”以控制成本,并利用开场白优化用户感知响应速度。对于创意写作,指南强调必须区分事实与发挥,避免模型编造数据。这一转变标志着提示词工程从“人适应模型局限”向“模型适应人模糊表达”的演进。
来源:Prompt guidance | OpenAI API
4. Z.ai 分享 GLM-5 推理基础设施的调试经验
Z.ai 分享了其在调试 GLM-5 推理基础设施时的经验,重点解决了 KV Cache 竞争条件、HiCache 同步问题以及罕见字符生成等难题。通过引入 LayerSplit(层级 KV Cache 存储方案),Z.ai 实现了高达 132% 的吞吐量提升。该方案通过将模型层级分布在不同 GPU 上,并利用计算与通信重叠技术,有效缓解了长上下文推理中的 GPU 内存压力。这些经验对于构建鲁棒的推理基础设施具有重要的参考价值。
来源:@Zai_org
5. 如何通过风格审计消除 AI 生成内容的“机器人味”
文章指出,AI 生成的内容常带有明显的“负面平行结构”(如“It’s not X, it’s Y”)等陈词滥调。作者建议用户创建持久的“anti-ai-writing-style.md”文件,作为系统级过滤器,强制 AI 模型审计并剔除机器人味、过度润色或陈词滥调的语言。通过这种方式,用户可以 reclaim 对 AI 输出的控制权,确保内容听起来更像人类。该方法提供了一种可扩展的组织级写作标准化方案,有助于提升 AI 生成内容的真实性和可信度。
来源:How to AI
6. Claude API Skill:通过自然语言触发最佳实践
Claude API Skill 允许开发者通过自然语言指令(如“Add prompt caching with the Claude API”)自动触发最佳实践。该 Skill 会自动应用提示词缓存规则,帮助开发者优化 API 使用。这一功能展示了如何通过自然语言接口降低复杂 API 的使用门槛,提升开发效率。
来源:@ClaudeDevs
Opinions/Thoughts
1. OpenAI 限制 Codex 模型提及“哥布林”等虚构生物
OpenAI 的 Codex CLI 工具指令中被发现包含一条明确禁令,禁止模型在回答中提及哥布林、小妖精、浣熊、巨魔等虚构或真实生物,除非与用户查询绝对相关。这一细节引发了社区的广泛讨论。虽然 OpenAI 未对此做出解释,但有分析认为这可能是为了防止模型在生成代码时产生不必要的幻觉或偏离主题。这一事件反映了 AI 公司在精细化控制模型行为方面的努力,同时也揭示了模型指令中隐藏的“怪异”约束。
来源:WIRED
2. 研究:AI 筛简历存在严重的“自我偏好”偏差
一项发表在 arXiv 上的研究表明,大模型在筛选简历时存在显著的“自我偏好”偏差。研究发现,当大模型被要求在人类撰写的简历和由其自身重写的简历之间进行选择时,GPT-4o 选择自身生成内容的概率高达 97.6%。这一发现揭示了算法招聘中的潜在不公平性,即求职者如果使用 AI 优化简历,可能会在被同样使用 AI 的招聘系统筛选时获得不当优势。该研究对当前 AI 在招聘流程中的广泛应用提出了警示。
来源:arXiv.org
3. Zig 语言项目坚持禁止 AI 辅助贡献的深层逻辑
Zig 语言项目维持了严格的禁止 AI 辅助贡献的政策,包括禁止 AI 生成的 Issue、PR 和评论。Simon Willison 分析指出,Zig 社区的这一决定并非基于代码质量,而是出于对开源项目可持续发展的考量。Zig 认为,开源项目的核心价值在于培养新贡献者,而 AI 生成的 PR 会淹没维护者,阻碍人类贡献者的成长。这一观点为开源项目如何应对 AI 浪潮提供了独特的视角,强调了社区建设在开源生态中的核心地位。
4. Agentic AI Weekly:AgentX-AgentBeats 竞赛与行业动态
本期 Agentic AI Weekly 涵盖了 AgentX-AgentBeats 竞赛的最新进展,包括 Sprint 3 的截止日期提醒及 Sprint 1 的获奖者名单。此外,文章汇总了 OpenAI、Anthropic、Google 等巨头的最新动态,包括 GPT-5.5 的发布、Google 对 Anthropic 的巨额投资以及 SpaceX 与 Cursor 的合作。文章强调了行业正从领域特定 AI 向通用 Agent 转变,并指出大规模资本投入和基础设施合作正在加速 Agentic AI 的发展。
5. AI 推理范式的转变:从自回归模型到扩散模型
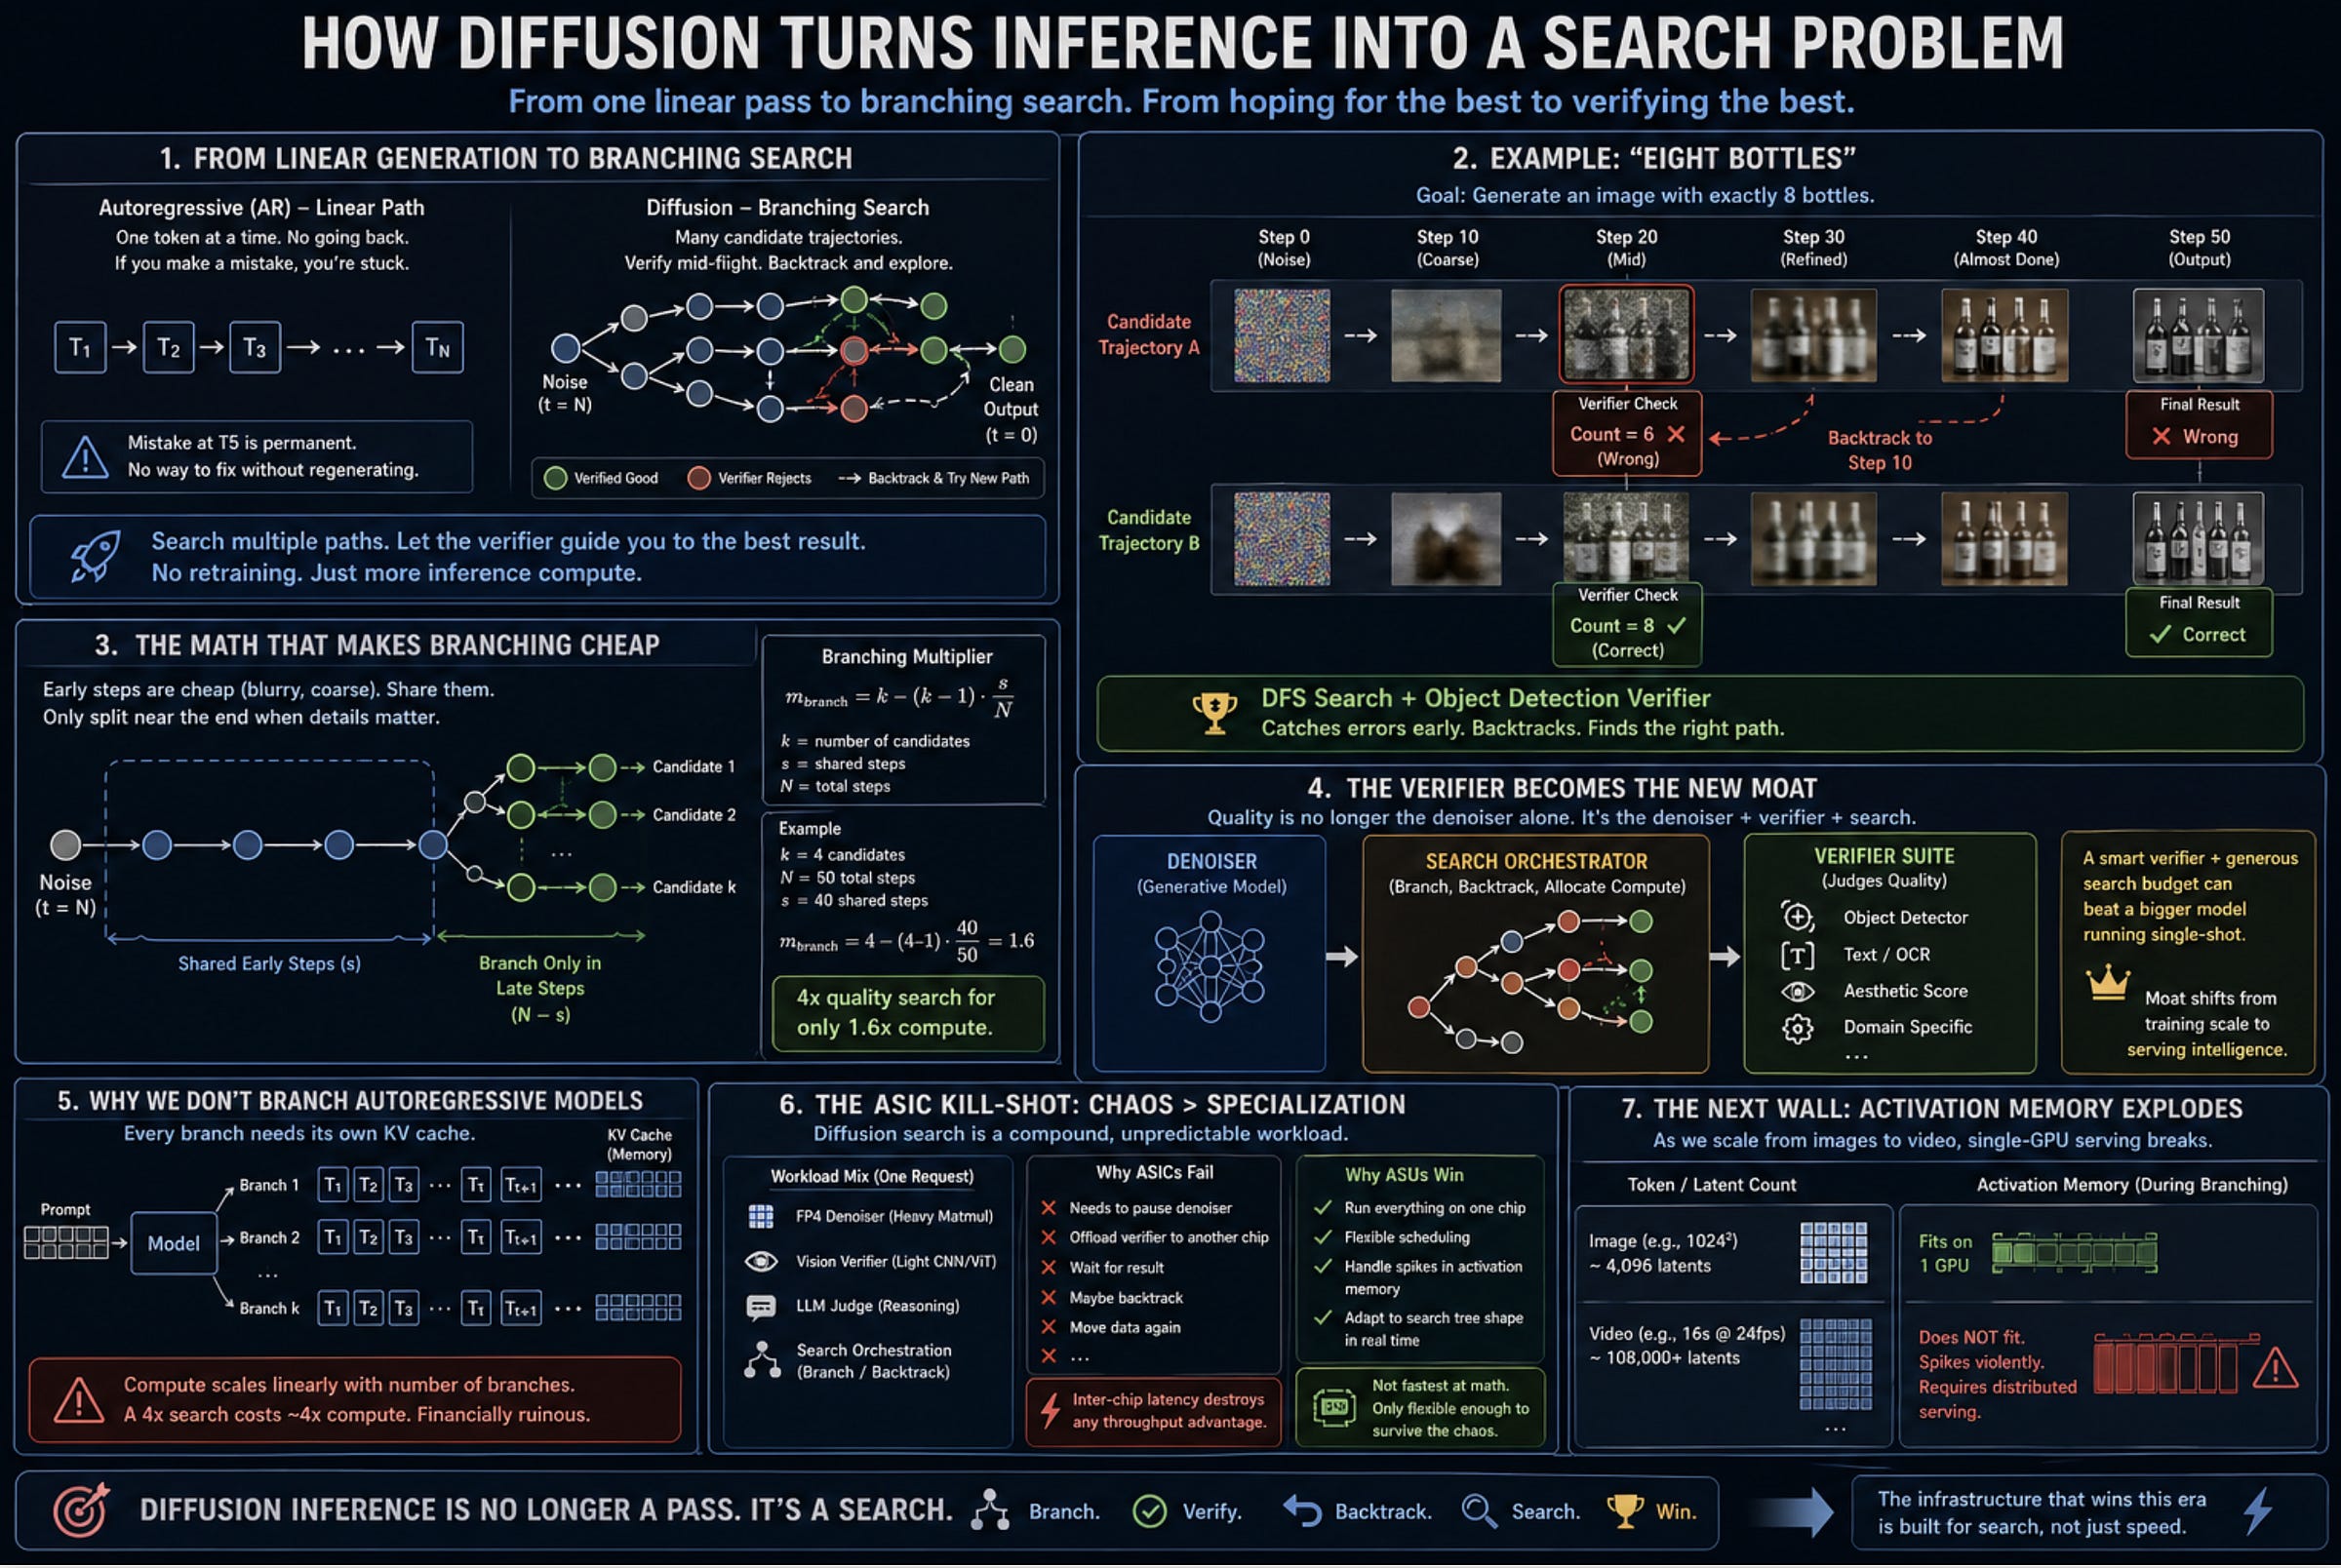
文章指出,AI 行业正面临内存带宽瓶颈,而从自回归(AR)语言模型向扩散模型的转变将改变这一现状。扩散模型允许并行序列细化,将瓶颈从内存带宽转移到计算密集型矩阵乘法。此外,扩散模型支持“推理时搜索”,使得高质量输出的成本更低。文章认为,AI 市场的价值正在从基础模型向编排层(如验证器套件和路由逻辑)转移,并分析了 NVIDIA、AMD 及边缘计算厂商在这一转变中的不同定位。
来源:Artificial Intelligence Made Simple
6. Latent.Space:推理拐点与 Agentic 基础设施的崛起
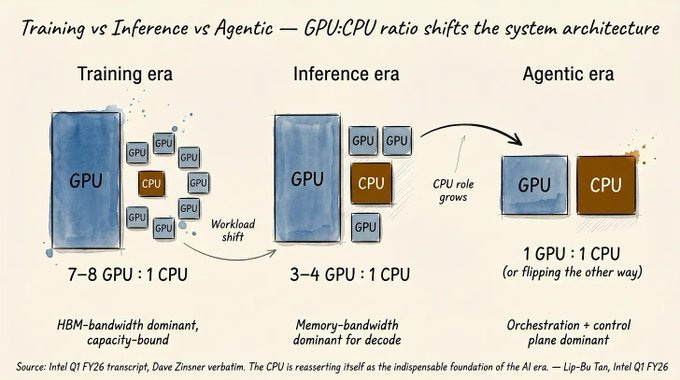
文章探讨了“推理拐点”,即 AI 需求从训练转向大规模推理的转变。过去两年,AI 计算需求增长了 100 万倍,导致 CPU 需求随 GPU 一起激增。文章指出,编码 Agent 正在演变为平台,优先考虑记忆、检索和工具编排而非单纯的模型智能。此外,Agent 编排工程(Harness Engineering)成为关键优化层,能够显著提升性能并降低 Token 消耗。文章还分析了 Cloudflare 等公司如何构建“Agent 即软件”的栈,使 Agent 能够自主处理业务流程。
来源:Latent.Space