
Product
1. iii:将 Agent 基础设施与后端架构深度融合
iii 提出了一种将 Agent 基础设施与传统后端架构合二为一的范式。该架构将后端抽象为三个核心原语:执行工作的 Worker、触发服务的 Trigger 以及处理逻辑的 Function。在这种模型下,Agent 不再是独立于后端的“外挂”,而是作为一种 Worker 参与到整个系统中,共享相同的状态管理、路由和可观测性。这种设计消除了 Agent 框架与后端服务之间的边界,使得 Agent 可以直接注册函数、定义触发器并参与实时发现。iii 通过 WebSocket 协议实现了跨语言、跨设备的统一通信,支持从云端服务到边缘设备的无缝集成。该架构不仅简化了 Agent 的编排,还通过 OpenTelemetry 实现了端到端的全链路可观测性。
2. Warp 终端正式开源,引入 AI 智能体驱动协作模式
现代终端工具 Warp 宣布客户端代码正式开源,并采用 AGPL 协议,OpenAI 作为创始赞助商参与其中。Warp 引入了全新的“AI 智能体驱动”协作模式,利用其云端 AI 平台 Oz 承担代码编写、测试和规划等繁重任务,开发者则专注于方向把控与验证。此次更新还支持了 Kimi、MiniMax 和 Qwen 等多种开源模型,并引入了自动路由功能以选择最优模型。此外,Warp 增强了界面的可定制性,并终于支持了配置文件,方便跨设备同步设置。尽管客户端已开源,但服务端代码仍保持闭源状态。
来源:GitHub
3. ghx:解决 GitHub CLI API 速率限制的缓存代理
ghx 是一款专为 GitHub CLI (gh) 设计的缓存代理工具,旨在解决 AI Agent 频繁调用 API 导致的速率限制问题。它通过缓存冗余的 API 请求,显著提升了重复命令的执行速度,并支持单次请求合并(Singleflight)。ghx 采用白名单机制,仅缓存安全的只读命令,并具备自动失效机制以处理数据变更。该工具作为 gh 的直接替代品,无需额外配置,非常适合在 Agent 工作流中频繁调用 GitHub API 的场景。
来源:GitHub
4. Mesa:专为企业级 AI Agent 设计的持久化文件系统
Mesa 是首个专为 AI Agent 设计的 POSIX 兼容文件系统,旨在解决 Agent 在处理长期任务时面临的存储持久化与版本控制难题。传统的沙盒环境通常是临时的,而 Mesa 提供了持久化存储,确保 Agent 的工作成果在任务结束后依然可用。该系统内置了版本控制功能,支持分支、回滚和细粒度的访问控制,使得 Agent 可以在并行任务中安全地协作。Mesa 通过稀疏物化技术优化了大规模文档集的加载速度,并支持完整的审计历史记录。目前,该系统已在法律、医疗和业务运营等领域的企业级 Agent 中投入生产使用。

来源:Mesa
5. Engramme:旨在增强人类记忆的 AI 记忆系统
Engramme 是一款旨在增强人类记忆的 AI 系统,通过构建“大型记忆模型”(LMM)实现主动记忆功能。该系统能够自动从 Gmail、Slack 等工具中提取关键信息,无需用户显式搜索或提示即可主动呈现相关上下文。Engramme 旨在为应用程序提供持久的人类记忆,帮助用户记住重要的人、对话和时刻。该工具目前处于测试阶段,适合需要构建高级 AI Agent 记忆层的开发者参考。
来源:Engramme – Remember Everything
6. VibeVoice-ASR:微软开源的 60 分钟长音频转写模型
微软开源的 VibeVoice-ASR 语音识别模型支持单次处理 60 分钟连续音频,并能输出包含说话人、时间戳和内容的结构化转写。该模型原生支持 50 多种语言,并能处理中英混说。实测显示,在 128GB 内存的 MacBook Pro 上,转写一小时播客耗时约 9 分钟。该模型将传统的语音识别与说话人分离流程压缩为一次推理,极大提升了会议纪要和采访整理的效率。尽管对硬件内存要求较高,但其在长音频处理上的表现为语音 AI 领域提供了新的开源基准。
来源:GitHub
7. Claude Code:提升 CLI 交互体验与稳定性
Claude Code 在最近的更新中重点提升了 CLI 的交互体验与稳定性。改进包括优化了 Windows 和 Xcode 的粘贴体验,修复了调整窗口大小时滚动条重复的问题,并确保了全屏模式下的滚动体验。这些针对“纸片式”问题的修复,显著提升了开发者在终端中使用 Claude Code 的流畅度,体现了产品在细节打磨上的持续投入。
来源:@ClaudeDevs
Tutorial
1. 教程:如何将 Hermes Agent 训练为 OpenRouter 专家
本教程指导用户如何通过创建自定义技能,将 Hermes Agent 训练为 OpenRouter 专家。通过读取 OpenRouter 的文档索引,Hermes 可以学习如何根据任务需求选择合适的模型、API 或 SDK。教程提供了具体的 Prompt,引导 Hermes 构建一个包含决策框架、路由表和验证步骤的技能文件。这种方法不仅避免了硬编码模型 ID 的局限,还确保了 Agent 在面对快速变化的模型生态时能保持上下文的准确性。通过这种方式,开发者可以构建一个不依赖单一提供商、且能随使用不断进化的 coding agent。
来源:Turn Your Hermes Agent Into an OpenRouter Expert
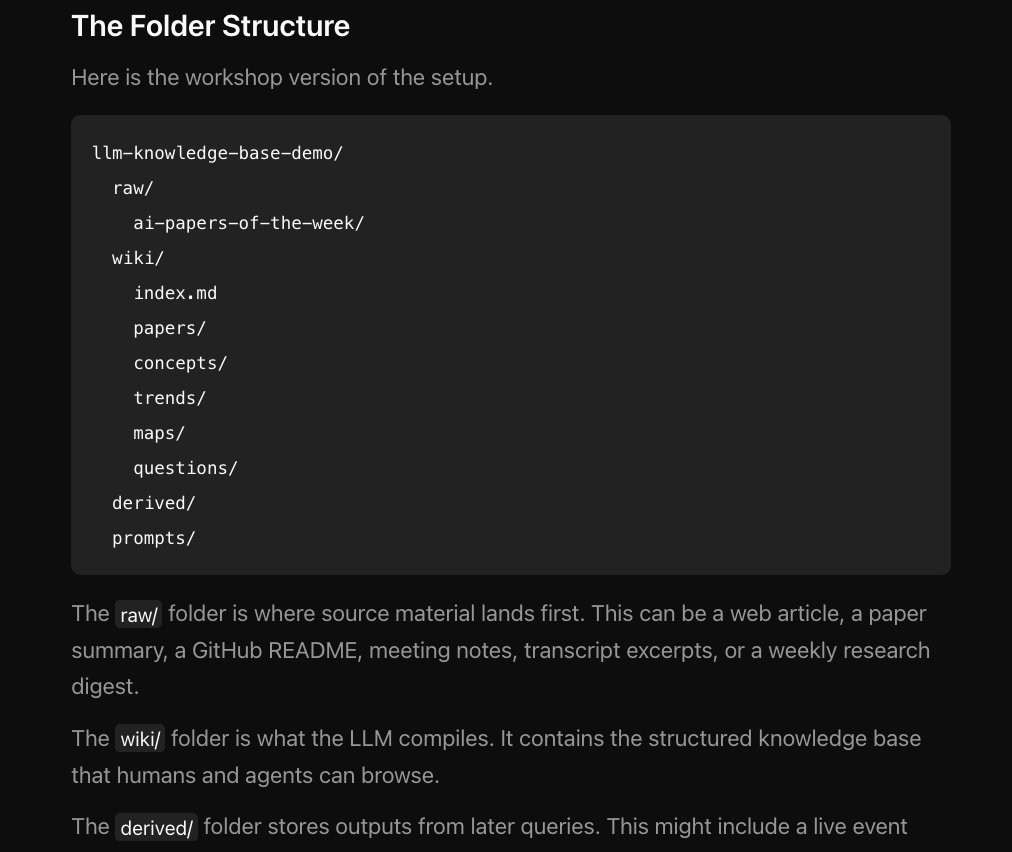
2. 教程:如何构建 LLM 知识库
本教程介绍了构建 LLM 知识库的实用方法,强调将 LLM 视为“编译器”而非仅仅是检索工具。作者建议将原始 Markdown 文件存放在 raw/ 文件夹中,通过 LLM 将其编译为结构化的 wiki/ 页面。这种方法不仅能处理文档,还能生成索引、阅读路径和总结,使知识库随时间推移而不断进化。教程通过 AI 论文周报的案例,展示了如何通过简单的 workflow 实现知识的沉淀与结构化,避免了过早引入复杂向量数据库的陷阱。
来源:How to Build an LLM Knowledge Base
Opinions/Thoughts
1. 论文:从技能文本到技能结构,提升 Agent 技能表示
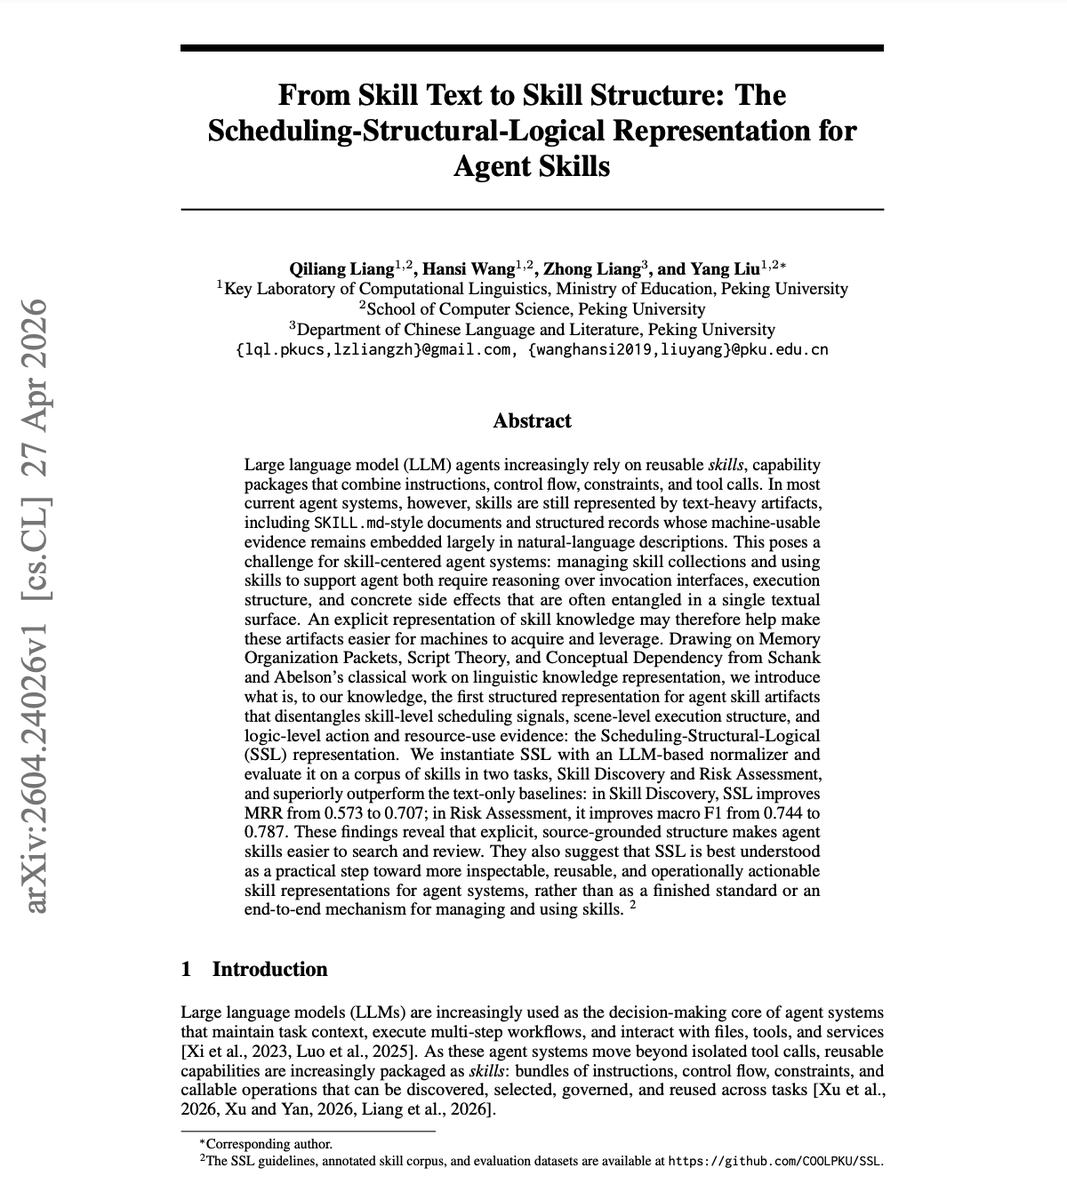
该论文针对当前 Agent 技能表示过于依赖非结构化文本(如 SKILL.md)的问题,提出了 SSL(调度-结构-逻辑)三层类型化 JSON 表示法。SSL 借鉴了 Schank 和 Abelson 的脚本理论,将技能拆解为调度层、结构层和逻辑层,从而使 Agent 更易于理解和执行。研究表明,通过 LLM 自动转换,技能发现的 MRR 从 0.573 提升至 0.707,风险评估的 F1 分数也有显著提高。该研究发布了包含 6184 个技能的语料库,为 Agent 技能库的规模化管理提供了新思路。
来源:arXiv.org
2. OpenAI 播客:AI 在数学研究中的突破与未来
OpenAI 研究员 Sébastien Bubeck 和 Ernest Ryu 在播客中探讨了 AI 在数学研究中的最新进展。他们分享了如何利用 GPT-5.4 Pro 解决困扰数学界 60 年的 Erdős 问题,并讨论了 AI 从简单的文献搜索向原创性数学发现的转变。播客深入探讨了 AI 在处理长周期研究任务中的角色、人类在模型改进过程中的定位,以及 AI 对数学研究范式的潜在影响。这一对话为理解 AI 如何辅助科学发现提供了前沿视角。
来源:Spotify
3. Armin Ronacher:GitHub 之前的开源世界
Armin Ronacher 在博文中回顾了 GitHub 崛起之前的开源生态。他指出,在 GitHub 成为事实标准之前,开源社区分散在 SourceForge、Bitbucket 以及个人维护的 Trac 和 Subversion 仓库中。他强调,GitHub 不仅仅是代码托管平台,更是开源社区的社交基础设施,促进了许多专业关系和友谊的建立。然而,随着 GitHub 近期的变化,他表达了对这种社交基础设施衰落的担忧,并呼吁社区思考开源协作的未来方向。

4. Manus 与 Cursor 的认知领先:技术路线与结果验证
本文分析了 Manus 和 Cursor 在 AI Agent 领域的认知领先地位。作者认为,Manus 的成功在于从第一性原理出发,将 LLM 视为通用智能体而非角色扮演者,通过任务拆解实现并行执行;Cursor 的成功则在于通过自训模型和 RL 迭代,解决了编程任务中的速度瓶颈。文章指出,中文互联网常见的“套壳”批评忽略了这些团队在 Agent 架构和训练链路上的深层认知差异。这种认知领先不仅体现在产品设计上,更体现在对 LLM 本质特征的深刻理解与技术路线的精准选择上。
来源:Manus 和 Cursor 的认知领先:技术路线与结果验证
5. Mitchell Hashimoto:Ghostty 决定迁出 GitHub
Mitchell Hashimoto 宣布其开源终端模拟器 Ghostty 将迁出 GitHub。作为 GitHub 的早期用户,他表达了对 GitHub 近期频繁宕机影响开发工作的失望。他指出,一个无法保证稳定性的平台已不再适合严肃的开源开发。这一决定引发了社区对 GitHub 作为开源协作基础设施稳定性的广泛讨论,并促使开发者开始重新评估开源项目的托管策略。