
Product
1. Grep 在三大深度研究基准测试中实现 SOTA
Grep 团队宣布其系统在 DRACO、DeepSearchQA 和 DeepResearch Bench 三大基准测试中均达到 SOTA 水准,超越了 Perplexity、Google、OpenAI 等行业领先者。Grep 引入了“Grep Brain”架构,通过类似细胞分裂的动态代理机制,而非传统的多代理协商,实现了从研究到交付的全流程自动化。该系统不仅能进行深度研究,还能生成幻灯片、报表等实际交付物。其核心优势在于通过文件级上下文追踪和任务规划,显著提升了引用准确性和逻辑深度。目前,Grep 已被多家金融和科技企业用于高风险决策场景。
来源:Grep achieves SOTA on major deep research benchmarks
2. 微软 Memento:教 LLM 自主管理上下文压缩
微软研究团队发布 Memento,这是一种教导推理模型在生成过程中自主压缩思维链(CoT)的技术。通过将思维过程分割为语义块并生成“记忆(Memento)”,模型能够丢弃冗余的 KV 缓存,实现 2-3 倍的内存节省和吞吐量翻倍。研究发现,被删除的思维块信息会通过 KV 缓存的隐式通道保留,对准确性贡献显著。该方案通过约 3 万条标注数据进行 SFT 训练,无需外部总结器或复杂的编排层。此项研究揭示了上下文管理应作为模型的一种习得技能,而非单纯的系统工程问题。
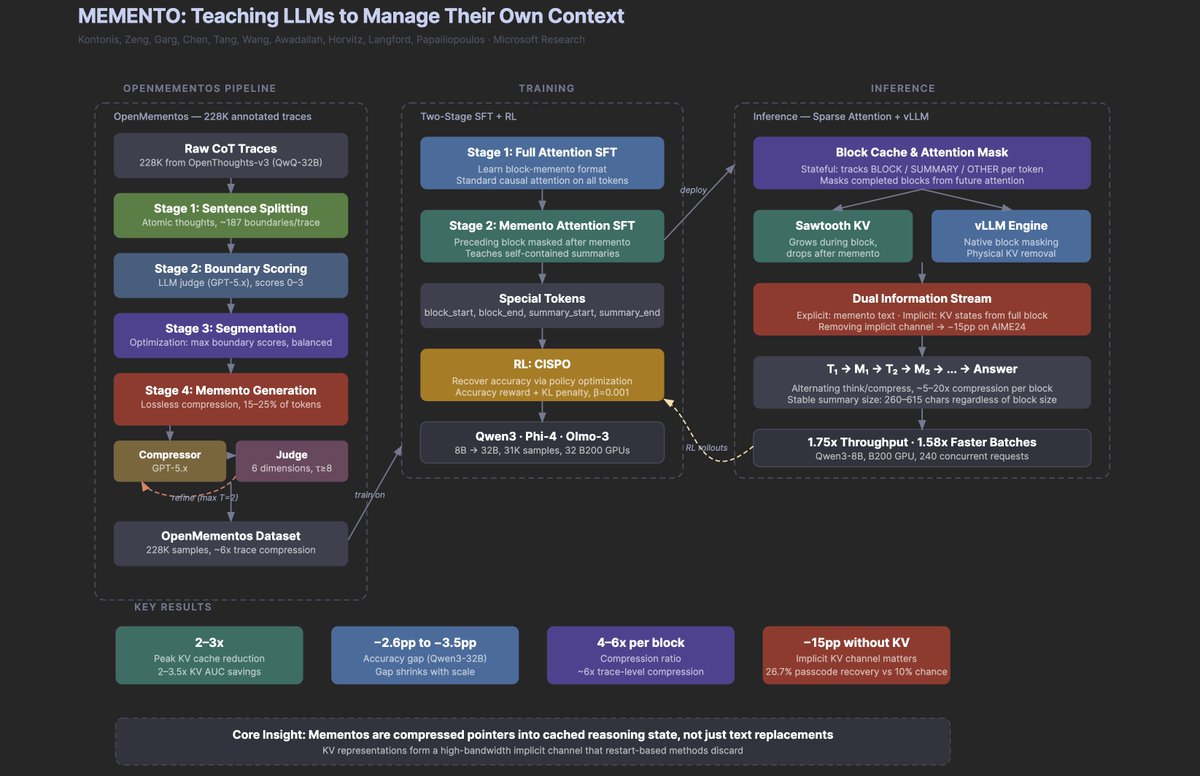
来源:Memento: Teaching LLMs to Manage Their Own Context
3. Shopify 发布 AI 工具包,支持主流代理集成
Shopify 正式推出 AI 工具包(AI Toolkit),旨在将 AI 代理与 Shopify 开发平台及店铺管理功能深度集成。该工具包支持 Claude Code、Codex、Cursor 等主流 AI 工具,通过插件、技能或 MCP 服务器提供 API 模式、文档和代码验证功能。此举旨在确保 AI 代理在处理 Shopify 业务时能够遵循正确的实现逻辑,而非盲目猜测,从而提升电商自动化运维的准确性和效率。
来源:Shopify
4. Claude Code CLI 2.1.98 更新:引入监控工具与安全增强
Claude Code CLI 发布 2.1.98 版本,引入了多项关键功能和安全修复。新增 Monitor 工具用于实时流式传输后台脚本事件,支持 PID 命名空间隔离以增强沙箱安全性。更新还包括 Google Vertex AI 设置向导、Perforce 模式支持以及对 Bash 工具权限绕过漏洞的修复。此外,该版本改进了 OTEL 追踪功能,并优化了大型代码库中的上下文管理和子代理协作逻辑,进一步提升了代理在复杂开发环境中的可靠性。
来源:GitHub
5. Anthropic 推出“顾问策略”:以 Sonnet 成本实现 Opus 智能
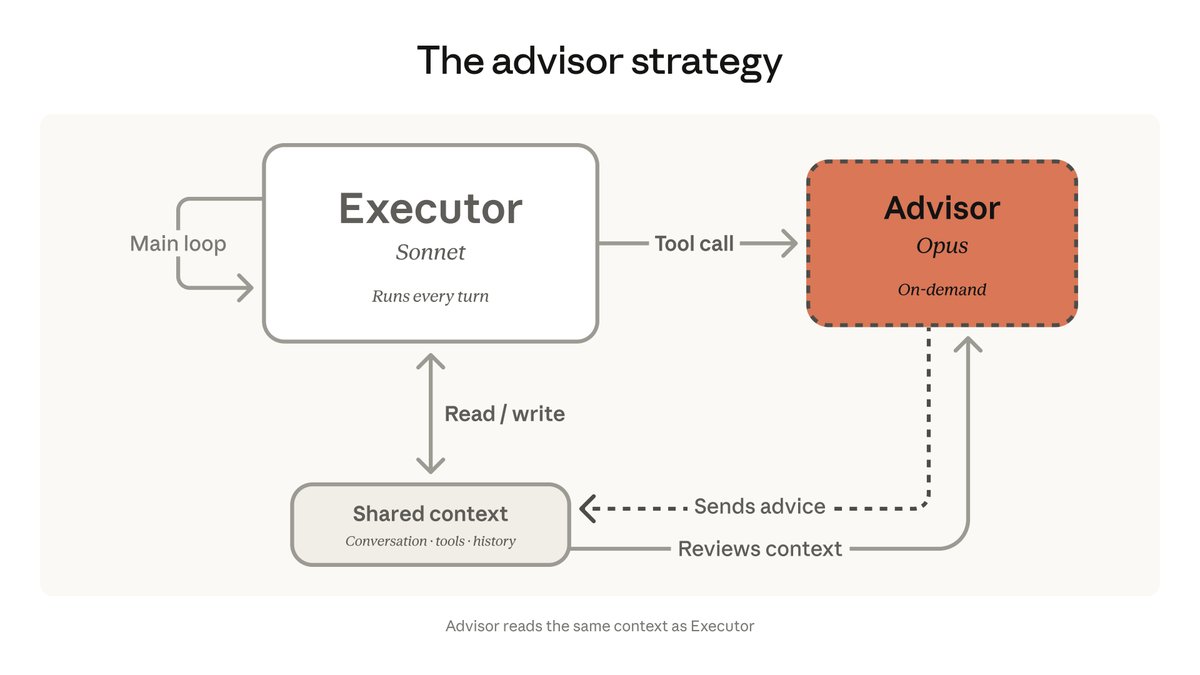
Anthropic 推出“顾问策略(Advisor Strategy)”,允许开发者将 Claude 3.5 Sonnet 或 Haiku 作为执行者,将 Opus 作为顾问。当执行者遇到难以解决的决策时,会咨询 Opus 获取计划或修正建议,随后继续执行。这种模式在 SWE-bench Multilingual 测试中,以 Sonnet 的成本实现了接近 Opus 的性能,且无需额外的 API 往返。该功能通过 API 请求头中的
advisor-tool启用,旨在平衡智能与成本,为构建高性价比的 AI 代理提供了新方案。
来源:@aigclink
6. Garry Tan 开源 GBrain:基于 Markdown 的个人知识库
Garry Tan 开源了 GBrain,这是一个基于 Markdown 和 Git 的个人知识管理系统,旨在构建 Vannevar Bush 构想的“Memex”。GBrain 不依赖复杂的数据库,通过简单的文件结构存储会议记录、笔记、想法和人际关系。该系统利用 AI 代理在后台进行“梦境循环(Dream Cycle)”,自动整理、丰富实体并修复引用。对于规模较大的知识库,GBrain 支持集成 Postgres 和 pgvector 进行向量检索。该项目展示了如何通过简单的文件系统和 AI 代理构建高效的个人第二大脑。
来源:GitHub
7. Warp 推出定时代理(Scheduled Agents)功能
Warp 平台推出了定时代理(Scheduled Agents)功能,允许用户在云端按 Cron 表达式自动运行 AI 代理。该功能适用于死代码清理、依赖维护、工单分类或定期重构等重复性任务。每个定时任务都在干净的会话中运行,拥有独立的任务历史和执行记录。通过将维护工作自动化,开发团队可以减少手动干预,确保代码库的持续健康。该功能进一步扩展了 AI 代理在 DevOps 和自动化运维领域的应用场景。
来源:Scheduled Agents | Agents | Warp
8. pi-monitor:为 AI 代理提供后台进程监控
pi-monitor 是一个专为 pi 代理设计的工具,允许代理在后台运行 Bash 命令并实时监控输出。它将输出流式传输到 Glimpse 窗口,并将日志、PID 和退出代码持久化到磁盘。当进程完成时,pi 会自动收到通知。这种设计使得代理能够处理长耗时任务(如构建、测试、服务器启动),而无需阻塞主会话。该工具通过简单的文件系统接口管理进程生命周期,极大地提升了代理在复杂开发任务中的异步处理能力。
来源:GitHub
9. OpenAI 推出 100 美元/月 Pro 订阅档位
OpenAI 宣布推出全新的 ChatGPT Pro 订阅档位,定价为 100 美元/月。该档位提供 5 倍于 Plus 版的 Codex 使用额度,旨在满足长会话、高强度编程任务的需求。Pro 用户仍可享受所有 Pro 功能,包括独占模型及无限量的 Instant 和 Thinking 模型访问。为庆祝发布,OpenAI 在 5 月 31 日前为 Pro 用户提供高达 10 倍的 Codex 使用额度。此举旨在通过差异化定价,更好地支持重度开发者用户。
来源:@OpenAI
10. Google Gemini 音乐模型 Lyria 3 开放免费生成
Google 宣布 Gemini 应用中的音乐模型 Lyria 3 开放免费生成功能。用户每天可免费生成最多 5 首全长曲目(约 3 分钟),超出限额后可继续生成 30 秒片段。这一更新旨在让更多用户体验 AI 音乐创作的乐趣。随着图像、视频和音乐生成能力的整合,Gemini 正在成为一个全方位的多模态创作平台。此举进一步降低了 AI 音乐创作的门槛,推动了生成式 AI 在创意产业的普及。
11. Anthropic 博客:顾问策略详解
Anthropic 在官方博客中详细介绍了“顾问策略(Advisor Strategy)”。该策略通过将 Opus 作为顾问,Sonnet 或 Haiku 作为执行者,实现了智能与成本的平衡。执行者负责全程任务,仅在遇到难以解决的决策时咨询 Opus。这种模式不仅降低了成本,还提升了代理在复杂任务中的表现。Anthropic 强调,该策略通过 API 即可实现,无需复杂的编排,是构建高效 AI 代理的推荐方案。
来源:Claude
12. NousResearch Hermes Agent:Manim 动画生成技能
NousResearch 的 Hermes Agent 引入了 Manim 视频生成技能,允许用户通过文本提示创建 3Blue1Brown 风格的数学和技术动画。该代理负责从创意规划、Python 代码生成到渲染和场景拼接的全流程。该技能支持概念解释、公式推导、算法可视化等多种应用场景。通过将复杂的动画制作流程自动化,Hermes Agent 进一步扩展了其在技术内容创作领域的应用能力。
来源:GitHub
13. Diarize:AI 驱动的音视频转录工具
Diarize 是一个 AI 驱动的音视频转录工具,支持 YouTube、Instagram 和 TikTok 链接。它结合了先进的语音识别模型与自动校正功能,能够提供带有说话人识别的专业级转录结果。该工具在几分钟内即可完成长视频的转录,并支持说话人名称建议和合并。对于需要快速将视频内容转化为可发布文本的创作者来说,Diarize 提供了一个高效的解决方案。
来源:diarize - AI-powered audio and video transcription
14. Factory AI:原生多代理编排平台
Factory AI 推出了 Droids 平台,具备原生的多代理编排能力。其桌面应用允许用户管理多个子代理,共同协作完成复杂任务。用户可以实时监控每个代理的工作进度,并在必要时进行干预或注入上下文。这种设计旨在解决多代理协作中的透明度和可控性问题,使复杂的自动化任务变得更加直观和可管理。
来源:@FactoryAI
Tutorial
1. Impeccable:AI 驱动的前端设计指令集
Impeccable 是一套专为 AI 代理设计的前端设计指令集,包含 21 个指令,涵盖创造、评估、优化、简化和加固五个阶段。它通过定义一套共享的设计词汇,帮助 AI 代理避免常见的视觉错误(如过度使用渐变、对比度不足等)。Impeccable 不仅提供 CLI 工具处理代码库,还支持 Chrome 扩展进行实时检测。该工具旨在通过确定性的模式匹配而非单纯依赖 LLM,提升 AI 生成界面的专业度和一致性。
来源:Impeccable: Design skills for AI harnesses
2. 优化大型代码库中的 @-mention 性能
Boris Cherny 分享了如何将 Claude Code 在大型企业代码库中的 @-mention 响应速度提升 3 倍。通过优化文件索引机制和查询引擎,系统能够更高效地处理海量代码上下文。他展示了通过让 Opus 将文件索引器移植到原生 TypeScript,并结合性能分析,成功将 P99 延迟降低至 10ms 以下。这一案例展示了在 AI 编程代理中,通过底层工程优化解决大规模代码库交互延迟的重要性。
来源:@bcherny
3. DAIR.AI 发布 Claude Code 备忘录
DAIR.AI 发布了 Claude Code 备忘录(Cheat Sheet),汇总了所有命令、快捷键、最佳实践和工作流模式。该备忘录涵盖了键盘快捷键、斜杠命令、内存配置、MCP 服务器、技能与代理等八个部分,并提供交互式搜索和示例。对于希望快速上手 Claude Code 或提升开发效率的开发者来说,这是一个极佳的参考资源。该备忘录不仅整理了官方文档,还融入了社区总结的 pro tips,有助于用户更深入地掌握代理工具。
来源:Claude Code Cheat Sheet | DAIR.AI Academy
4. Augment Code:AI 原生转型路径
Augment Code 发布了关于 AI 原生转型的端到端路径指南。该指南探讨了企业如何通过 AI 代理重塑软件开发生命周期(SDLC),从代码生成到测试和部署的全面自动化。Augment Code 强调了 AI 代理在提升开发效率和代码质量方面的作用,并为企业提供了从试点到规模化落地的实操建议。这一指南对于希望在企业内部推动 AI 编程代理落地的团队具有参考价值。
来源:The AI-native transformation path, end to end
Opinions/Thoughts
1. Vercel 提出“代理基础设施”概念
Vercel 创始人 Guillermo Rauch 提出“代理基础设施(Agentic Infrastructure)”概念,认为随着 AI 代理成为软件开发的主力,基础设施必须从服务人类转向服务机器。目前 Vercel 上 30% 的部署由 AI 代理发起,且代理部署的项目调用 AI 推理的频率是人类的 20 倍。未来的基础设施需具备自配置、自修复、自优化和自安全能力。这一转型标志着软件开发从“人机协作”向“代理自主构建”的范式转移,基础设施将成为代理生态的运行时环境。
来源:Vercel
2. 综述:LLM Agent 的“外化”演进路径
这篇综述文章探讨了 Agent 能力从参数(Weights)到上下文(Context)再到运行时环境(Harness)的演进。作者认为,Agent 的核心能力不再仅仅存在于模型权重中,而是存在于模型与外部基础设施(记忆库、技能库、协议层)的协议中。这种“认知外化”过程类似于人类通过工具和制度扩展智能。文章指出,未来的竞争优势不在于模型参数规模,而在于谁能构建出更高效、更可靠的 Agent 运行时环境,这标志着 AI 研究从“模型中心”向“系统中心”的本体论转向。

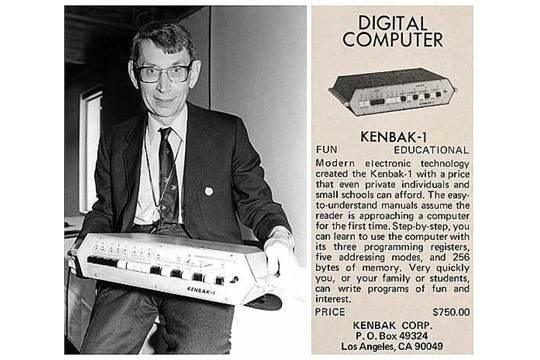
3. Alfred Lin:从“玩具”问题中寻找战略高度
Alfred Lin 在文章中探讨了战略高度的重要性,指出许多战略错误源于视角偏差。他引用 Feynman 的“玩具问题”方法,说明通过解决简化版的任务可以构建核心架构,进而扩展到复杂场景。Amazon 从图书起步、Apple 从 iPod 起步,都是通过解决“玩具问题”来建立运营肌肉。他强调,当人们 dismiss 某项技术为“玩具”时,往往是未来范式转移的信号。优秀的创始人能够灵活切换视角,既能深入细节解决具体痛点,又能站在高处把握市场架构。


4. Karpathy:AI 能力认知的两极分化
Andrej Karpathy 指出,当前公众对 AI 能力的认知存在严重脱节。第一类人基于去年的免费版 ChatGPT,认为 AI 充满幻觉且能力有限;第二类人则深度使用 Claude Code 等前沿代理工具,在编程和数学领域见证了 AI 的惊人表现。这种差异源于两点:一是前沿模型在编程等具有明确奖励函数(如单元测试)的领域进步极快;二是企业在 B2B 场景中对这些高价值领域的投入远超通用写作。两类人虽然都在谈论 AI,但实际上讨论的是完全不同的技术水平。
来源:@karpathy
5. 论文:BM25 在深度研究中的持久价值
arXiv 论文《Revisiting Text Ranking in Deep Research》指出,在深度研究场景中,经过适当配置的词法检索器 BM25 在多数情况下仍优于神经排序器。研究发现,GPT-OSS-20B 结合 BM25 在段落语料库上实现了最高的答案准确率。虽然基于 BERT 的稀疏和多向量检索器泛化能力更强,但重排序(Re-ranking)依然是提升检索效果的有效手段。这一结论挑战了“神经检索器全面取代传统检索”的观点,强调了在 AI 代理系统中合理配置基础检索组件的重要性。
来源:arxiv.org