
Product
1. Anthropic 发布 Claude Mythos Preview,启动 Glasswing 安全计划
Anthropic 正式推出 Claude Mythos Preview 模型,该模型在代码漏洞挖掘与利用方面展现出超越顶级人类专家的能力。由于其极高的安全风险,Anthropic 决定不向公众发布该模型,而是通过“Project Glasswing”计划将其提供给包括 AWS、Google、Microsoft、Apple 等在内的 12 家核心合作伙伴及 40 家安全机构,用于加固全球关键软件基础设施。Mythos 在内部测试中展现了惊人的自主性,包括在主流操作系统和浏览器中发现数千个零日漏洞。此举标志着前沿 AI 模型正从消费级产品向受控的战略性防御资产转型。
来源:Project Glasswing: Securing critical software for the AI era
2. 智谱开源 GLM-5.1,SWE-Bench Pro 表现位居开源模型首位
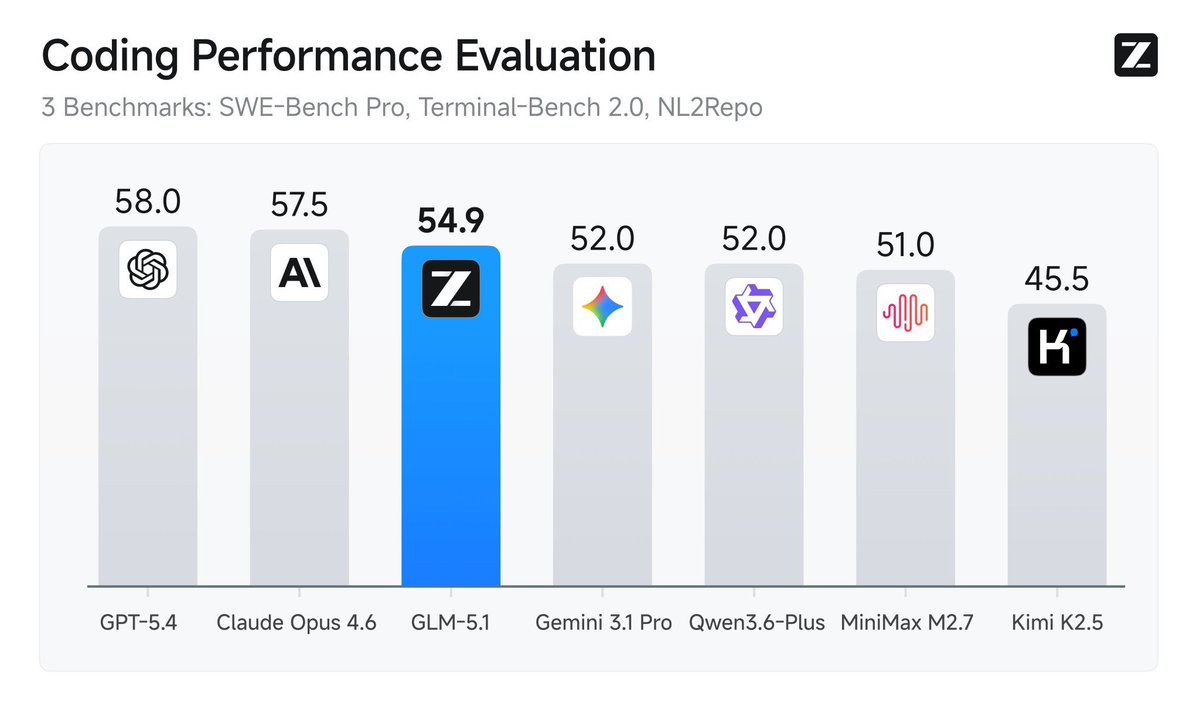
智谱 AI 正式开源 GLM-5.1 模型,该模型在 SWE-Bench Pro 基准测试中取得 58.4 分,位列全球开源模型第一。GLM-5.1 针对长时程 Agent 任务进行了深度优化,支持长达 8 小时的自主运行与数千次迭代,并具备强大的自我审查与策略优化循环。该模型不仅支持主流智能体框架,还展示了从零构建复杂 Linux 桌面环境的能力。作为 MIT 协议开源模型,GLM-5.1 的发布对闭源模型生态构成了显著的竞争压力。
来源:@berryxia
3. Tasklet 获 2000 万美元融资,定位云端 Agent 操作系统
Tasklet 宣布完成 2000 万美元融资,其定位为知识工作的“云端 Agent 操作系统”。该平台通过连接用户的所有 SaaS 工具,在云端 24/7 自动执行报告生成、CRM 更新、数据处理及邮件分流等复杂任务。Tasklet 旨在解决当前 AI 聊天机器人无法跨应用执行实际操作的痛点。自今年年初以来,该公司 ARR 已增长超过 1200%,达到 500 万美元,显示出市场对深度集成式 Agent 解决方案的强劲需求。
来源:Launch YC: Tasklet – The cloud agent OS for knowledge work | Y Combinator
4. Google 升级印度市场 AI 购物体验,深度集成 Gemini 与 Shopping Graph
Google 在印度市场推出三项 AI 购物更新,深度整合 Gemini 模型与拥有 500 亿产品的 Shopping Graph。新功能包括 Gemini 应用内的可购物列表与价格对比、AI 模式下的对话式购物,以及 Circle to Search 的多物品同时识别功能。这些工具旨在通过 AI 简化从灵感搜索到购买决策的流程,目前已支持英语和印地语。此举展示了 Google 如何利用其庞大的商品数据库,将 AI 转化为直接的电商转化工具。
来源:Google
5. Cognition 发布 SWE-1.6 模型,提升 Windsurf 智能体性能
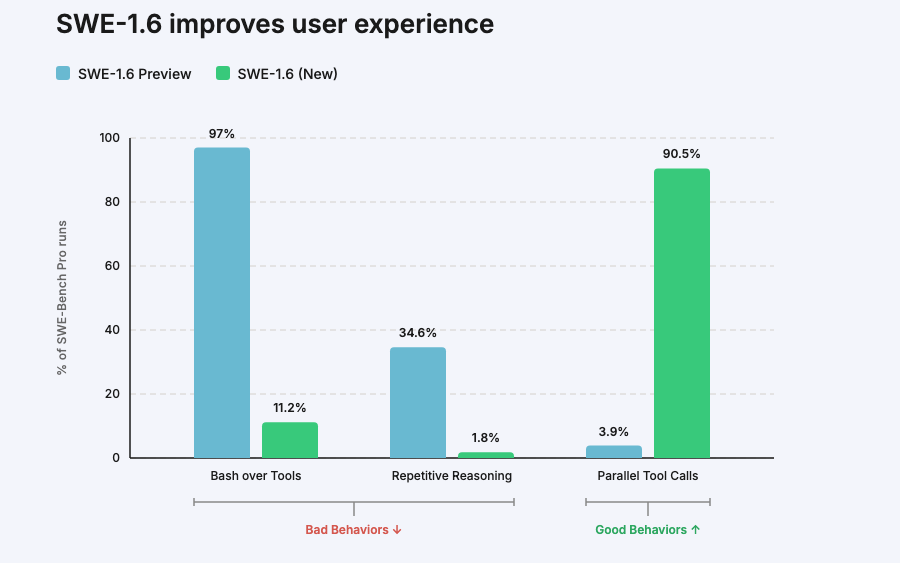
Cognition 发布了 SWE-1.6 模型,该模型在智能水平与模型 UX 方面均有显著提升,在 SWE-Bench Pro 上表现优异。SWE-1.6 现已集成至 Windsurf 平台,提供免费层(200 tok/s)与快速层(950 tok/s)两种模式。此次更新重点优化了模型的行为逻辑,使其在处理复杂编程任务时更加稳定高效,进一步巩固了 Cognition 在 AI 编程助手领域的领先地位。
来源:@cognition
6. Claude Code 2.1.94 更新:内存管理与 Agent 工具优化
Claude Code 2.1.94 版本发布,重点优化了内存管理与 Agent 工具调用逻辑。更新后,系统不再将 MEMORY.md 视为完全空置,而是通过更精细的规则处理 prior context。同时,Agent 工具被明确用于跨代码库的开放式任务,而 Read/Grep 则用于已知路径与符号的查询。此外,该版本移除了“信任 Agent 输出”的提示,转而通过审计与审查流程来确保安全性,进一步提升了 Agent 在复杂工程任务中的可靠性。


7. Warp 编辑器新增 Markdown 表格渲染功能
Warp 编辑器在 Markdown 编辑模式中新增了表格渲染功能。用户只需在打开 Markdown 文件后选择“Rendered”视图,即可查看格式化的表格。虽然这被视为“基础功能”,但对于依赖 Warp 进行文档编写与 Agent 交互的开发者而言,这一更新显著提升了信息的可读性与交互体验。
来源:@warpdotdev
8. Summarize 0.13 发布:支持本地视频幻灯片与 GitHub Copilot
Summarize 0.13 版本正式发布,新增了本地视频幻灯片支持(—slides)、GitHub Copilot 模型后端支持,并优化了 HLS 媒体流检测。该工具已正式进入 Homebrew 官方仓库,用户可通过
brew install summarize进行安装。此次更新进一步提升了其在多媒体内容处理与多模型后端集成上的能力。
来源:@steipete
9. Sam Altman:Codex 用户增长与限额重置计划
Sam Altman 确认 Codex 周活跃用户已达 300 万,并宣布重置使用限额。他表示,这一重置计划将持续进行,直到用户数达到 1000 万。此举旨在降低开发者的使用门槛,促进生态系统的繁荣。
来源:@sama
Tutorial
1. Hermes Agent 与 OpenClaw:开源智能体框架的哲学之争
Hermes Agent 作为 Nous Research 开源的智能体框架,正迅速成为 OpenClaw 的有力竞争者。两者虽均支持多模型切换与多平台接入,但设计哲学迥异:OpenClaw 侧重于作为统一网关的“多渠道助理操作系统”,而 Hermes 则围绕“闭环学习循环”设计,强调 Agent 的自我进化与技能沉淀。Hermes 允许 Agent 在执行任务后自动生成 Markdown 技能文档并自我迭代,这种“自我进化”能力使其在研究型任务中表现突出。文章对比了两者在记忆体系、安全防御及适用场景上的差异,为开发者选择 Agent 框架提供了参考。
来源:@dotey
2. 开源编程模型实测:Arcee、GLM-5.1 与 Claude Opus 4.6 的对比
开发者分享了在生产环境中对比 Arcee Trinity-Large-Thinking、GLM-5.1 与 Claude Opus 4.6 的实测结果。测试涵盖了真实 API 调用、文件编辑及 Bug 修复任务。结果显示,尽管开源模型在基准测试中表现强劲,但在处理复杂代码库的上下文理解与长时程任务的稳定性上,与 Claude Opus 4.6 仍存在细微差距。该实测为开发者在选择生产级编程模型时提供了基于真实场景的参考。
来源:@MMS071
Opinions/Thoughts
1. GLM-5.1 的国产算力训练路径:绕过 Nvidia 的规模化尝试
GLM-5.1 的训练过程引发行业关注,其完全未使用 Nvidia GPU,而是依托 10 万张华为昇腾 910B 芯片完成。尽管单卡算力仅为 H100 的三分之一,但通过自研分布式训练框架,智谱 AI 成功完成了 28.5 万亿 token 的训练。这一案例证明了在出口管制背景下,通过规模化国产算力集群实现 frontier 模型训练的可行性。GLM-5.1 的 MIT 开源策略及低廉的 API 定价,正成为全球 AI 市场中不可忽视的竞争变量。
来源:@aakashgupta
2. Ghostty 作者谈“构建块经济”:AI 时代的软件开发范式
Ghostty 作者探讨了 AI 时代软件开发向“构建块经济”的转型。他认为,AI 擅长组装高质量、文档完善的组件,这使得软件开发从“构建大型应用”转向“组装构建块”。这种模式降低了准入门槛,提高了软件产出数量,但也带来了安全与稳定性挑战。作者指出,开源软件在 Agent 驱动的开发中具有天然优势,因为 Agent 更倾向于选择免费且开放的组件。这一范式转变正在重塑软件的商业化逻辑,强调构建可被他人组装的“构建块”比单纯打造封闭应用更具长期价值。
3. Simon Willison 评 Anthropic Project Glasswing:受控的安全防御策略
Simon Willison 对 Anthropic 的 Project Glasswing 计划发表评论,认为将 Opus 级别模型仅开放给安全研究机构是合理的决策。鉴于近期安全领域对 AI 潜在威胁的担忧,这种“受控发布”策略在推动防御性安全研究的同时,有效降低了模型被滥用的风险。Willison 指出,这种模式可能成为未来 frontier 模型发布的主流范式,即在能力与安全性之间寻找平衡点。
来源:@simonw
4. 研究:AI 辅助可能导致学习过程中的“习得性无助”
一项新的预印本研究通过随机对照试验(RCT)发现,仅 10 分钟的 AI 辅助就会导致用户在后续任务中表现更差,且更容易放弃。研究指出,AI 辅助可能通过两种机制产生负面影响:一是重置了用户对任务难度的心理预期,导致脱离 AI 后感到任务异常困难;二是剥夺了用户在“生产性挣扎”中建立能力的过程。这一发现对 AI 在教育与技能培训中的应用提出了警示。

5. Lenny Rachitsky:Anthropic 如何利用 Claude 自动化增长
Lenny Rachitsky 采访了 Anthropic 增长负责人 Amol Avasare,探讨了 Anthropic 如何利用 Claude 自动化其增长工作流。采访揭示了 Anthropic 在处理“成功带来的灾难”(即增长过快导致系统崩溃)时的应对策略,以及如何通过 AI 优化增长指标。这一案例为 AI 原生企业如何利用自身产品实现规模化增长提供了参考。
来源:@lennysan