
Product
1. Claude Code 引入 Computer Use 功能,实现 GUI 自动化
Anthropic 在 Claude Code 中正式引入 Computer Use 功能,允许 AI 代理直接操控 macOS 桌面环境。该功能支持打开应用、点击 UI 元素、输入文本及屏幕截图,填补了此前 CLI 代理无法处理图形界面任务的空白。开发者现在可以在终端内完成原生应用验证、视觉 Bug 调试及 GUI 工具自动化,无需离开工作流。该功能目前处于 Pro 和 Max 计划的研究预览阶段,通过 /mcp 命令启用,并具备单会话隔离和应用审批机制,旨在提升端到端测试的效率。
来源:Let Claude use your computer from the CLI - Claude Code Docs
2. OpenAI 发布官方 Codex 插件,正式接入 Claude Code 生态
OpenAI 发布了官方插件 codex-plugin-cc,允许开发者在 Claude Code 工作流中直接调用 Codex 进行代码审查或任务委派。该插件提供 /codex:review、/codex:adversarial-review 和 /codex:rescue 三个核心命令,支持标准审查、对抗性挑战及任务接管。技术上,它通过本地 Codex CLI 和 app server 中转,复用现有的认证与配置,无需额外运行时。此举不仅是工具集成,更体现了 OpenAI 主动将自身模型能力嵌入竞争对手生态的战略意图。
来源:GitHub
3. PraisonAI:高性能多智能体框架,支持 100+ 模型
PraisonAI 是一个开源的多智能体框架,主打极高的实例化速度(平均 3.77 微秒),在基准测试中显著优于 LangGraph 等现有框架。该框架支持单智能体、多智能体并行、路由及评估器-优化器模式,并内置了持久化记忆、MCP 协议支持及 24/7 自动调度功能。它兼容 OpenAI、Anthropic、Gemini、DeepSeek 等 100 多种模型,用户仅需修改一行代码即可切换模型。对于追求生产环境稳定性和低代码开发体验的团队,PraisonAI 提供了一个兼顾灵活性与性能的解决方案。

来源:GitHub
4. Google 发布 Gemini API Skills,提升代理开发效率
Google AI Developers 发布了 Gemini API Skills 库,旨在解决大模型在快速迭代的 SDK 和最佳实践面前的知识滞后问题。该库包含针对 Gemini API、Vertex AI 和 Gemini Live API 的专用技能,通过提供实时文档和更新的编码原语,显著提升了代理生成正确代码的能力。评估显示,使用该技能后,Gemini 3 Pro 在相关任务上的成功率提升至 96%。这是一种轻量级的上下文增强技术,为构建高质量 AI 代理提供了标准化的工程路径。
来源:GitHub
5. Pokee AI 发布 PokeeClaw,主打企业级安全代理
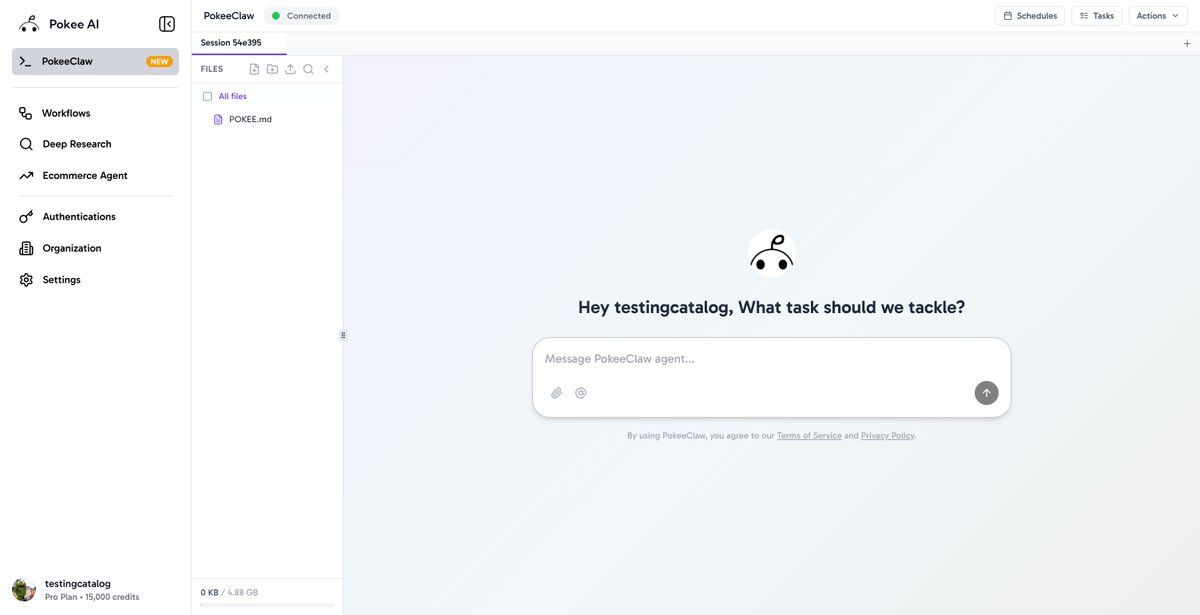
Pokee AI 推出了 PokeeClaw,一款面向专业人士的 24/7 运行 AI 代理平台,支持 1000+ 应用集成。该平台强调企业级安全,提供完全隔离的沙箱环境、审计日志及访问控制,旨在处理复杂的投资备忘录撰写、销售仪表板构建等高难度任务。与通用型代理不同,PokeeClaw 侧重于长周期、高复杂度的专业工作流,通过持久化记忆和跨工具操作能力,试图将 AI 代理从“聊天机器人”升级为“企业员工”。
来源:Pokee
6. Exo:基于 Claude Code 的 AI 原生开源邮件客户端
Exo 是一款开源的 AI 原生桌面邮件客户端,将 AI 视为核心而非附加功能。该应用利用 Claude Code 的能力,自动对收件箱进行分类(高/中/低优先级)、生成上下文感知的回复草稿,并支持通过自然语言反馈进行迭代修改。Exo 能够学习用户的写作风格,并自动搜索发件人背景信息,旨在实现“零认知负荷”的收件箱管理。对于寻求深度 AI 集成以提升沟通效率的开发者,Exo 提供了一个极具参考价值的 AI 优先产品范式。

来源:GitHub
7. 微软 M365 Copilot 引入 Council 多模型协作模式
微软在 M365 Copilot 中推出了名为“Council”的新模式,允许用户在同一提示词下同时运行多个模型。该模式旨在通过多模型并行执行,帮助用户对比不同模型的输出,识别对齐与分歧点,从而获得更全面、更具批判性的分析结果。这一功能反映了企业级 AI 应用正在从单一模型依赖转向多模型协作,以降低幻觉风险并提升决策质量。对于需要高可靠性输出的商业场景,Council 模式提供了一种有效的验证机制。
8. 阿里发布 Qwen3.5-Omni,强化多模态理解能力
阿里巴巴发布了 Qwen3.5-Omni 模型,主打全模态理解能力,在音视频理解任务上表现出色。该模型支持长达 10 小时的音频输入和 1 小时的视频上下文,能够实现“音视频 Vibe Coding”,即通过白板草图或游戏片段直接生成可运行代码。Qwen3.5-Omni 支持 74 种语言识别和 29 种语言生成,进一步缩小了人类意图与机器执行之间的鸿沟。对于需要处理复杂多模态数据的开发者,该模型提供了一个强大的开源替代方案。

9. Amp 宣布免费版去广告,应对 frontier 模型竞争
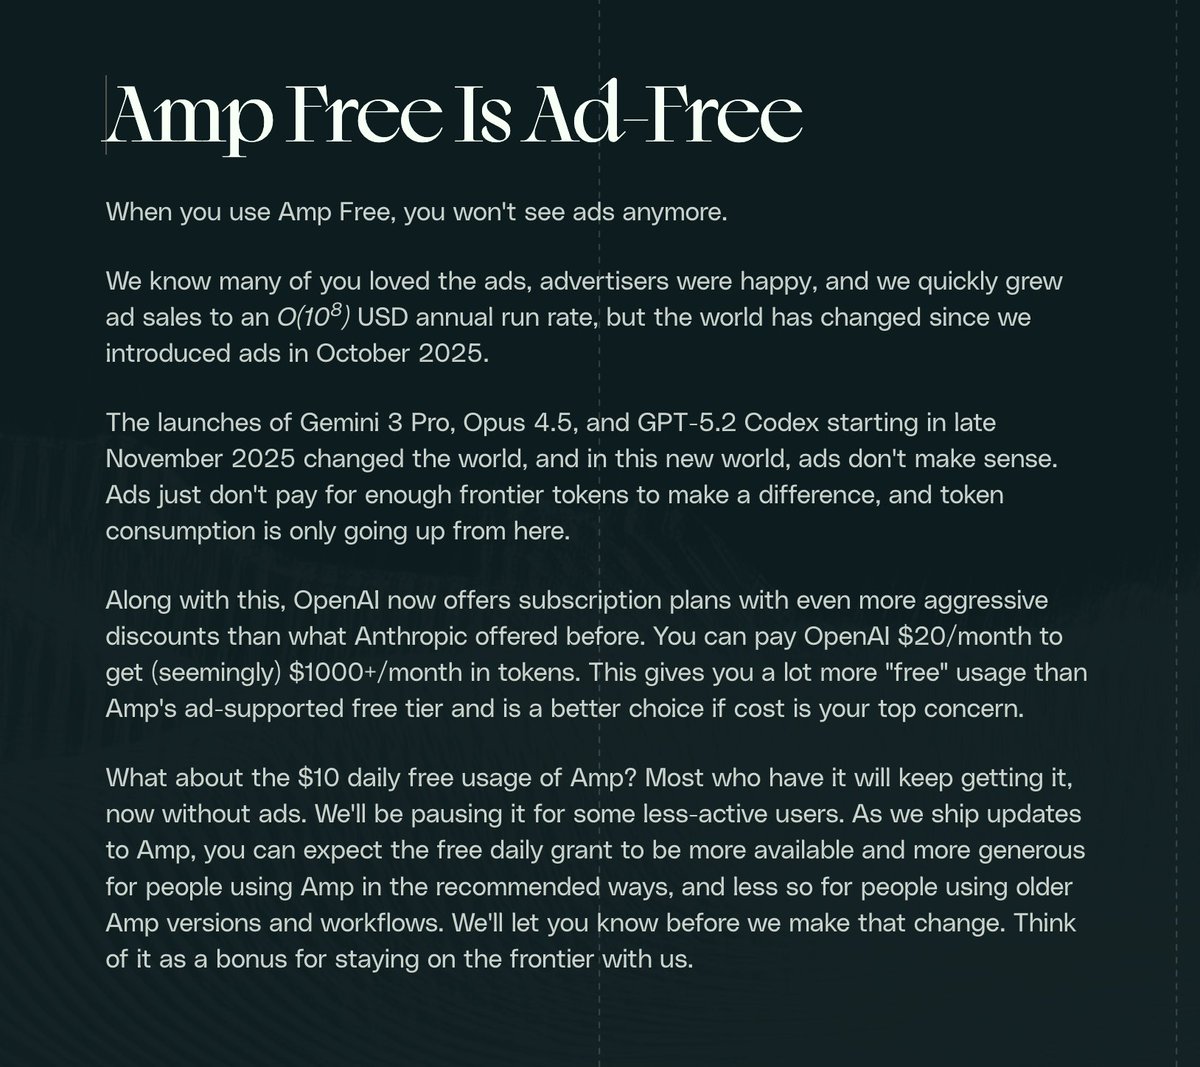
Amp 宣布其免费版将彻底移除广告。此前 Amp 曾通过广告模式实现了千万美元级的年化收入,但随着 Gemini 3 Pro、Opus 4.5 和 GPT-5.2 Codex 等前沿模型的发布,广告模式已无法覆盖高昂的推理成本。Amp 决定调整策略,将免费额度更多地向推荐工作流倾斜,并暗示未来将根据用户的使用方式动态调整免费额度。这一变动反映了 AI 基础设施领域激烈的成本竞争,以及模型能力提升对商业模式的倒逼。
10. here.now:为 AI 代理提供即时 Web 托管服务
here.now 是一项为 AI 代理设计的即时 Web 托管服务,允许代理直接将文件或文件夹发布到 Web 并获取实时 URL。该服务支持 HTML、CSS、JS、图片、PDF 等多种格式,无需账户即可使用。通过简单的 CLI 命令,代理可以快速部署客户仪表板、聊天机器人或联系表单等应用。对于需要快速验证想法或展示代理成果的开发者,here.now 提供了一个极低摩擦的部署路径,进一步降低了 AI 代理构建应用的门槛。
来源:here.now
11. agent-browser 仪表板更新,支持多浏览器会话管理
agent-browser 仪表板迎来更新,支持从单一 UI 管理多达 6 个浏览器的会话。该工具支持在本地引擎(Chrome, Lightpanda)或云端提供商(Browser Use, Browserbase 等)上启动会话,并允许用户直接在仪表板内创建、查看和关闭会话。作为 AI 代理的浏览器自动化 CLI,agent-browser 提供了快速的原生 Rust 实现,极大简化了代理进行 Web 交互的复杂性。对于需要大规模并行 Web 任务的代理开发者,这一更新显著提升了调试和管理效率。

来源:GitHub
12. PiClaw v1.7.2 发布,新增 Office 文档处理能力
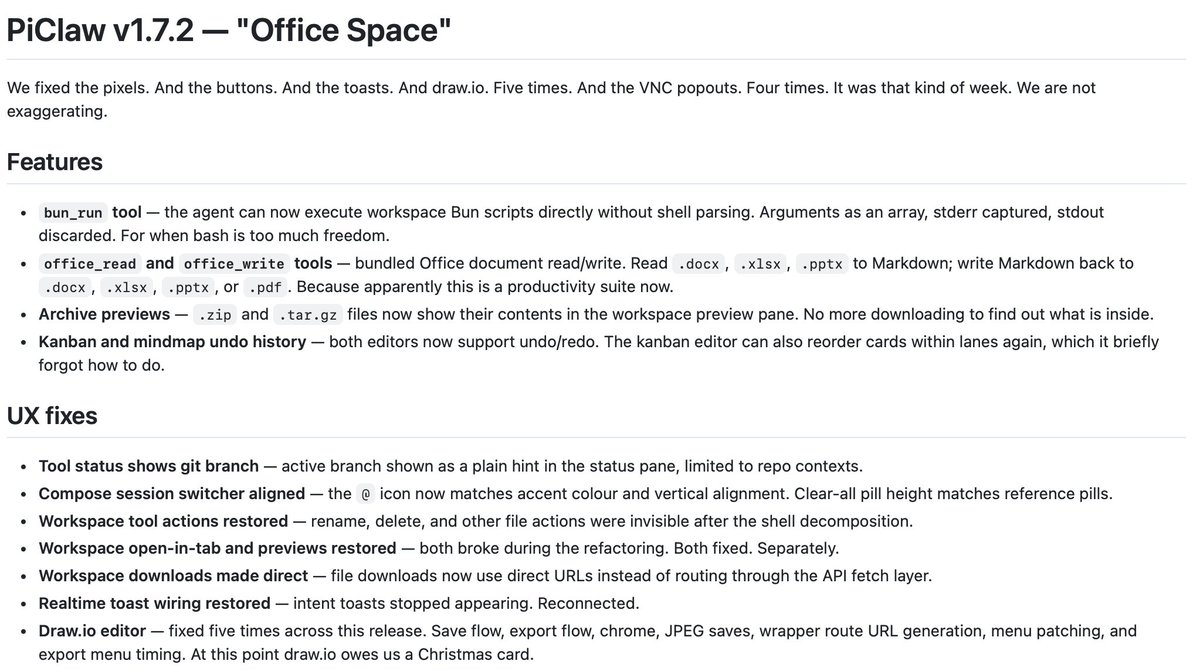
PiClaw v1.7.2 版本发布,正式转型为生产力套件。新版本引入了
bun_run工具,允许代理直接执行 Bun 脚本;同时增加了office_read和office_write工具,支持 .docx、.xlsx、.pptx 与 Markdown 之间的互转。此外,该版本还优化了 Kanban 和思维导图的撤销历史,并支持压缩包预览。PiClaw 的这一更新表明,AI 代理正在从单纯的代码生成器向能够处理复杂办公文档的综合生产力工具演进。
来源:GitHub
13. Mistral 发布 Voxtral TTS,主打多语言与高效推理
Mistral AI 发布了 Voxtral TTS,这是一个 3B 参数的多语言开源语音合成模型。该模型采用自动回归生成语义标记与流匹配(flow-matching)生成声学标记的混合架构,Mistral 称其在效率和质量上均优于传统的扩散模型。Voxtral TTS 支持 9 种语言,并在基准测试中表现出极高的竞争力。Mistral 坚持开源权重哲学,并将其作为“Forge”平台的一部分,旨在为企业提供高效、可定制的语音解决方案,进一步挑战了闭源 TTS 厂商的市场地位。
来源:@latent
14. Augment Code 将举办 Gemini 3.1 Pro 深度解析活动
Augment Code 宣布将于 4 月 3 日举办线上活动,深度解析 Gemini 3.1 Pro 模型。活动将邀请 Google DeepMind 的专家展示该模型在真实工程任务中的表现,并探讨如何将其集成到现有的开发工作流中。随着 Gemini 3.1 Pro 的发布,开发者社区对其在代码生成和代理任务中的潜力充满期待。此次活动将为开发者提供第一手的模型应用经验和最佳实践建议,是了解前沿模型落地能力的窗口。
来源:@augmentcode
15. Warp 代理支持通过 @conversation 引用历史上下文
Warp 终端的 AI 代理功能迎来更新,现在支持通过
@conversation语法引用过去的对话作为上下文。这一功能在对话压缩后或需要重置上下文以开启新任务时尤为有用,能够帮助代理更好地理解长期的开发意图。通过这种方式,开发者可以更灵活地管理 AI 的记忆,避免上下文窗口的浪费。对于依赖 Warp 进行日常开发的用户,这一改进显著提升了 AI 辅助编程的连贯性和准确性。
来源:@warpdotdev
16. GitHub Enterprise 全面支持 Claude Code 等 AI 工具
GitHub 宣布其产品套件全面支持 GitHub Enterprise Server,包括 Claude Code 的 Web 版、iOS、Android 以及代码审查功能。这一更新意味着企业用户现在可以在受控的 GitHub Enterprise 环境中安全地使用 Claude Code 等 AI 辅助工具,无需担心数据泄露或合规问题。对于大型企业而言,这是将 AI 代理引入生产环境的关键一步,有助于在保障安全的前提下提升开发效率。
来源:GitHub
17. TestingCatalog:Claude Code 桌面版新模式预览
TestingCatalog 报道称 Anthropic 正在为 Claude Code 桌面版开发一种新模式,该模式似乎集成了大量快捷键,并具有独特的视觉反馈。这一预览引发了对 Claude Code 未来交互方式的猜测,即是否会向更高效、更符合桌面开发习惯的方向演进。对于 Claude Code 的重度用户,这一更新预示着未来交互体验的提升,值得持续关注。
18. The Rundown AI:AI 代理的即时执行能力
The Rundown AI 展示了一个 AI 代理从接收 90 天路线图到立即执行的案例。这一演示强调了 AI 代理在任务执行上的即时性,即从规划到执行的转化时间被压缩至极短。对于追求极致开发效率的团队,这一能力展示了 AI 代理在缩短开发周期方面的潜力。然而,这也引发了对任务执行质量和安全性的担忧,即在缺乏人类监督的情况下,即时执行是否会导致不可逆的错误。
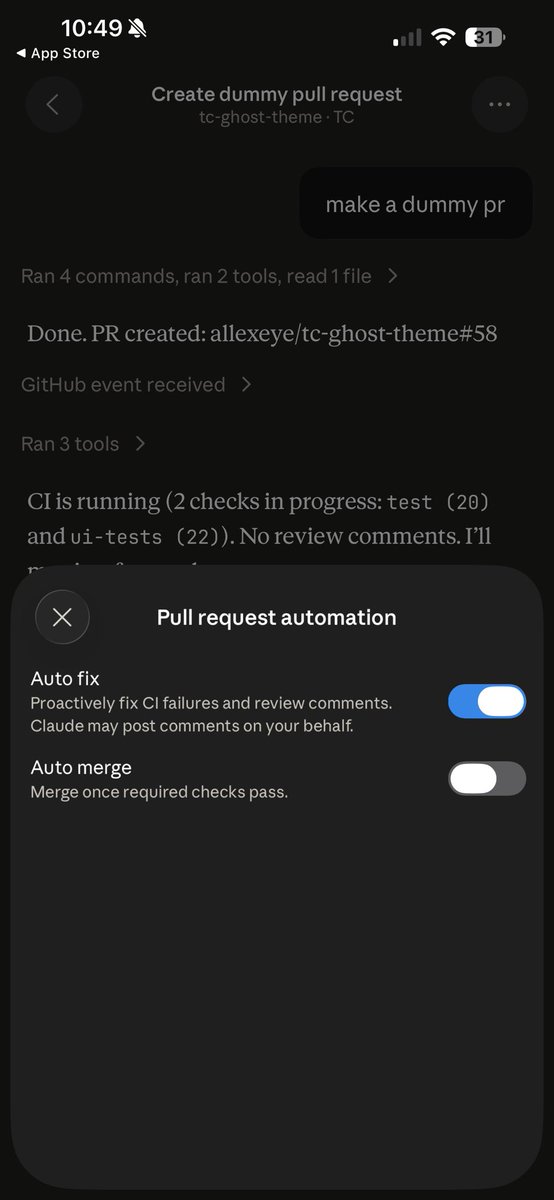
19. Claude Code 移动端 CI 自动修复功能预览
TestingCatalog 报道称 Anthropic 正在为 Claude Code 移动端开发 CI 自动修复切换开关。这一功能旨在帮助开发者在移动端快速修复 CI 失败,进一步提升了移动端开发体验。对于经常需要在移动端处理紧急 Bug 的开发者,这一功能将极大提升响应速度。这一更新表明 Anthropic 正在持续优化 Claude Code 的多平台体验,以满足开发者在不同场景下的需求。

Tutorial
1. Claude Code 实践指南:从基础到多智能体工作流
开发者 luongnv89 发布了一份详尽的 Claude Code 实践指南(claude-howto),旨在帮助开发者从基础概念进阶到构建复杂的多智能体系统。该指南包含大量视觉化教程、Mermaid 图表以及可直接复制的模板,涵盖了 MCP 服务器、钩子(hooks)、技能(skills)及子智能体工作流等高级模式。与官方文档不同,该指南侧重于解决“如何将功能组合成生产力”的问题,是 Claude Code 用户快速提升实战能力的必备资源。
来源:GitHub
2. Prime Intellect 发布 RL 训练指南,零基础构建 AI 代理
Prime Intellect 发布了关于使用 Lab 进行强化学习(RL)训练的指南,旨在帮助开发者从想法到部署构建 AI 代理。该指南无需编程或 RL 经验,通过引导用户设置 Lab 工作空间、创建环境、评估基准性能并启动 RL 训练,实现了端到端的代理开发流程。指南强调利用现有的编码代理(如 Claude Code、Cursor 等)来辅助完成训练任务,降低了 RL 的入门门槛。对于希望探索 AI 代理训练的开发者,这是一个极佳的入门教程。
来源:Your First Model Training - Prime Intellect Docs
3. LLM Council 方法:如何通过多智能体辩论获取可信建议
Hesamation 分享了一种基于 Andrej Karpathy 的“LLM Council”理念构建的 Claude 技能。该方法通过强制 5 个具有不同思维风格(如反向思维者、第一性原理思考者等)的子智能体对同一问题进行辩论、匿名互评,最后由主席智能体进行综合,从而打破 Claude 过于迎合用户的倾向。这种方法特别适用于高风险决策,能够有效揭示盲点。文章提供了详细的设置步骤和技能代码,是提升 AI 决策质量的实用教程。
来源:How to finally trust Claude’s advice (using Karpathy’s LLM Council method)
4. Augment Code:以工作区为核心的代理开发范式
Amelia Wattenberger 在 Augment Code 的深度解析中指出,开发者应将 Intent 工具视为“工作区”而非简单的聊天窗口。真正的开发工作不仅是代码,还包括分支、本地状态、对话、笔记、规格说明及浏览器状态等。Intent 的核心理念是将这些分散的上下文打包进一个隔离的工作区,从而实现更高效的 AI 辅助开发。这一范式转变对于理解现代 AI 编程工具的设计逻辑至关重要,强调了上下文管理在代理开发中的核心地位。
来源:Tips for getting the most out of Intent (from its creator!)
5. Claude Code 2.1.88 系统提示词更新解析
Claude Code 2.1.88 版本更新了系统提示词,重点优化了会话引导和代理行为规范。新版本将工作流规则重组为“会话特定引导”块,明确了何时使用子智能体与 Glob/Grep,以及 slash 命令与 Skill 的映射关系。此外,对代理提示词提出了更严格的要求,强调“永不委派理解”,要求 Claude 必须进行合成并提供具体目标。这些更新旨在减少误委派,提高多 schema 工作流的可靠性,是开发者深入理解 Claude Code 内部逻辑的重要参考。


6. Raven AI:利用 AI 构建市场调查系统的实战经验
Raven AI 分享了利用 Claude Code 构建市场调查系统的实战经验。作者通过串接 Google Trends 和 YouTube 数据,建立了一套自动分析话题趋势的系统,从而从直觉驱动转向数据驱动的创业决策。该系统采用“双层雷达”方法,通过长尾关键词分析发现被忽视的市场机会。文章详细介绍了从 README.md 编写到 Git 版本控制的开发流程,展示了非技术人员如何利用 AI 代理构建功能性软件,是 AI 辅助创业的典型案例。
来源:@robj3d3
Opinions/Thoughts
1. Cursor 研究:通过实时强化学习优化 Composer
Cursor 团队分享了其在 Composer 中应用实时强化学习(Real-time RL)的研究成果。通过将模型检查点部署到生产环境,收集用户交互作为奖励信号,Cursor 能够每五小时发布一个改进版本。研究指出,代码领域相比机器人领域更容易创建高保真的模拟环境,这使得 RL 在代码生成任务中表现优异。该方法有效解决了训练与测试环境不匹配的问题,为构建持续进化的 AI 编程工具提供了重要思路。

来源:Cursor
2. Google DeepMind:代理技能如何弥合模型知识鸿沟
Google DeepMind 的研究人员探讨了“代理技能”在弥合静态 LLM 与快速演进的 SDK 之间知识鸿沟的作用。由于 LLM 的训练数据存在时间截断,无法感知最新的库更新和最佳实践,代理技能通过提供实时文档和编码原语,显著提升了模型在代理、聊天和 SDK 使用场景下的表现。文章强调,技能是为代理添加相关上下文的轻量级技术,对于构建能够处理复杂、动态工程任务的 AI 系统至关重要。

来源:Closing the knowledge gap with agent skills- Google Developers Blog
3. Agentic Drift:AI 编程代理如何导致代码库架构退化
AstroMVP 的 Alireza Bashiri 探讨了“代理漂移”(Agentic Drift)现象,即 AI 编程代理在修复 Bug 时,通过添加兼容性垫片(shim)而非重构代码,导致代码库架构逐渐退化。这种现象并非因为代理能力不足,而是因为代理过于倾向于保留现有结构。随着时间推移,代码库中充斥着空存根、重复的所有权路径和复杂的归一化层,最终导致架构溶解。文章呼吁开发者警惕这种“小修复带来的大架构破坏”,并提出了相应的管理建议。
来源:Agentic Drift Is Killing Your Codebase. Here’s How to Stop It. | AstroMVP
4. Tau-Knowledge:评估代理在非结构化知识环境下的表现
研究人员介绍了 Tau-Knowledge,这是 Tau-Bench 的扩展,旨在评估代理在需要协调外部自然语言知识与工具输出以实现策略合规状态变更的环境中的表现。通过引入 $\tau$-Banking 领域,模型需要导航约 700 个互联的知识文档并执行工具介导的账户更新。研究发现,即使是具备高推理预算的前沿模型,在检索和搜索任务上的通过率也仅为 25.5% 左右。这一基准测试揭示了当前代理在处理长程、知识密集型任务时的局限性。
来源:Pokee
5. Agentic 层带来的新风险:自主性与边界的冲突
Wey Gu 分析了自主代理(如 OpenClaw)在严肃、大规模组织中运行的风险。研究发现,当前代理处于 L2 自主水平,能够执行子任务,但缺乏识别自身能力边界并交还人类控制的能力。核心风险包括持久内存导致的错误记忆长期存在、工具访问将小误差放大为系统级故障、多方通信鉴权失效以及 Agent 间交互导致的跨 Agent 污染。文章强调,在缺乏自我监控和主动移交机制的情况下,盲目追求代理自主性是危险的。


来源:@wey_gu
6. Guillermo Rauch:负责任地使用 AI 代理的内部指南
Vercel CEO Guillermo Rauch 分享了公司内部关于“负责任地使用 AI 代理”的指南。他强调,虽然 Opus 4.5 等模型改变了工程方式,但“Vibing”(随性)与“关键基础设施”是不兼容的。公司要求团队在代理使用中优先考虑安全性、持久性和可用性。这一指南反映了领先技术公司在拥抱 AI 代理的同时,对生产环境稳定性的审慎态度,为其他企业如何平衡 AI 效率与系统安全提供了参考。
来源:@rauchg
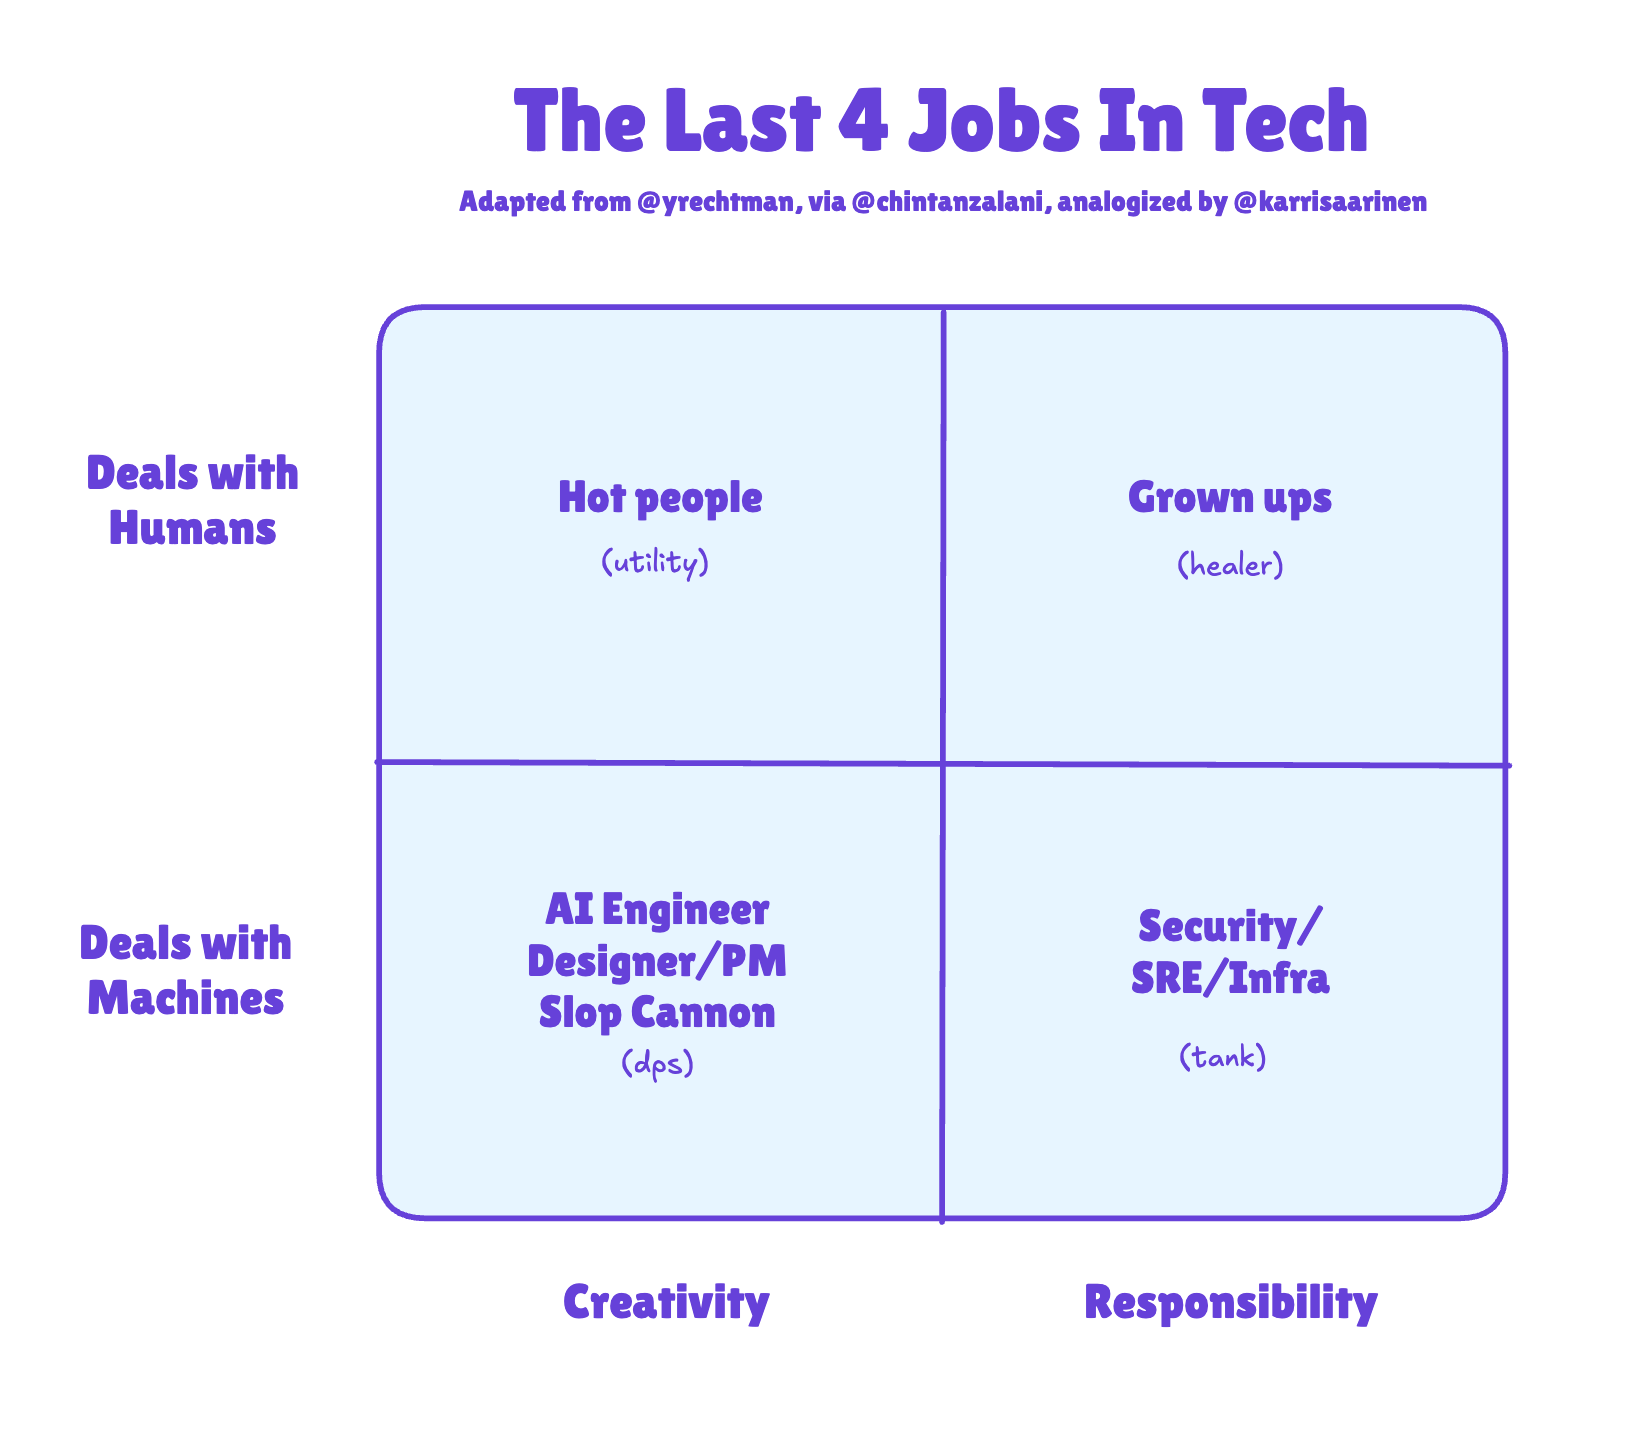
7. Latent Space:AI 时代技术领域的最后四个岗位
Latent Space 探讨了 AI 代理对技术岗位的影响,指出行业正从单体产品转向可组合的代理 harness。文章认为,闭环验证(代码、运行、检查、修复)是实现可靠应用迭代的关键。随着 AI 代理能力的提升,工程瓶颈已从代码生成转向代码审查和代理工作流管理。此外,企业正倾向于在专有数据上微调开源模型,而非长期依赖通用 API。这一趋势预示着技术岗位将向更具工程化、更关注系统可靠性和隐私的方向演进。
来源:Latent.Space
8. Nicholas Carlini:当 AI 擅长找漏洞,安全行业将如何演变?
Nicholas Carlini 探讨了 AI 在漏洞挖掘领域的潜力。随着 AI 在代码分析和漏洞发现方面表现出超越人类的能力,安全行业正面临前所未有的挑战。文章分析了 AI 驱动的自动化安全测试对传统安全审计模式的冲击,并提出了关于未来安全行业生存空间的思考。这一观点引发了对 AI 时代安全防御策略的深层讨论,即在 AI 能够自动发现并利用漏洞的背景下,人类安全专家的角色将如何重塑。
来源:Nicholas Carlini:当 AI 比所有人都更擅长找漏洞,安全行业还剩几个月?
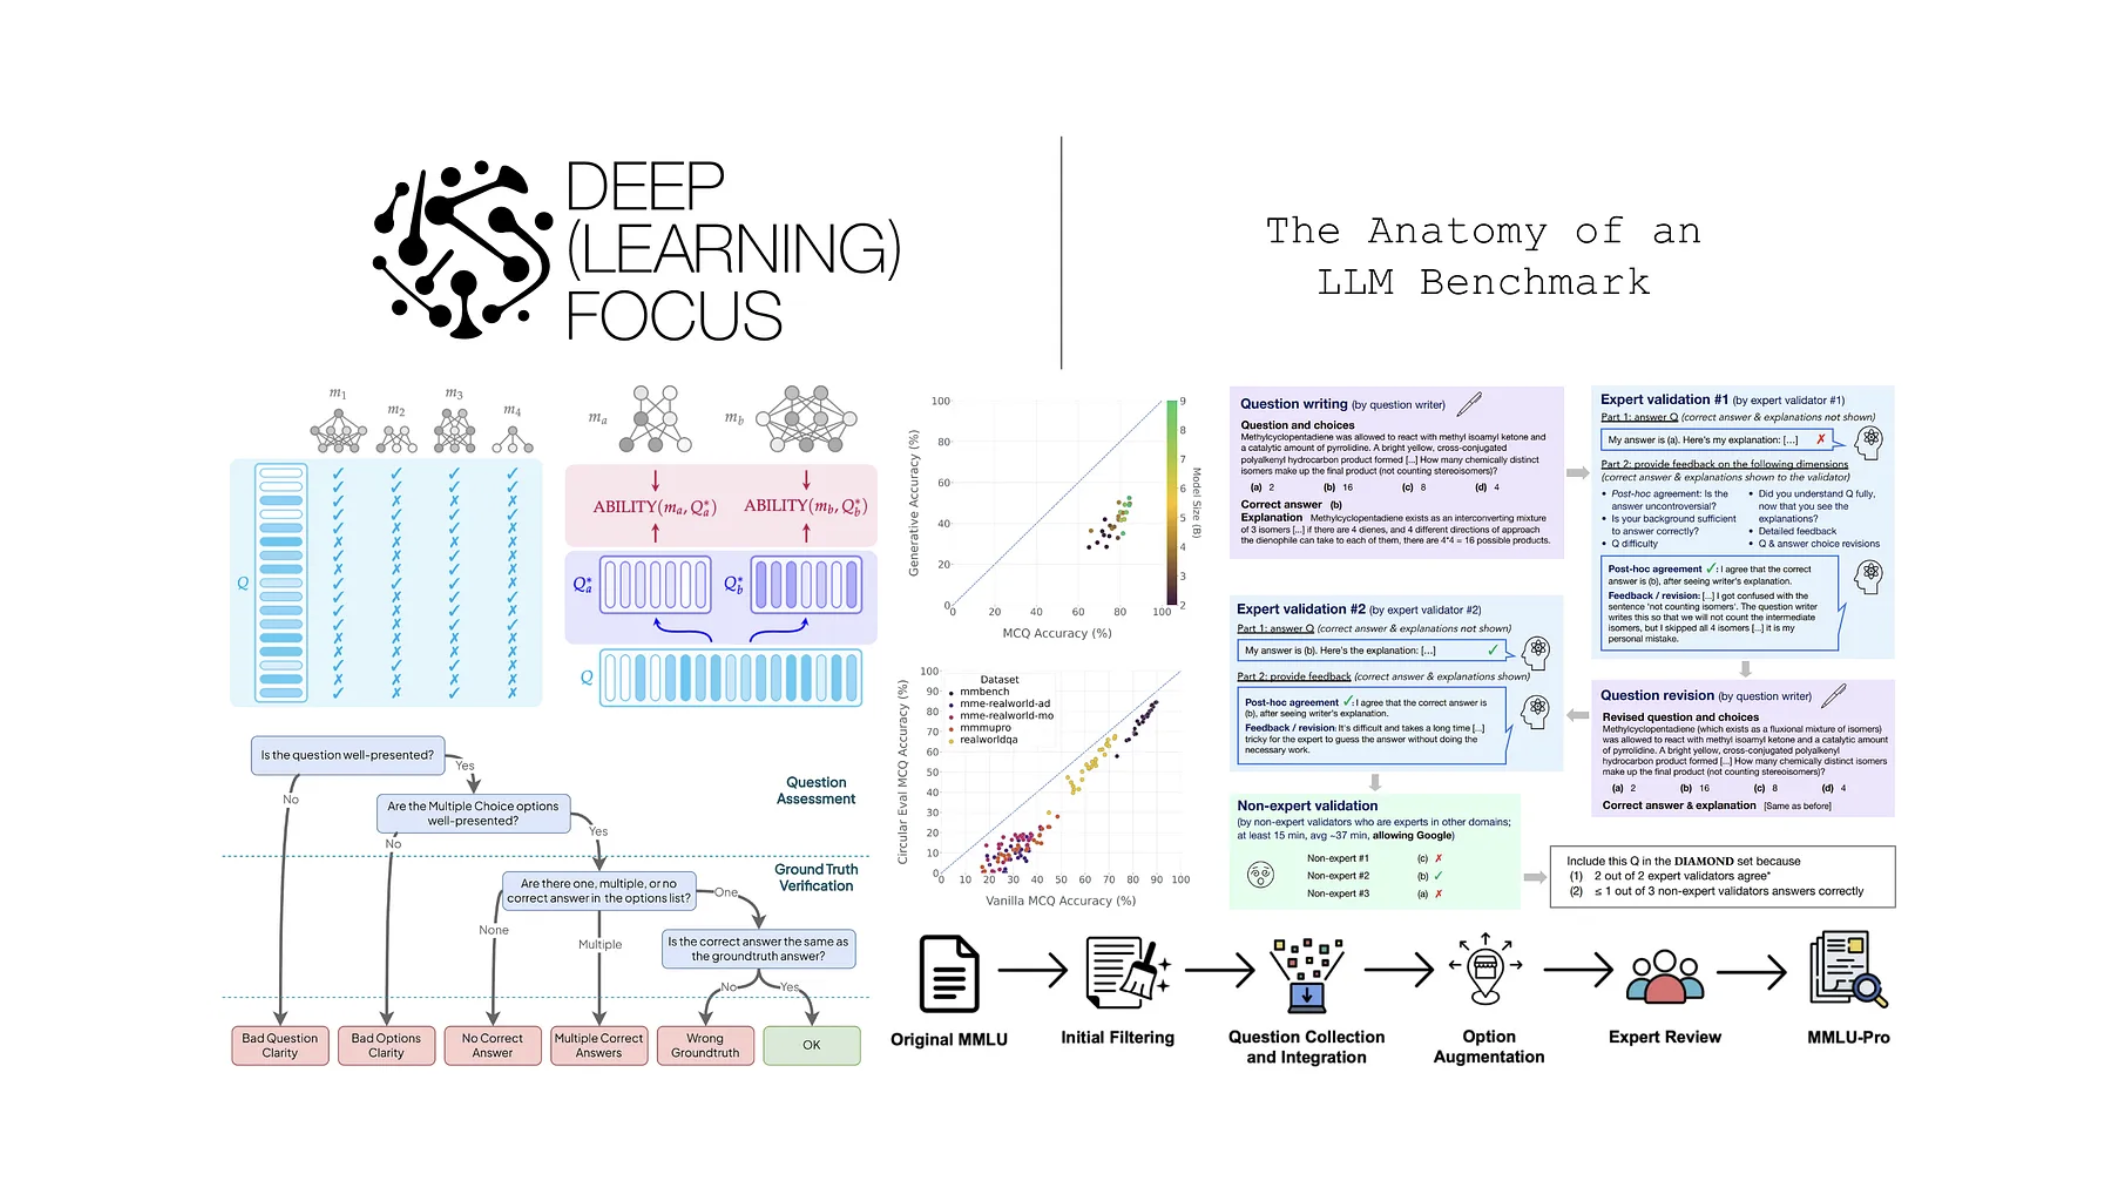
9. LLM 基准测试的解剖:如何构建有效的评估数据集
文章深入剖析了 LLM 基准测试的构建逻辑,探讨了为何现有基准(如 MMLU、BIG-Bench)容易饱和,以及如何通过先进技术(如项目反应理论 IRT)提升评估效率。作者指出,数据质量是基准测试的核心,许多基准存在“盲解”问题,即模型无需推理即可通过。文章提倡采用生成式评估而非多项选择,并强调了“模型在环”评估的重要性。对于致力于 AI 研究的开发者,理解如何构建稳健、具有区分度的基准测试是衡量模型真实能力的必要前提。
10. Claude Code Token 消耗异常调查
近期大量用户反馈 Claude Code 的 Token 消耗量异常,较预期高出 5 到 20 倍。Reddit 用户逆向分析发现,这可能与二进制字符串替换导致的缓存失效以及
--resume恢复会话命令的 Bug 有关。由于缓存 Token 与非缓存 Token 的成本差异巨大,这些 Bug 导致了额度爆炸。官方表示正在调查,但尚未给出修复时间表。目前建议用户尽量避免使用二进制版,直接通过 npx 安装,并暂时避免使用--resume命令。


来源:@op7418
11. Apple Intelligence 国行推送误操作事件
Apple Intelligence 短暂向国行设备推送,随后被撤回。据报道,这属于误操作,且该功能尚未获得监管批准。目前尚不确定已下载该功能的国行用户是否会被云控强制关闭。这一事件引发了关于苹果 AI 在中国市场合规性及部署策略的讨论。对于关注 Apple Intelligence 的用户,这一事件揭示了其在特定市场落地时面临的监管复杂性,以及苹果在功能推送上的谨慎态度。
来源:@yeahwu404