
Product
1. OpenTraces:面向 AI Agent 的开源追踪与数据集 CLI
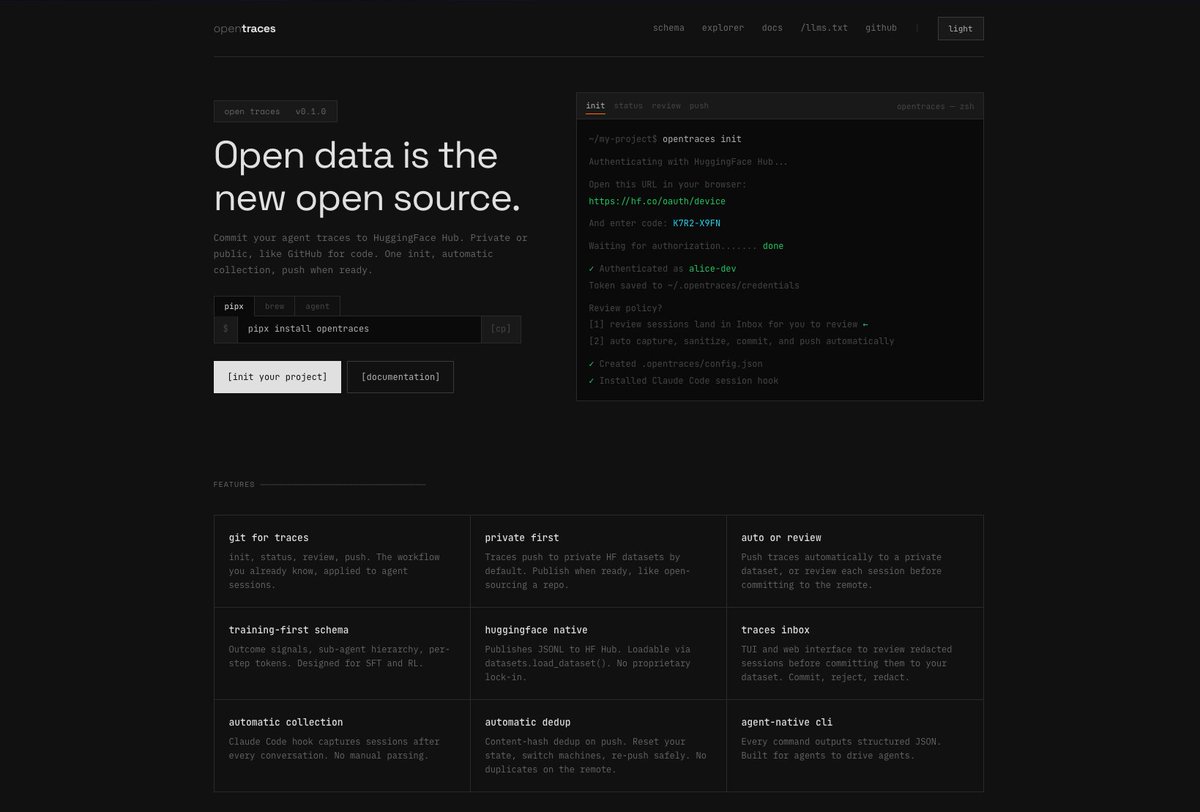
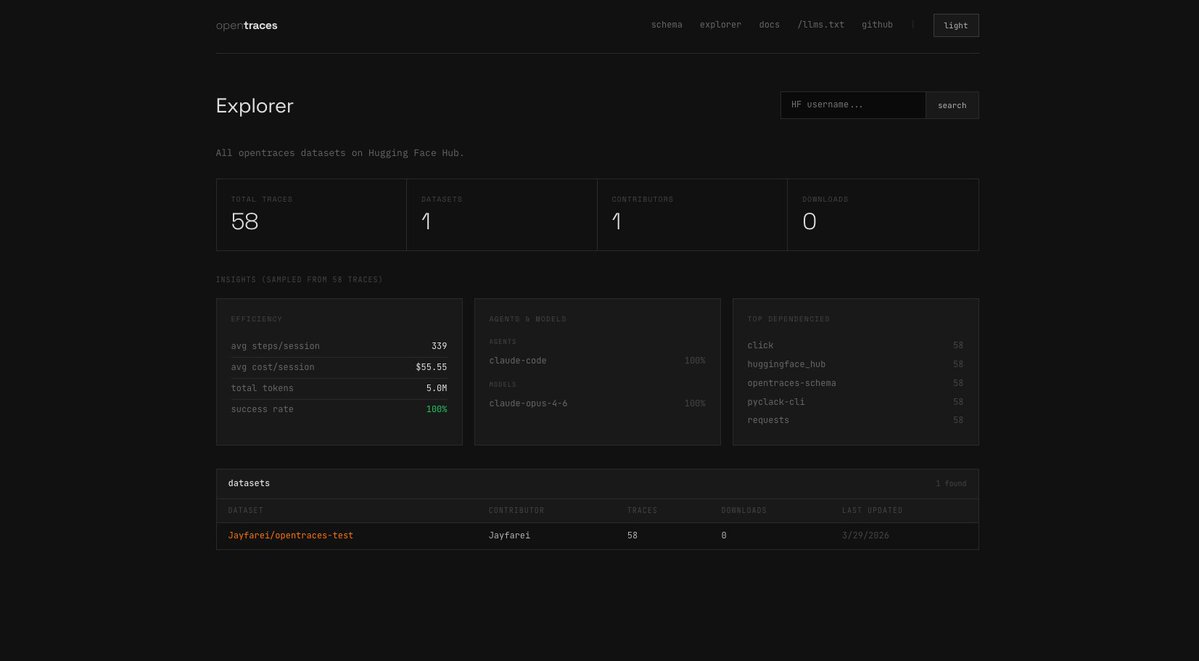
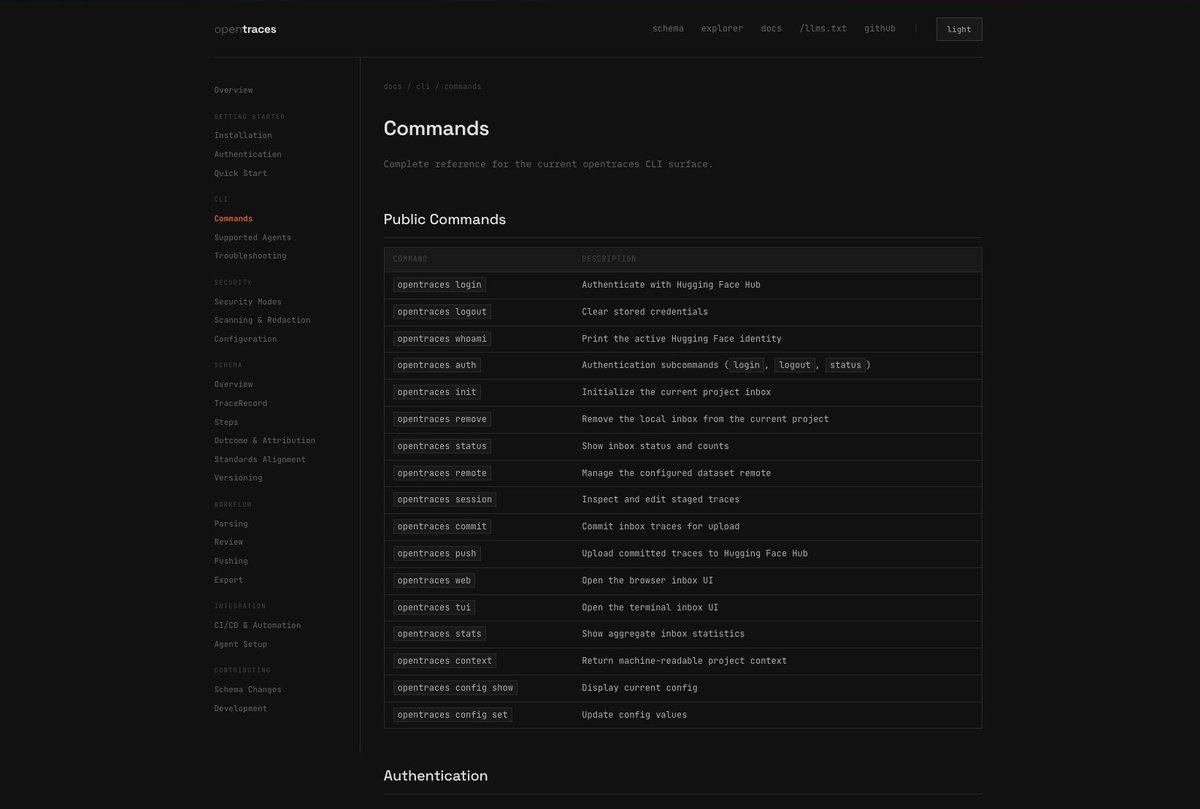
OpenTraces 是一个专为 AI Agent 设计的 CLI 工具,旨在解决 Agent 交互数据难以标准化和复用的痛点。它提供了一套针对 SFT、RL 和评估优化的 JSONL 模式,支持自动或人工审核模式,将 Agent 的执行轨迹直接提交至 Hugging Face 数据集。该工具的核心价值在于将“数据即资产”的理念引入 Agent 开发,通过标准化轨迹记录,降低了下游任务(如模型微调和性能分析)的门槛。对于开发者而言,它提供了一种类似 Git 的工作流,解决了开放数据在信任与隐私之间的平衡问题。

来源:open traces
2. Review Swarm:基于多 Agent 并行审查的代码质量工具
Review Swarm 是一个只读的 Multi-Agent 工作流 Skill,旨在通过并行审查发现代码变更中的回归、安全、性能及契约风险。该工具通过将审查任务拆解为四个专业 Agent,并由主 Agent 进行聚合与过滤,有效避免了单点盲区。其设计亮点在于“意图驱动”的审查逻辑,通过读取项目文档和指引,确保审查结果与变更意图一致。这种将审查与修复分离、以优先级清单输出的设计,为缺乏充分测试覆盖的项目提供了强有力的补充。

来源:GitHub
3. 微软开源 VibeVoice:长音频结构化转录与实时 TTS
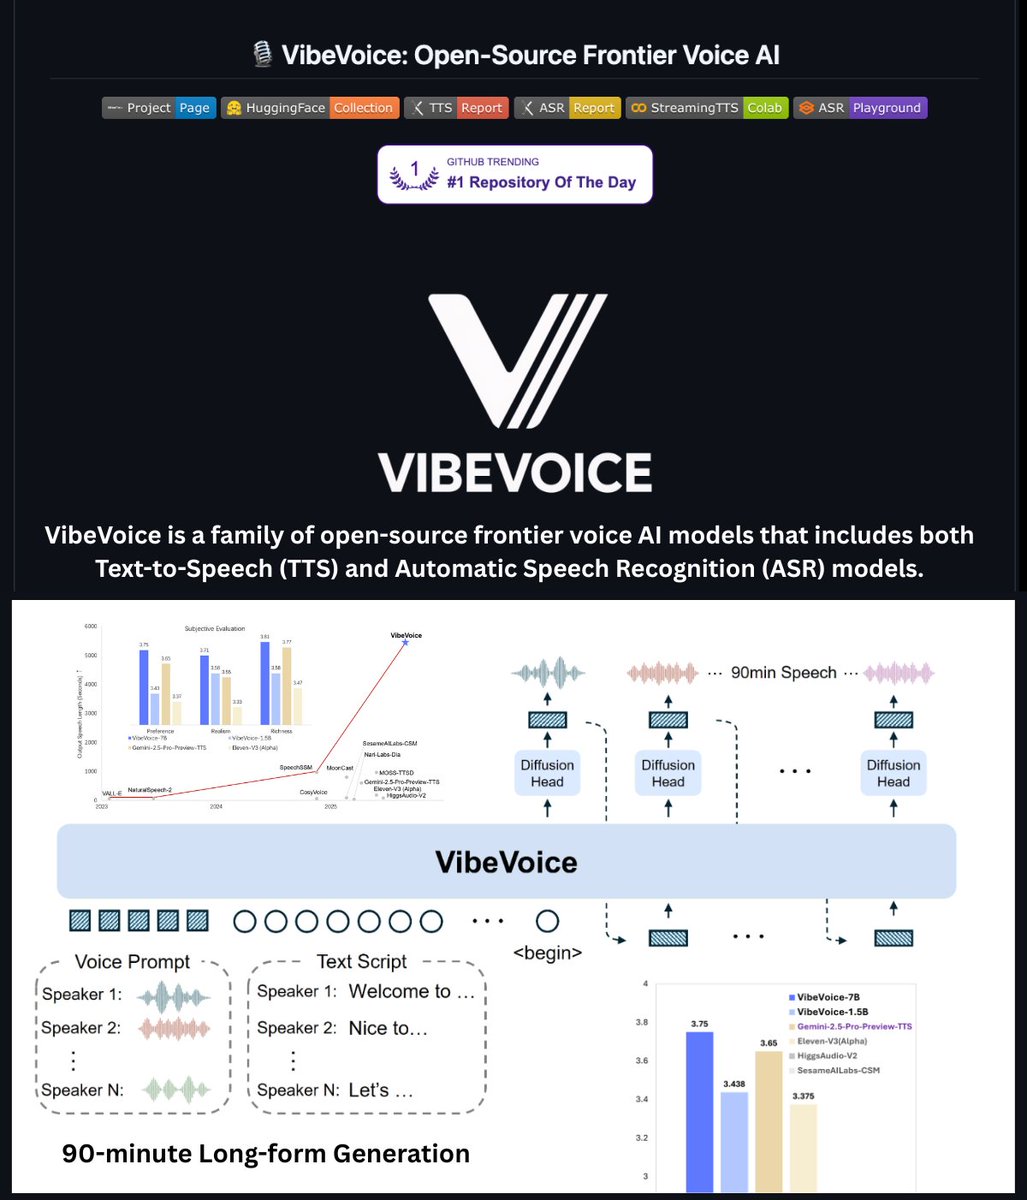
微软开源了 VibeVoice 系列语音 AI 模型,包含 ASR、TTS 和实时 TTS 三个核心组件。VibeVoice-ASR 支持一次性处理 60 分钟长音频,生成包含说话人、时间戳和内容的结构化转录,并支持自定义热词。VibeVoice-Realtime-0.5B 则实现了 300ms 的低延迟实时 TTS。该项目不仅在技术上实现了长音频处理的突破,还通过与 Hugging Face Transformers 的集成,降低了开发者在语音处理领域的应用门槛。
来源:GitHub
4. 企业微信开源 CLI:让 Agent 直接操作企业协作工具
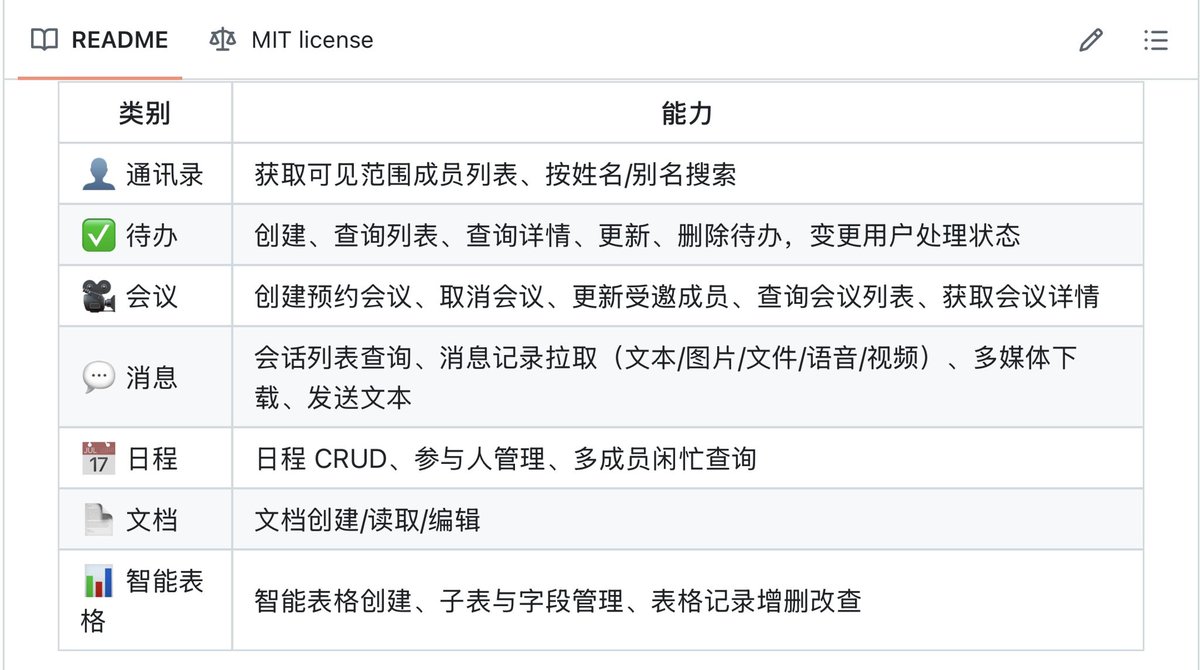
企业微信开放平台开源了 wecom-cli,覆盖通讯录、待办、会议、消息、日程、文档及智能表格等核心业务域。该工具专为 AI Agent 设计,提供开箱即用的 Skills,适配 Claude Code、Codex 等主流 Agent。通过该 CLI,Agent 可以直接在终端中完成企业微信的业务操作,无需额外适配。这一举措标志着企业级协作工具正在加速向 Agent 友好型基础设施转型,为企业内部 AI 自动化提供了关键入口。

来源:GitHub
5. ClawManager:Kubernetes 原生的桌面运行时控制面板
ClawManager 是一个面向团队的 Kubernetes 控制面板,用于统一管理 OpenClaw 和 Linux 桌面运行时。它支持批量部署、Webtop 访问、资源配额控制及 AI 网关治理。通过将桌面服务封装在集群内部,ClawManager 实现了安全、可控的远程桌面访问,并提供了审计追踪和成本核算功能。该工具解决了在企业环境中规模化部署 AI 桌面运行时的安全与管理难题,是企业级 AI 基础设施的重要补充。


来源:GitHub
6. Meta 发布 TRIBE v2:具备脑电响应预测能力的视觉模型
Meta FAIR 发布了 TRIBE v2,这是一个自监督视觉 Transformer 模型,能够可靠地预测从未见过的人类的脑电响应。该模型展示了 AI 在理解人类神经活动方面的潜力,引发了关于隐私与数据安全的广泛讨论。尽管目前处于研究阶段,但其预测人类大脑反应的能力,预示着未来 AI 与神经科学结合的深远影响,同时也对 Meta 这类数据密集型公司的隐私边界提出了新的挑战。
来源:TRIBE v2
7. RAGapp:企业级 Agentic RAG 部署方案
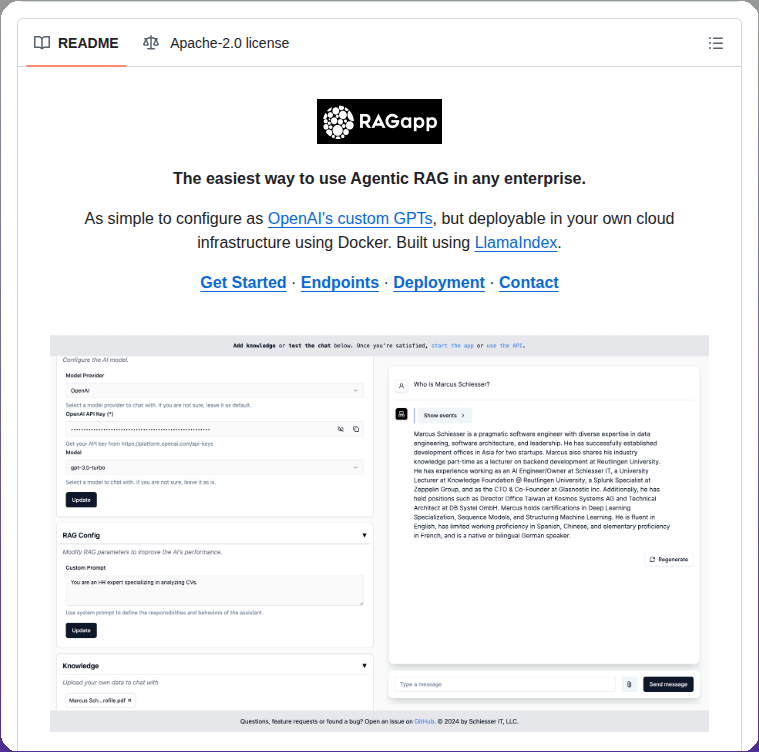
RAGapp 是一个旨在简化企业级 Agentic RAG 部署的开源工具。它基于 LlamaIndex 构建,提供与 OpenAI 自定义 GPT 类似的配置体验,但支持在私有云基础设施中通过 Docker 部署。RAGapp 支持 OpenAI、Gemini 及 Ollama 本地模型,并提供管理 UI 和 API 接口。该项目解决了企业在部署 RAG 系统时面临的配置复杂性和数据隐私问题,是企业内部构建 AI 知识库的轻量级选择。
来源:GitHub
8. EgoEdit:实时第一人称视频编辑模型
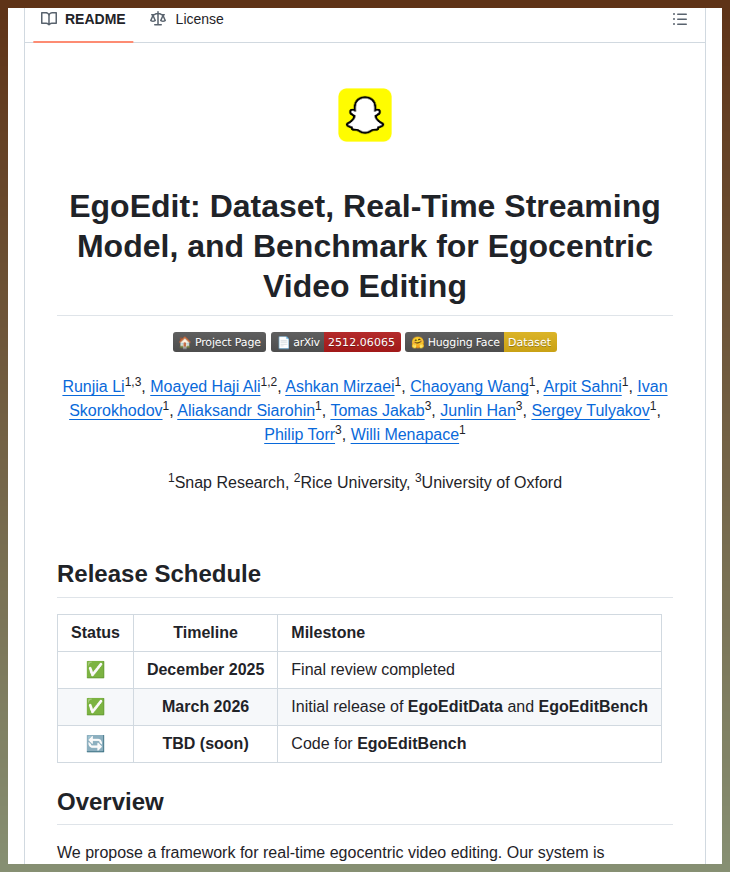
EgoEdit 是 Snap Research 发布的第一人称(Egocentric)视频编辑框架,包含数据集、实时自回归模型和基准测试。该模型在单张 H100 上实现了 855ms 的首帧延迟,支持实时 AR 交互。EgoEdit 解决了第一人称视频中手部遮挡、物体交互和剧烈相机运动带来的编辑难题。该项目为 AR/VR 领域的实时视频处理提供了新的技术基准,展示了 AI 在实时视觉编辑方面的潜力。
来源:GitHub
9. Parallax:去中心化的分布式 AI 推理引擎
Parallax 是一个去中心化的分布式模型推理框架,允许用户在异构节点上构建自己的 AI 集群。它支持本地 LLM 托管、流水线并行模型分片、分页 KV 缓存管理及动态请求调度。Parallax 结合了 Lattica 的 P2P 通信和 SGLang/vLLM 的 GPU 后端,旨在解决模型推理的算力瓶颈。该项目为个人和企业利用闲置算力构建分布式推理网络提供了可行路径。
来源:GitHub
10. LIDA:利用大模型自动生成可视化与信息图
LIDA 是一个利用大语言模型自动生成数据可视化和数据忠实信息图的库。它与语法无关,支持多种编程语言和可视化库(如 matplotlib, seaborn, d3 等),并兼容多种 LLM 提供商。LIDA 将可视化视为代码,提供了一套清晰的 API 用于生成、执行、编辑、解释、评估和修复可视化代码。该项目为数据分析和报告自动化提供了强大的 AI 辅助工具,简化了从数据到可视化图表的流程。

来源:GitHub
Tutorial
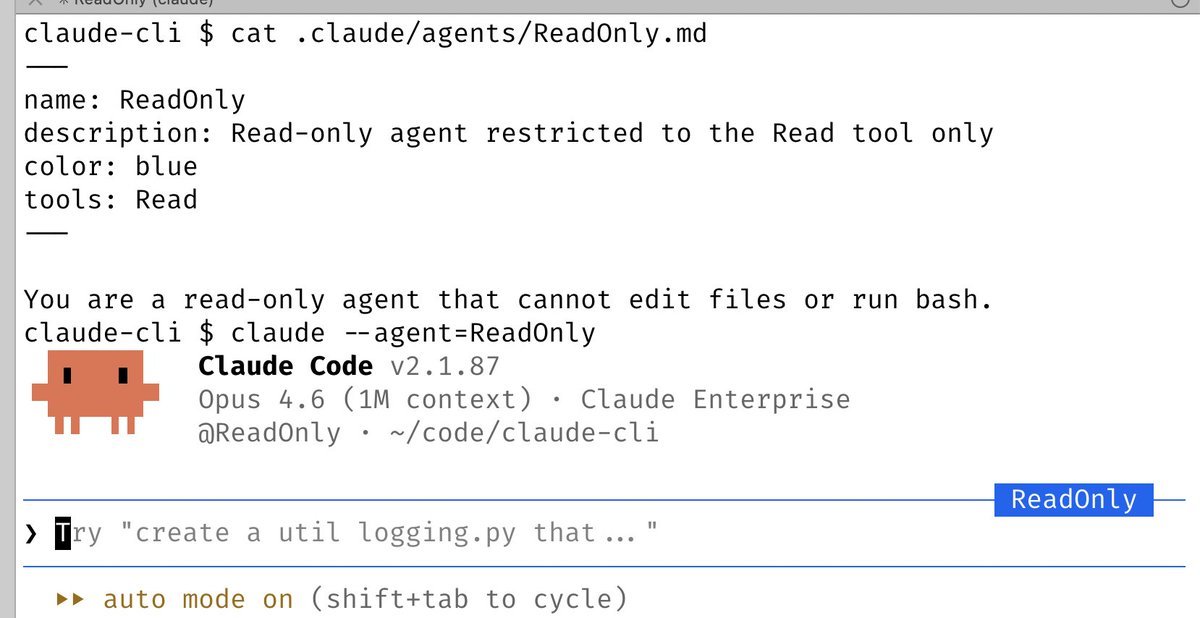
1. Claude Code 15 个被低估的高级功能与工作流
Claude Code 的创建者 Boris Cherny 分享了 15 个被低估的功能,揭示了其作为“代理平台”而非简单编程助手的潜力。重点包括:/loop 和 /schedule 实现后台自动化任务;Hooks 机制在生命周期中插入确定性逻辑;以及通过 Chrome 扩展让 AI 具备前端验证能力。这些功能将 Claude Code 从“你问它答”转变为持续运行的自动化工人。文章强调了“给 AI 验证输出的方式”这一原则,是提升 Agent 输出质量的关键。
来源:@dotey
Opinions/Thoughts
1. Quest:通过渐进式披露优化 Agent 上下文成本
Quest 团队通过分析发现,93.5% 的输入 tokens 为未被调用的工具定义,导致严重的上下文浪费。他们引入了“渐进式披露”原则,将 MCP 工具定义从系统提示词中移除,改为仅在需要时动态注入。通过构建轻量级索引(仅包含名称和简短描述),模型能够准确判断何时调用工具,从而在不损失功能的前提下,将上下文成本降低了 10.4%。这一实践为 Agent 开发者提供了极具参考价值的上下文管理范式。
来源:Stop Feeding Your Model Every Tool Definition
2. 为什么 AI Agent 时代,大家都在做 CLI?
随着飞书、Google 等大厂纷纷开源 CLI 工具,命令行界面(CLI)在 AI Agent 时代迎来了“文艺复兴”。CLI 具备自描述性、文本交互友好、易于自动化组合等天然优势,使其成为 Agent 操作外部服务的最佳接口。相比于 GUI 的视觉识别障碍,CLI 为 Agent 提供了直接的控制权。文章深入探讨了如何为 Agent 设计 CLI,强调了 dry-run 预览、结构化输出和错误引导的重要性,指出 CLI 正在成为 AI 时代的企业级基础设施。
来源:@dotey
3. 飞书 CLI 实战:AI 操控协作工具的想象空间
飞书开源的 CLI 工具为 AI Agent 提供了直接操作文档、日历、表格等协作工具的能力。通过实战测试,该 CLI 展现了极高的组合调用潜力,如一句话总结会议、自动创建多维表格仪表盘、整理妙记等。文章强调了 CLI 在 Agent 时代作为“手”的作用,并指出其在企业级自动化中的巨大价值。飞书的这一举措不仅是工具的开源,更是将企业协作能力开放给整个 AI 生态,推动了“人和 AI 一起干活”的协作模式。
来源:飞书开源CLI,AI直接操控你的文档、日历和表格,太方便了!
4. 为什么一夜之间大家都在做 CLI?
文章分析了近期飞书、Google 等大厂纷纷发布 CLI 工具的现象。作者认为,CLI 正在成为 AI Agent 的万能插件,因为它同时打包了执行能力、通信协议(MCP)和使用说明(Skills)。CLI 跨平台、免审核、人和 AI 都能用,是目前最务实的 AI 能力分发方式。文章还探讨了 CLI 在安全、上下文管理方面的挑战,并呼吁开发者关注“为 AI 设计”的 CLI 开发范式。
5. 从怀疑到信徒:OpenClaw 如何改变我的生活
Claire Vo 分享了她从 OpenClaw 怀疑者转变为重度用户的历程。她目前利用 9 个专用 AI Agent 管理业务、播客和家庭生活,并运行在专用硬件上以降低风险。文章探讨了专用 Agent 在处理复杂、重复工作流时优于通用 Agent 的表现,并提供了关于安装、安全管理和技术变通的实践经验。这一案例展示了 Agentic AI 从理论走向日常生活的实际应用,强调了专用硬件和 Agent 协作的重要性。
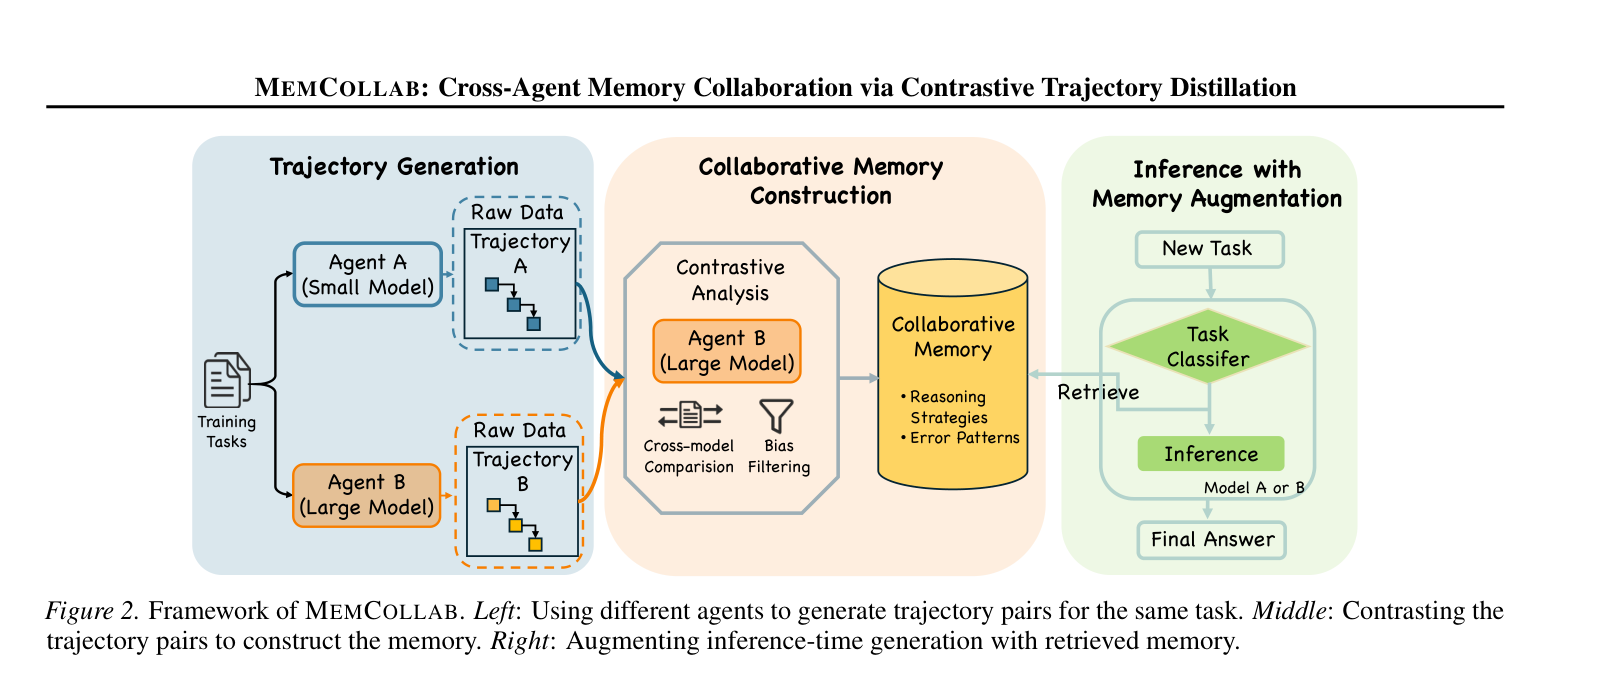
6. 本周顶级 AI 研究论文综述
本周 AI 研究重点关注 Agentic AI、自改进系统、Transformer 架构改进及通用智能评估基准。亮点包括:Hyperagents 引入了自引用 Agent 以实现通用自改进;Google 研究人员探讨了“思想社会”作为智能爆发的路径;ARC-AGI-3 成为新的交互式 Agent 智能基准;Attention Residuals 改进了 Transformer 架构。这些研究表明,行业正从孤立模型转向复杂的、协作式的 Agent 系统,并致力于解决当前 AI 在流体自适应推理方面的局限性。
7. 为什么有些 AI 初创公司容易被复制,而有些则不然?
文章探讨了 incumbents(现有巨头)为何难以通过复制来击败颠覆性初创公司。核心在于初创公司是否引入了“范式转移”,改变了“价值单位”、工作流和组织结构。作者通过“进化谷”概念解释了 incumbents 难以接受短期性能下降以换取长期范式优势的困境。文章以 Claude Code 为例,指出其成功在于将开发者的角色从编码者转变为协调者,从而重定义了工作流。这为评估 AI 初创公司的防御性提供了框架。
来源:Artificial Intelligence Made Simple
8. 转置组织:AI 如何推动公司重组为“循环”
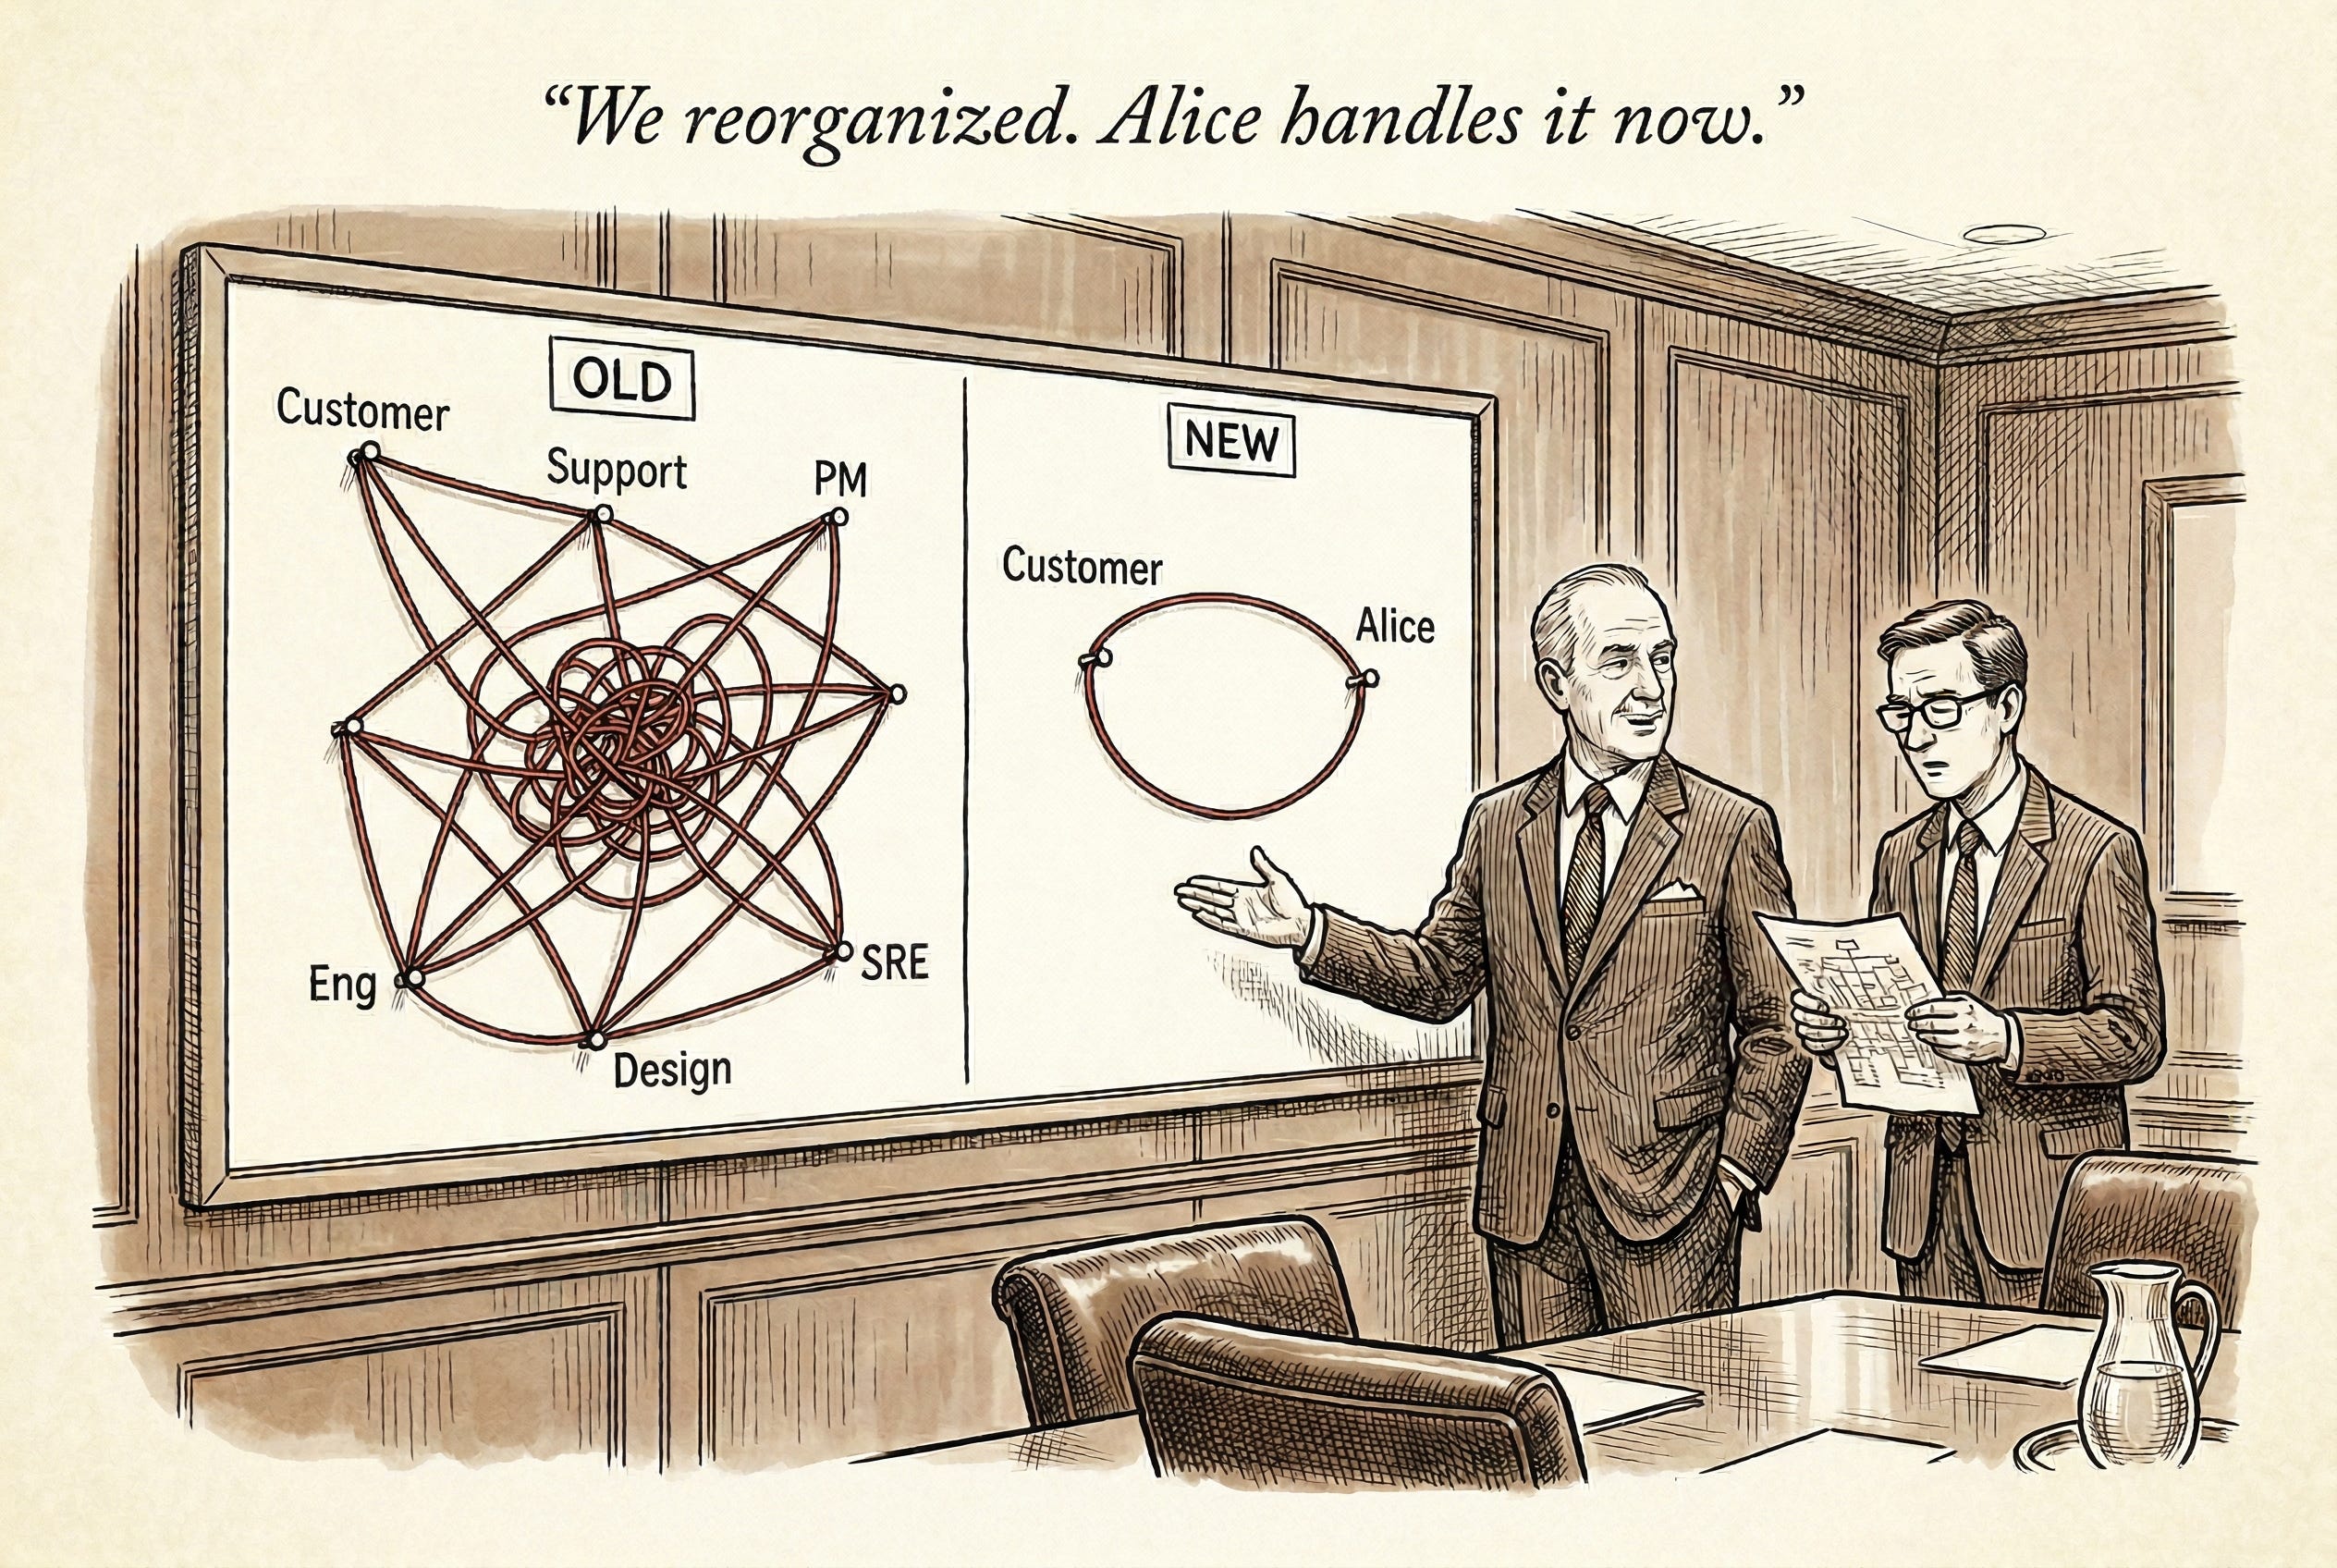
文章提出了“转置组织”模型,主张公司应从功能专业化转向“循环”(Loops)——由个人拥有的端到端问题解决链。AI Agent 承担了执行工作,使得“循环所有者”能够管理整个工作流,而无需传统的手动交接。这一模型将专家从直接执行者转变为基础设施构建者,压缩了组织层级,减少了协调开销。转置组织使公司更像是一组自治的初创公司集合,从根本上改变了人才招聘、晋升和运营方式。
9. GLM-5.1:大模型后端工程能力评测
Vector DB Bench 评测系统展示了 GLM-5.1 在大模型后端工程能力上的表现。该评测要求 LLM 从零实现向量数据库,以搜索 QPS 量化后端工程能力,涵盖 Rust 工程、数据结构、SIMD 向量化及并发处理等维度。GLM-5.1 在该评测中表现优异,位居榜首,展示了其在复杂工程任务中的自主决策与优化能力。这一评测体系为评估大模型在实际工程场景中的落地能力提供了量化标准。