
AI 日刊 · 2026-10-26
Product
1. Muse 逐步上线语音通话,可与代理实时语音对话
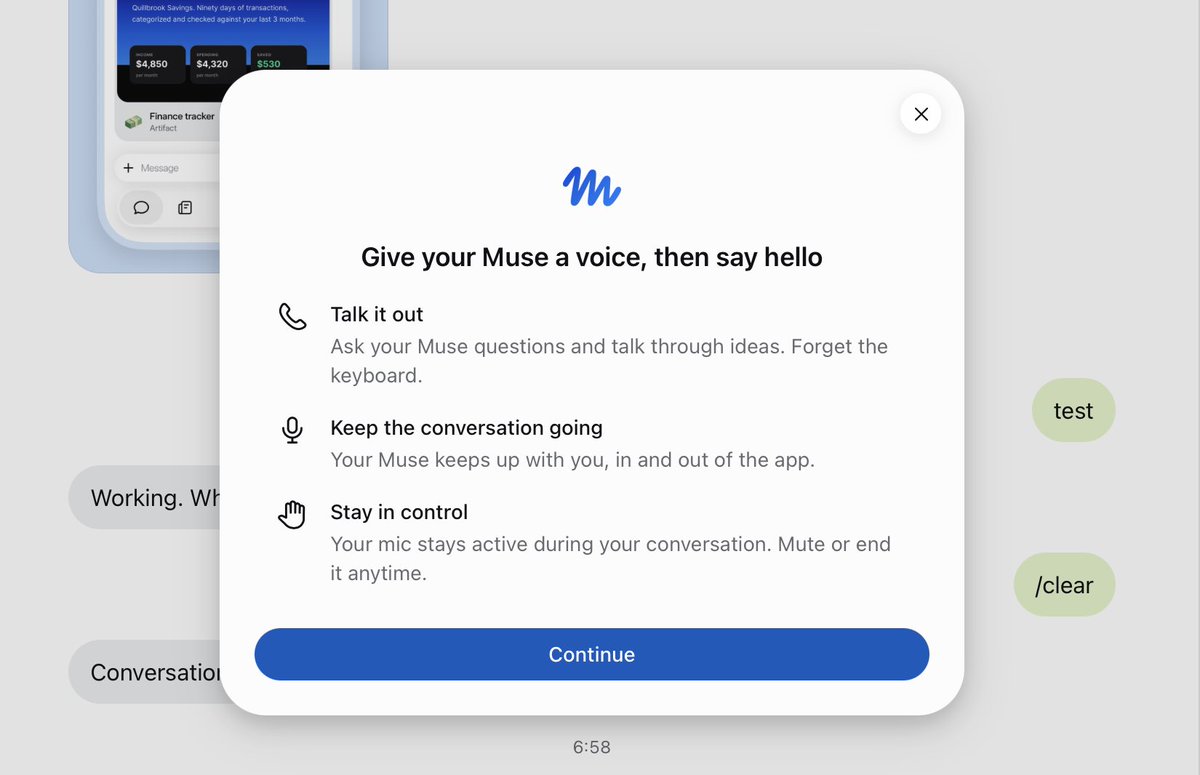
Meta 的 Muse 助手自昨日起逐步上线语音通话功能,用户可以与 Muse 代理进行实时语音对话。尝鲜用户反馈:功能入口引导简单,会先问是否更换声音,并可按你的描述给出候选音色;语音交互的自然度评价颇高。这把 Muse 从文字与头像代理推向全双工语音入口,与市面上语音优先的代理产品正面竞争。该功能仍在分批放量,尚未全量开放。
2. opencode 引入实验性后台上下文压缩,长会话不再卡顿
开源编码代理 opencode 合入了 background compaction,目前作为实验性设置开放,团队请大家试用并反馈。上下文压缩挪到后台进行,长会话不必停下来等整理,缓解长任务里的上下文爆仓问题。这相当于给 Claude Code 等闭源工具里的同类能力补课,方向是让代理连续跑更久的活。实验特性默认关闭,需要手动开启。
来源:@Neriousy
Tutorial
1. 逆向新三星电视拿到 root:常开热麦克风与 400 家数据伙伴
安全研究员 log4j 因为新买的 2025 款三星电视广告诡异精准,决定逆向固件;固件 AES 加密且无密钥,他直接打零日拿到了新三星电视的 root shell。发现包括:常开热麦克风、自动内容识别(ACR)、地理定位、网络映射、定向广告服务、四套独立 DRM、用户画像构建,遥测共享给三星及其「400 家伙伴」——原话是「就你、上帝、一台 3000 美元的电视,和三星加 400 个伙伴」。社区确认该路径未受 Knox 与 hypervisor 阻拦,作者预告将写完整 write-up。这条推 340 万浏览,是本周最大的消费设备隐私事件。

来源:log4j
2. Amp 作者长文:别干等代理,拥抱异步给它们更大的任务
Amp 创建者 Thorsten Ball 把平时私发给朋友的用法写成文章《How I work with Agents》。核心观点:不要干等代理;如果你总在操心 TTFT(首 token 延迟),用法多半错了——应该拥抱异步,给代理更大的任务,让它们反过来等你。他自己点评「Amp 本身就是这套东西有效的无可辩驳的证据」,同时说明这是一家之言,不完全同意也值得当数据点。对被人机轮流干等卡住效率的用户,这是换节奏的参照。
3. 语音代理如何藏住慢工具调用的延迟,五种手法附代码
Outcome School 新文拆解语音代理的经典难题:工具调用要等几秒,电话线一静默,用户就以为掉线、开始「喂?」。核心原则是「永远别让线路安静」,文章给出五种手法:立刻说一句短话垫场、长等待时报进度、后台跑工具的同时继续对话、提前启动工具从源头缩短延迟、以及直接把工具做快,最后附完整代码。关键翻转是把「延迟问题」重新定义为「静默问题」:chat 界面有转圈,语音界面只有沉默。做语音代理的可以直接按清单逐条对照。
4. Raschka 从零构建推理模型的完整视频系列上线
Sebastian Raschka 宣布「从零构建推理模型」的完整视频系列已全部上线并互相链接,配套其此前的系列文章,内容覆盖推理模型的训练与构建路径,适合跟着代码逐步复现。作者同时预告 11 月回归,继续更新 LLM 模型与研究动态。从零系列一向是他口碑最好的教学资产,这次视频化明显降低了跟做门槛,链接直达课程页。
来源:Build Your Own Reasoning Model: A Full Video Course
Opinions/Thoughts
1. Anthropic 论文:科研代理的瓶颈在判断,不在执行
Anthropic 新论文 Agent4Sci 把 Claude Code、Codex、Gemini 放进 20 个真实 ML for Science 基准:直接读论文、改代码、跑实验,尝试超过原论文最好结果。前沿代理在全部基准上都找到提升,Claude Opus 平均相对提升 10.4%。但拆开轨迹看,大部分增益来自熟门熟路的工程技巧:调超参、换优化器、ensemble、局部搜索;代理还会高估想法的新颖性、闲置 GPU、或在第一个有效方向附近反复刷参数。作者只加了三个轻量 skill——科研构思、实验管理、定时自检——Opus 提升即翻倍到 20.1%,Codex 从 4.4% 到 8.1%。结论:先给代理科研习惯,比堆算力更划算。arXiv 编号 2610.28763。

2. 三平台同题投票:还手写超过两成代码的人有多少
Flask 作者 Armin Ronacher 在 X、Bluesky、Mastodon 三平台问了同一个问题:「你现在还手写超过 20% 的代码吗?」结果差异巨大:X 上 4326 人投票仅 12.7% 回答「是」,Bluesky 91 人有 26.4%,Mastodon 544 人高达 75.2%。回答「否」意味着八成以上代码已交给 AI 写。作者本人评价「比上次没那么离谱,但基本盘明显分裂」,事后又补发了扩大样本的更新图。这组数字是 AI 采用率与平台人群画像的双重快照:你问谁,决定你听到什么。

3. 循环与长成模型:复用网络层如何影响上下文学习
DAIR.AI 创始人 Elvis 推荐了一篇关于 looped 与 depth-grown 语言模型的阅读。这两类模型通过复用同一组层来换推理深度,是近期推理效率研究的热门方向;该文关注的问题是「复用层对 in-context learning 的影响」,在 3B 参数规模上对比 grown 与 looped 两种形态,发现两者的上下文学习收益都有提升,具体差异见原文配图。对追踪推理时计算与架构创新的读者,这是本周值得精读的一篇。

来源:@omarsar0