
Product
1. Vercel 为 AI SDK 建软件工厂
Vercel 写 AI SDK 的维护工厂:仓库月增 100+ issue,Opus 4.6 后堆积超过 1000 个 issue、近 800 个 PR,靠加人已补不上。他们按任务拆专用 agent——分类、复现、修复、评审、文档、功能分析与 backport——全部跑在隔离沙箱里,人只负责合入。四周后工厂撰写 25–35% 已合并 PR,关掉 70–80% issue。核心判断不是“再多一个 coding agent”,而是评审注意力才是瓶颈;风险越高,人审越深。数字来自官方博客四周样本,能否外推到别的仓库仍未知。
来源:Vercel
2. Unsloth 放出 Qwen3.8-27B 本地量化
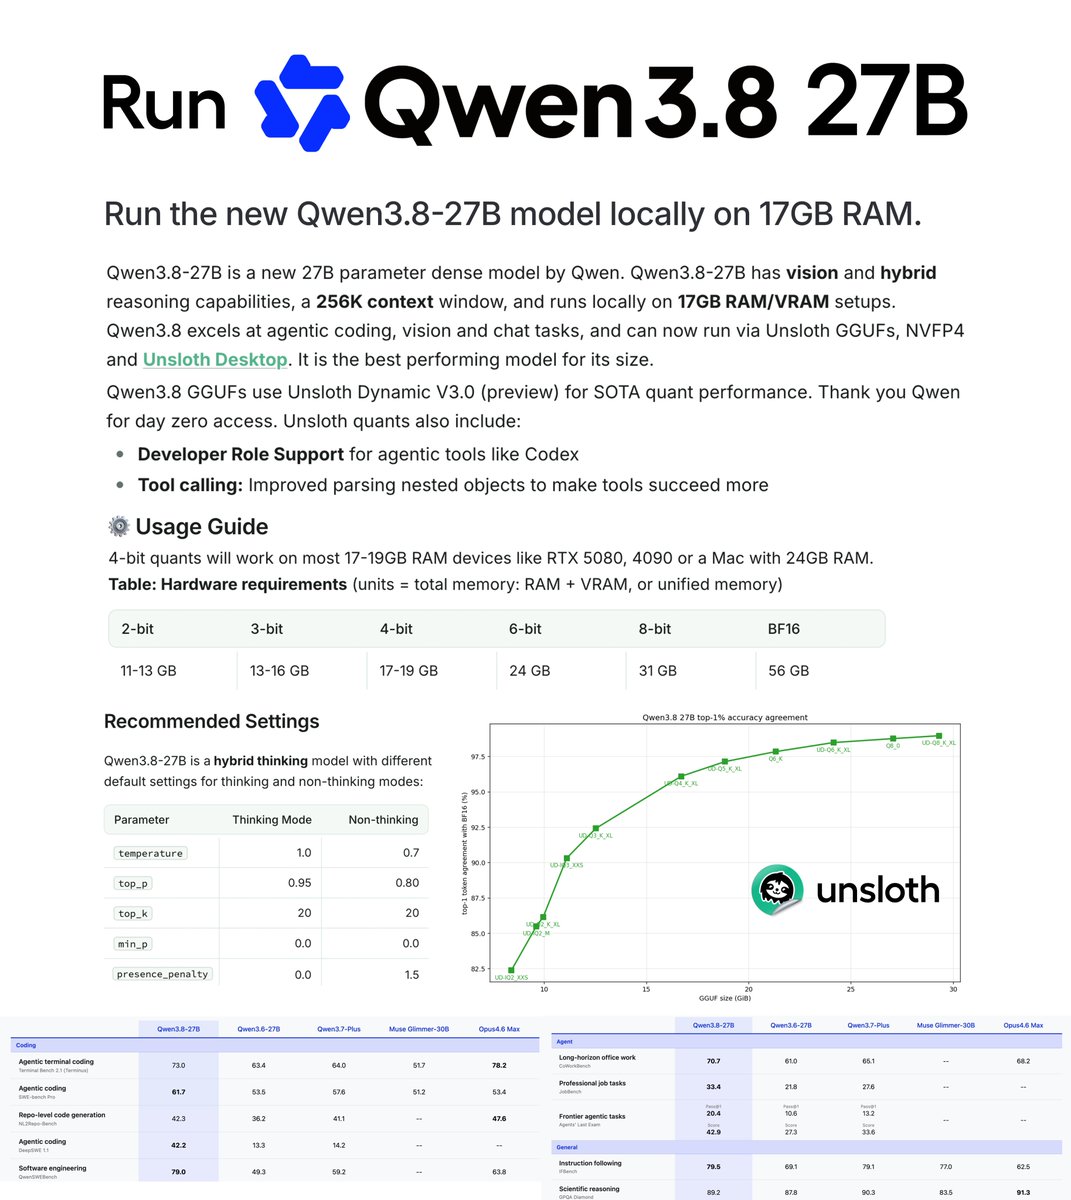
Unsloth 宣布 Qwen3.8-27B 可用 Dynamic GGUF 在约 17GB 内存上本地跑,并上传 NVFP4 量化;官方称它是同尺寸最强,原生多模态、262K 上下文、可扩到 1M。这把“笔记本级稠密模型”从预告推进到可下载权重。对开源本地栈是一次供给冲击:编码与办公工作流有了新的默认候选,也解释了为何同日出现大量本地 harness 与喂食器逆向实验。17GB 与“最强”都来自官方/Unsloth 表述,实际体验随量化位宽和后端变化。
来源:unsloth/Qwen3.8-27B-GGUF · Hugging Face
3. DeepSeek Harness 48 小时破十万星
Hesamation 称 DeepSeek Harness 成为增长最快的 GitHub 仓库,不到 48 小时破 10 万星,比 OpenClaw 还快。社区正面反馈集中在:tools、session log、agent loop、subagents 都是可替换插件,架构干净。星标速度会掺水分,但同日桌面端、侧栏、Windows 启动器、B 站 UP 插件扎堆出现,说明它正在变成默认宿主,而不只是又一个 CLI。星数与“最快”是作者统计口径,需对照仓库实时数据。

来源:@Hesamation
4. Codex Multi-agent v2 可委派任意模型
eric provencher 称本周低调上线:带 multi agents v2 的模型可以把任务委派给任意受支持模型,包括 Luna;花了不少时间保证可靠。这把 Codex 从“一个主模型带工具”推进到“主模型调度异构子代理”。对成本结构的含义是:规划用贵模型,批量执行用便宜模型,前提是委派真的稳。官方细节有限,可靠程度以实际产品为准,也需对照后文 Luna 与 Sol/Terra 的权限差。

来源:@pvncher
5. Ego Lite:给 Agent 用的免费浏览器
LinearUncle 安利 Ego Lite:自研 Chromium,让 Claude Code、Codex 等 agent 共享已登录浏览器状态,宣称可并行上百个自动化任务,比 agent-browser 快 3.45 倍且更省 token。卖点是 Spaces 隔离,以及语义 snapshot 能进 iframe、Shadow DOM 和第三方 SDK 组件。这是“agent 浏览器”品类的又一次产品化,且强调免费零配置。速度数字来自官网,未独立验证;用于社媒爬取需自行承担平台风险。
来源:ego (lite)
6. Claude 或将上线模型对比界面
TestingCatalog 称 Anthropic 在做 Model Comparison:并排看不同模型回复,可开关 memory、hold 回复,形态也不像传统 A/B 测试 UI。若落地,产品层等于承认“没有一个默认模型适合所有任务”,把选型交给用户会话。这与 Codex 把任务派给 Luna 是同一结构:模型开始被当成可切换的工人,而不是单一人格。目前是泄露/观察,不是官方发布,界面与能力可能变。

Tutorial
1. 推理时提升 LLM 的八种生产方法
Avi Chawla 长文梳理 Google、OpenAI、Anthropic 在生产环境里用的 8 种推理时增强技术。核心判断是:任务准确率不够时,最便宜的干预点是 inference,不必重训权重;改动落在 prompt 或调用编排上。文中按权衡与实践笔记展开,强调这些方法今天已在前沿实验室跑着。对工程团队的含义是,先把搜索、验证、编排做对,再考虑烧训练预算。文章是 X article,条目细节以作者整理为准。
来源:How Production LLMs Reason Better at Inference Time (as researched by Google, OpenAI, and Anthropic)
2. 讲清 GPU 为何不等于更高吞吐
Akshay 写了一篇面向 LLM 工程师的 GPU 直觉文:规格表上的算力峰值,很少直接翻译成 tokens/s。租来顶级卡、利用率看着很高,生成却可能被显存带宽、量化、投机解码和 continuous batching 卡住。文章目标是让这些“技巧清单”变成对硬件瓶颈的理解,而不是背术语。对本地和服务端部署都有用:先判断你是算力墙还是带宽墙。原文是 X article,未逐条核对全部技术细节。

3. 从零做一个 AI 文本检测器
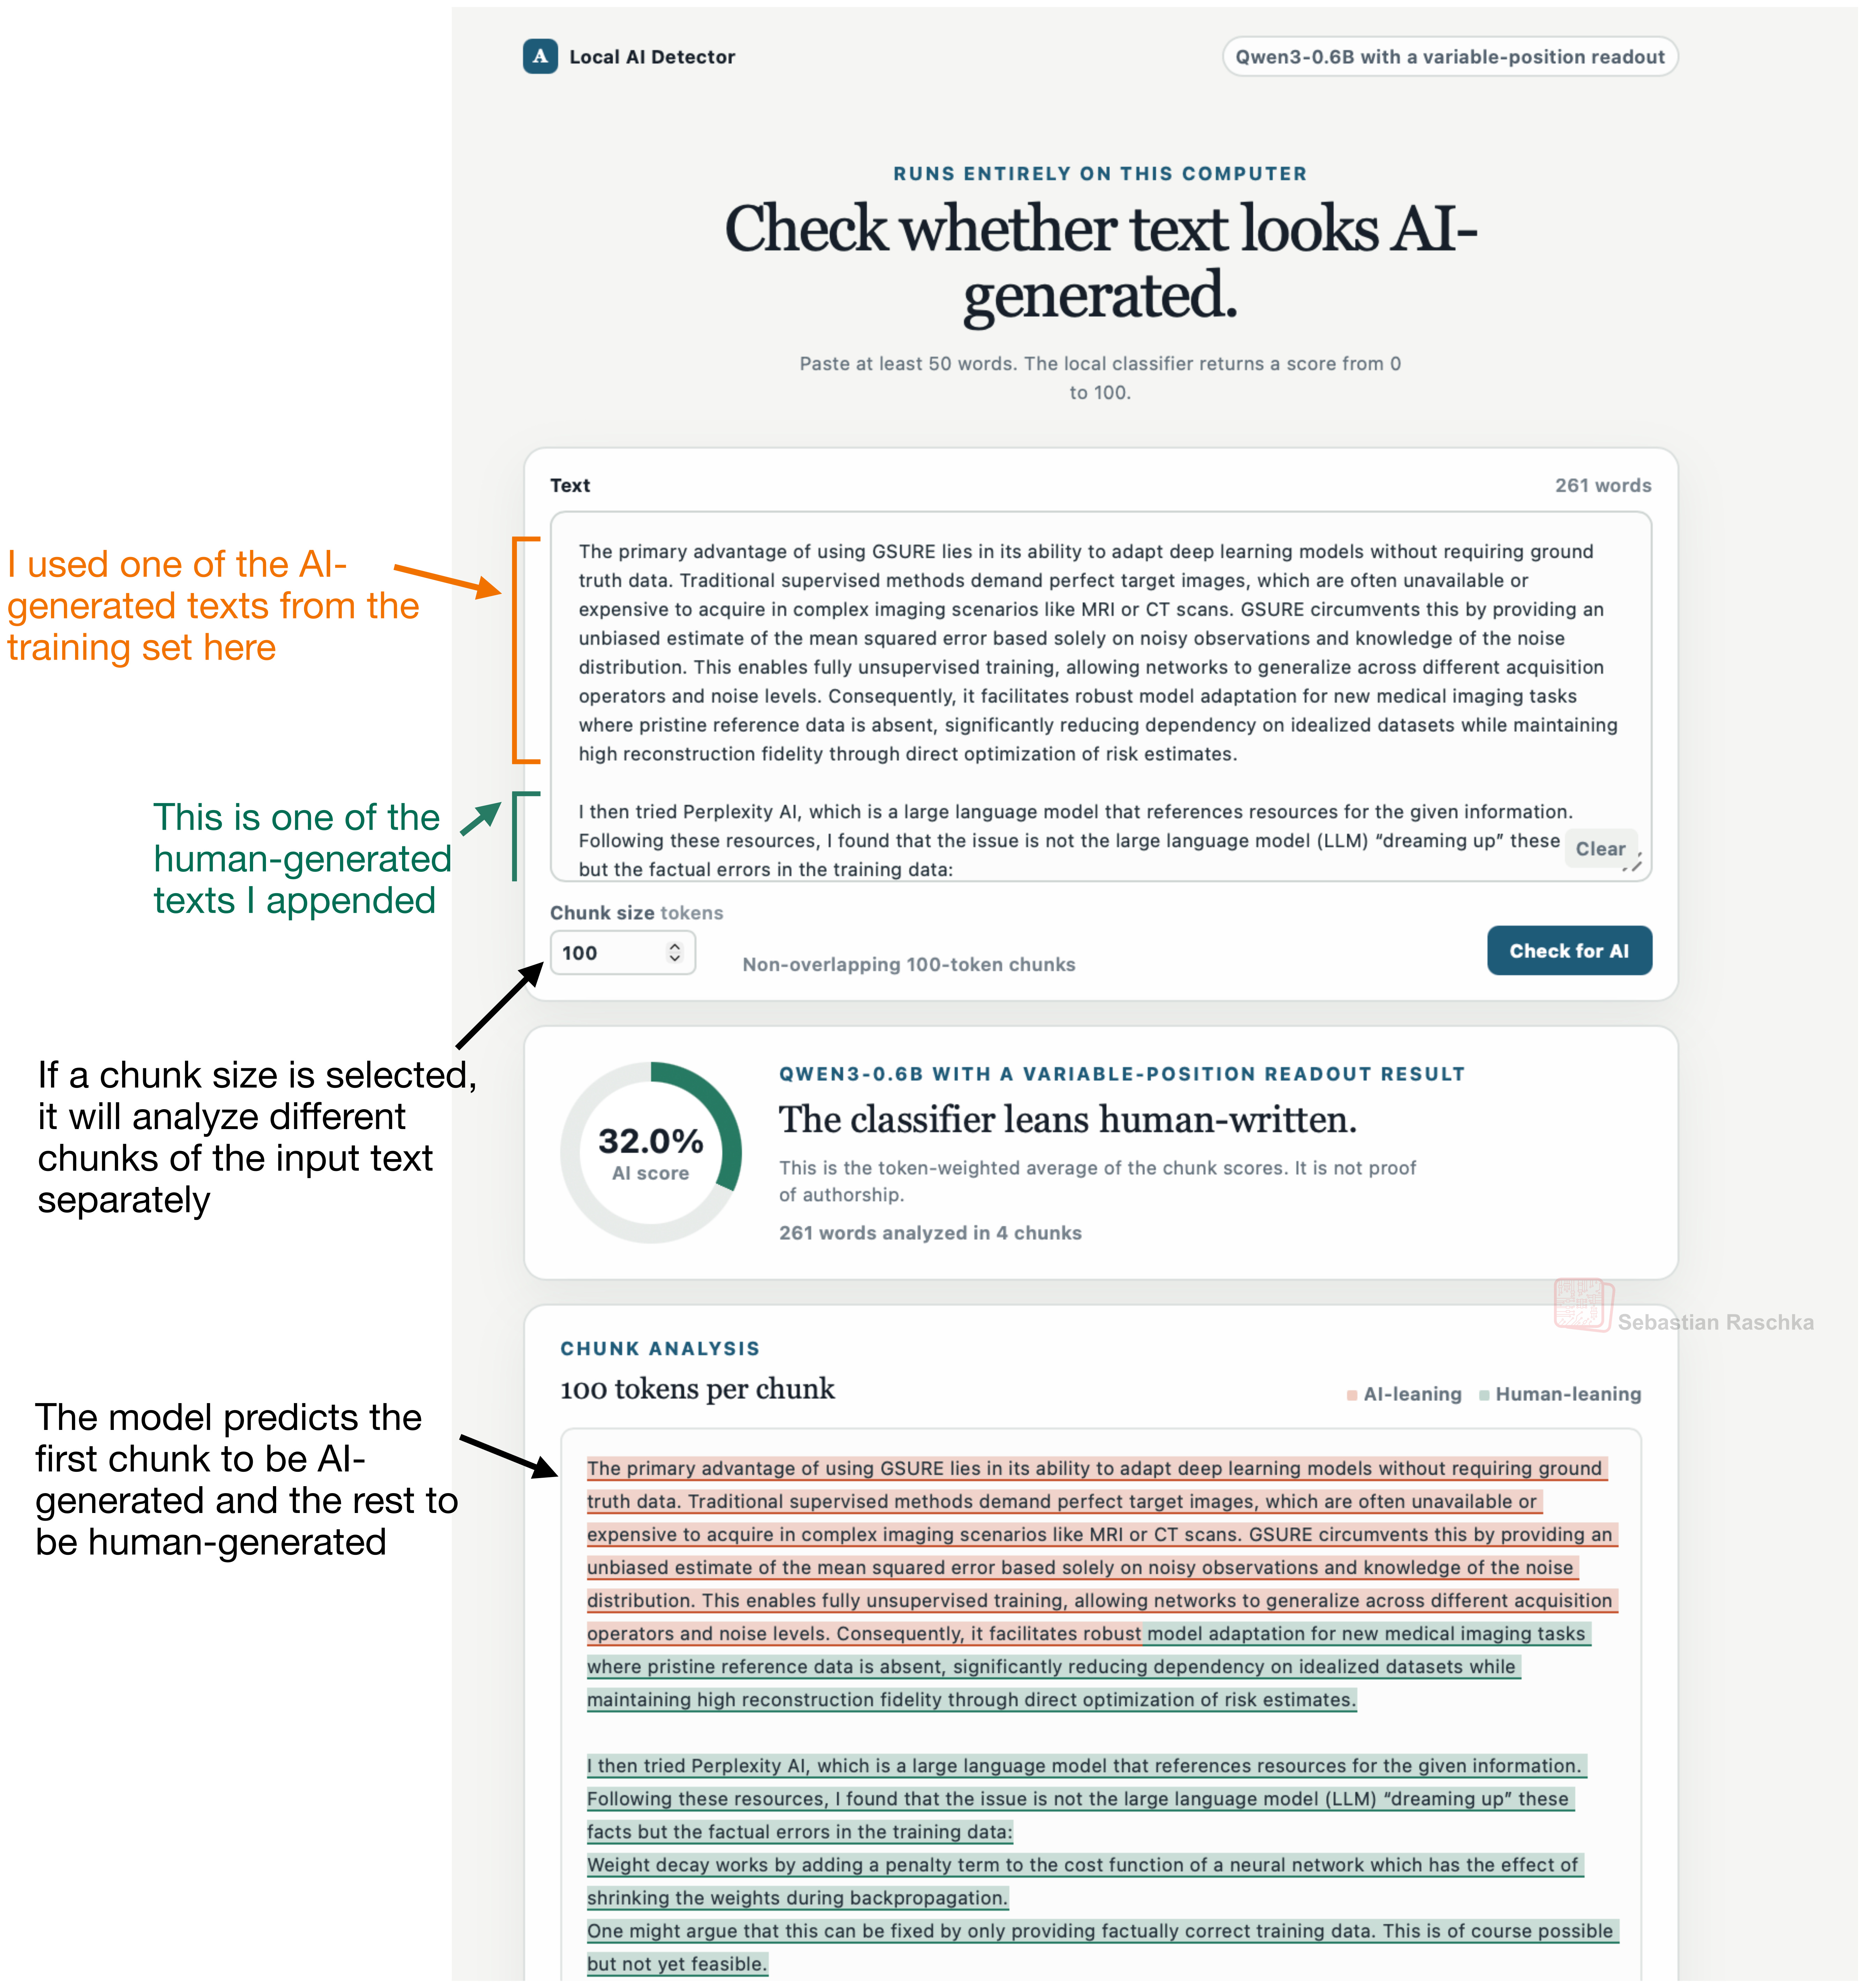
Sebastian Raschka 借 Substack 上线 AI 检测功能,写端到端教程:构数据集、微调 DistilBERT 出 0–100 分、本地部署 API 与 UI,再用检测器当 verifier 做 RLVR,训练小模型写出“不被检出”的文本。目标是讲清检测器局限与 verifier 用法,而不是承诺万能鉴定。他强调这是猫鼠游戏,分数只是分类器在训练分布上的估计,不能当成文本由 AI 所写的一般概率。适合当检测方法论入门。
来源:Ahead of AI
4. Raschka 图解 Claude 文本水印
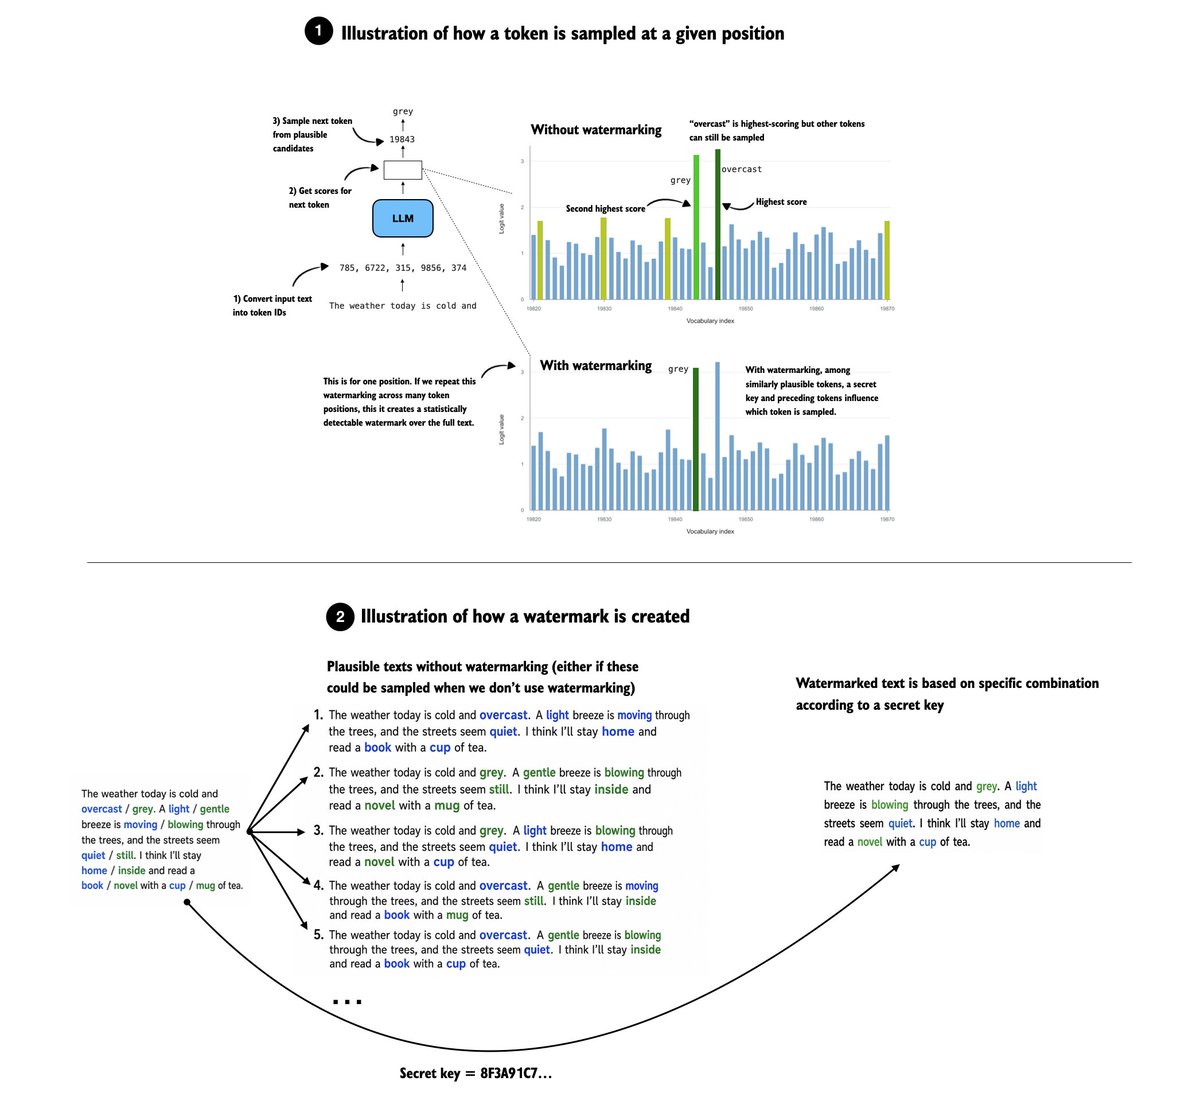
Sebastian Raschka 根据 Anthropic 公开材料画了 Claude 水印示意:生成时某些位置有多个高分 token,通常 top-k/top-p 采样;水印则在不明显伤质量的前提下偏向绿名单 token。它把“无质量损失的水印”从违反直觉,变成可画出来的采样偏置。配合 EU AI Act 合规背景,说明水印已从论文走进默认产品。图是作者解读,不是 Anthropic 官方图,实现参数仍以官方 FAQ 为准。
来源:@rasbt
Opinions/Thoughts
1. 任务变便宜之后,工作本身才露出来
Sunil Pai 写 Cloudflare Builder in Residence 上任文:coding agent 让他午饭前能做出三个错误东西,路线图却没有短十倍。他用 Jobs to be Done 区分 task 与 job——有时要机器把事办掉,有时要自己把手伸进材料里。软件团队的工作从来不是“产出实现”,而是决定什么值得做、哪些功能放在一起会变差。这是对 agent 生产力叙事最清醒的纠偏之一。观点文,不是实证报告。

来源:Solving the decision problem
2. HN 热议:为何 Opus 5 用起来更差
Mario Zechner 转发 HN 帖《Why does Opus 5 feel worse to work with?》,并说很多批评对得上自己的体感:Claude 曾是最好说话的模型,现在句子绕、抽象、爱用无生命主语。帖子高赞且评论极多,说明“能力榜上涨、协作手感下跌”已是广泛抱怨,而不只是个例。对选型的含义是:基准分无法覆盖语气与可协作性。这是用户体验汇总,不是官方评测,也未证明下一版会回到旧手感。