
Product
1. Firecrawl 开源 anydoc:14 种文档毫秒级转 Markdown
Firecrawl 发布 Rust 编写的 anydoc,能把 Word、PPT、Excel、OpenDocument、RTF、EPUB、CSV、PDF 等 14 种格式统一转成干净的 GitHub 风格 Markdown,附 Node.js 与 Python 绑定。卖点是无视输入格式输出一致,单文档转换进入个位数毫秒级,可直接喂给 LLM。它以 Agent Skill 分发(npx skills add firecrawl/anydoc),可在 Claude Code、Codex、Cursor、OpenCode 中被教会读任意文档;也提供 @firecrawl/anydoc CLI。anydoc 还驱动 Firecrawl 托管 Parse 服务,对扫描页这类读不了的部分再叠加 OCR。对需要把杂乱办公文档纳入 RAG/agent 上下文的场景,这是轻量且可自托管的选项。
来源:GitHub
2. ui.sh:Tailwind/Refactoring UI 团队的界面构建 agent 技能
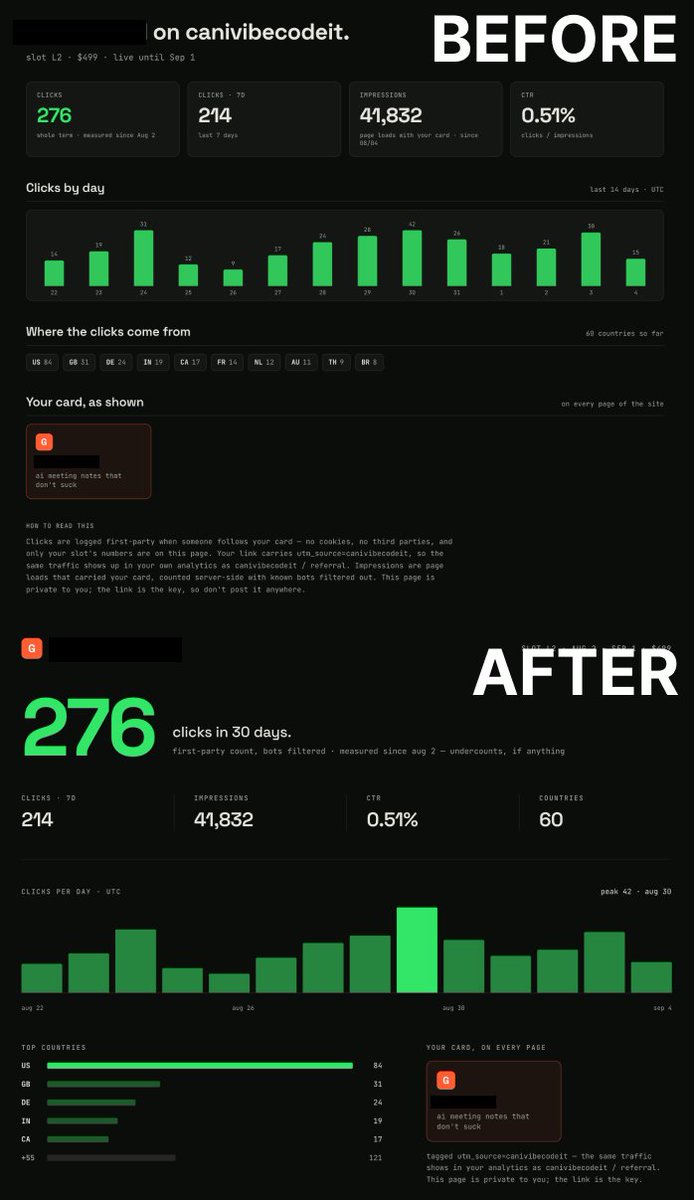
ui.sh 是由 Tailwind CSS 与 Refactoring UI 背后的团队推出的面向界面构建者的 agent 技能集合,定位为一组由资深设计师水准打磨、任务导向的提示与工作流。覆盖能力包括:基于设计专长构建新 UI、在浏览器中生成并对比多个设计方向、为新产品生成视觉品牌方向(Brand Kit)、把大块 UI 代码重构为可复用组件、规范化排序 Tailwind 类、加暗色模式、把亮色位图适配为暗色、做响应式、以及把截图线框转为语义化标记。目前需申请邀请。从演示看一个 prompt 前后差异惊人,本质是把设计判断编码进 agent 可调用的技能,让非设计背景的开发者也能拿到不掉水准的 UI 产出。
来源:ui.sh — Agent skills for interface builders
3. 字节 Dreamina 全球首发 Seedance 2.5:50 参考资产、最长 3 分钟
字节跳动旗下 Dreamina 全球首发视频模型 Seedance 2.5(Dreamina 与 TikTok 同属字节)。核心能力包括:支持最多 50 个参考资产、单段最长 30 秒直出生成、可串联叙事至 3 分钟、支持局部编辑(local edits),以及 3D-to-video 工作流。这套组合把多参考一致性、长叙事与局部重绘放到同一模型里,瞄准的是有连续性要求的叙事与广告场景而非单段炫技。值得注意的行业信号是:开源与低价竞争(如 Krea 称 MiniMax H3 在功能上逼近 Seedance)正把商业视频模型的差异点推向长内容与可控编辑。
4. Pierre Diffs 上线 Edit 模式:文件与 diff 可就地编辑
Charlie Holtz 宣布 Conductor 内的 Pierre Diffs 上线 Edit(编辑)模式。它是一个轻量、SSR、移动端友好的可编辑文件与 diff 层,基于 @pierre/diffs 构建,支持就地编辑、选区管理、多光标、撤销历史、查找替换与 lint 标记。可在只读 Review 与实时 Edit 之间切换,并在文件视图与 diff 视图、统一视图与并排分屏之间切换。它填补了代码评审与 agent 协作工具中长期缺少高质量就地编辑层的空白——大多数 diff 工具只读,而这里把编辑器级的人体工学搬了进来。对重度依赖 Conductor/agent 协作工作流的团队是实用增强。
来源:Pierre Diffs — now with edit
5. BFL 发布 FLUX 3 Video:原生音频、最长 20 秒、1080p
Black Forest Labs(BFL)发布 FLUX 3 Video 模型。支持图生视频(i2v)与文生视频(t2v),并带原生音频;单段最长 20 秒、原生 1080p。新增 Draft 模式,可在花费完整成本前先快速生成一段预览样片。官方预告 2K、4K 分辨率与开放权重(Open Weights)即将到来。原生音频加中长时长加高分辨率加草稿预览的组合,使其在创作者工作流里更可用;而开放权重在路上则对当下闭源视频模型格局构成潜在冲击。具体定价与许可证待公布。
6. Cloudflare 推出 Agent 专用钱包:唯一地址与用户名
Cloudflare 推出一款专门给 agent 使用的钱包,每个钱包拥有唯一的链上地址与用户名。领取后,你的 agent 即可用该钱包支付 API 与内容费用。钱包分为两类(具体类别见原文)。Op7418 提醒可先抢注一个自己名字的钱包地址,以防被占。这与同期发布的 Cloudflare computer(agent runtime)形成互补——当 agent 有了自己的电脑与自己的钱包,agent 作为自主经济主体的基础设施正在被补齐。它也预示着 agent 之间、agent 与服务之间的自动化微支付可能成为新的默认交互模式。

来源:@op7418
7. Cursor 开源 MoK:NVL72 上的 MoE 训练 megakernel
Cursor 宣布开源 Mixture-of-Kittens(MoK),其面向 NVL72 的 MoE(混合专家)训练 megakernel。它把所有 MoE 的通信与计算融合进单个完全确定性的 kernel,相比最强公开基线最高提速 2.37 倍。意义在于:这是 coding agent 厂商把自己的底层训练与算子优化开源出来,对关注大规模 MoE 训练效率的基础设施团队有直接参考价值。完全确定性也意味着结果可复现,便于调试与对齐实验。这是 Cursor 在产品之外展示其底层系统实力的一个信号。

来源:@cursor_ai
Tutorial
1. 带不走的会话:判断一个 agent session 是否真属于你
这篇来自 Earendil 的文章提出一个五部分检验,用来判断一个 agent 会话是否真的属于你:inspect(检查)、export(导出)、replay(重放)、audit(审计)、delete(删除)。它直击一个被忽视但越来越关键的问题——当 agent 会话承载了大量你的上下文、偏好与决策历史时,你对它的可支配权到底有多大。这五项本质上是一份 agent 会话可移植性与数据主权的检查清单,对选型(尤其是把 agent 会话托管在第三方平台时)具有实操参考意义。它也与同期 Cloudflare computer 与钱包等给 agent 自己的电脑方向形成互补:一侧谈基础设施,一侧谈权属。
来源:The session you cannot take with you
Opinions/Thoughts
1. 自我反思循环到底值不值?一篇认真做的对照实验
Elvis(omarsar0)推荐了一篇终于认真检验自我反思循环是否值得的论文。实验设置覆盖七种方法、1.5B/3B/7B 三档开源模型、两个数学基准、每个 150 道题,并严格统计每一个生成 token——包括花在批判、反思、辩论回合与检查上的 token。换言之,它把反思带来的收益和反思本身烧掉的算子放在同一杆秤上衡量,而不是只看最终正确率。这类研究对当下热衷于给 agent 套多层反思/辩论框架的趋势是一剂清醒剂:很多看似提升的效果,可能被额外 token 成本乃至反思幻觉抵消。具体结论需回到论文,但其全 token 计量加开源小模型可比对照的方法论本身值得借鉴。

来源:@omarsar0
2. Earendil 实证:极简 harness(Pi)为何更省更猛
Earendil 发文论证刻意选择极简的 coding harness Pi 为何反而更便宜更强。Pi 开箱仅 4 个工具,系统提示与工具定义合计不到 1000 token,理念是大部分工作用基础工具即可完成、想要更多就自己扩展。文章以两个案例佐证:Databricks 在其多百万行代码库上 benchmarking 编码 agent 的研究中发现,按单任务成本衡量时 Pi 表现领先;Shopify 则通过其 pi-autoresearch 扩展得到理想结果。作者的反共识点在于:当行业普遍靠更大的提示、更多编排层、更高复杂度去追性能时,这些工具也变得更贵,而极简恰好是优势。不过这是 vendor 案例展示,具体数字需回到原文核实。
来源:Earendil
3. 自改进 autoresearch 的信心悬崖:自我评判何时失灵
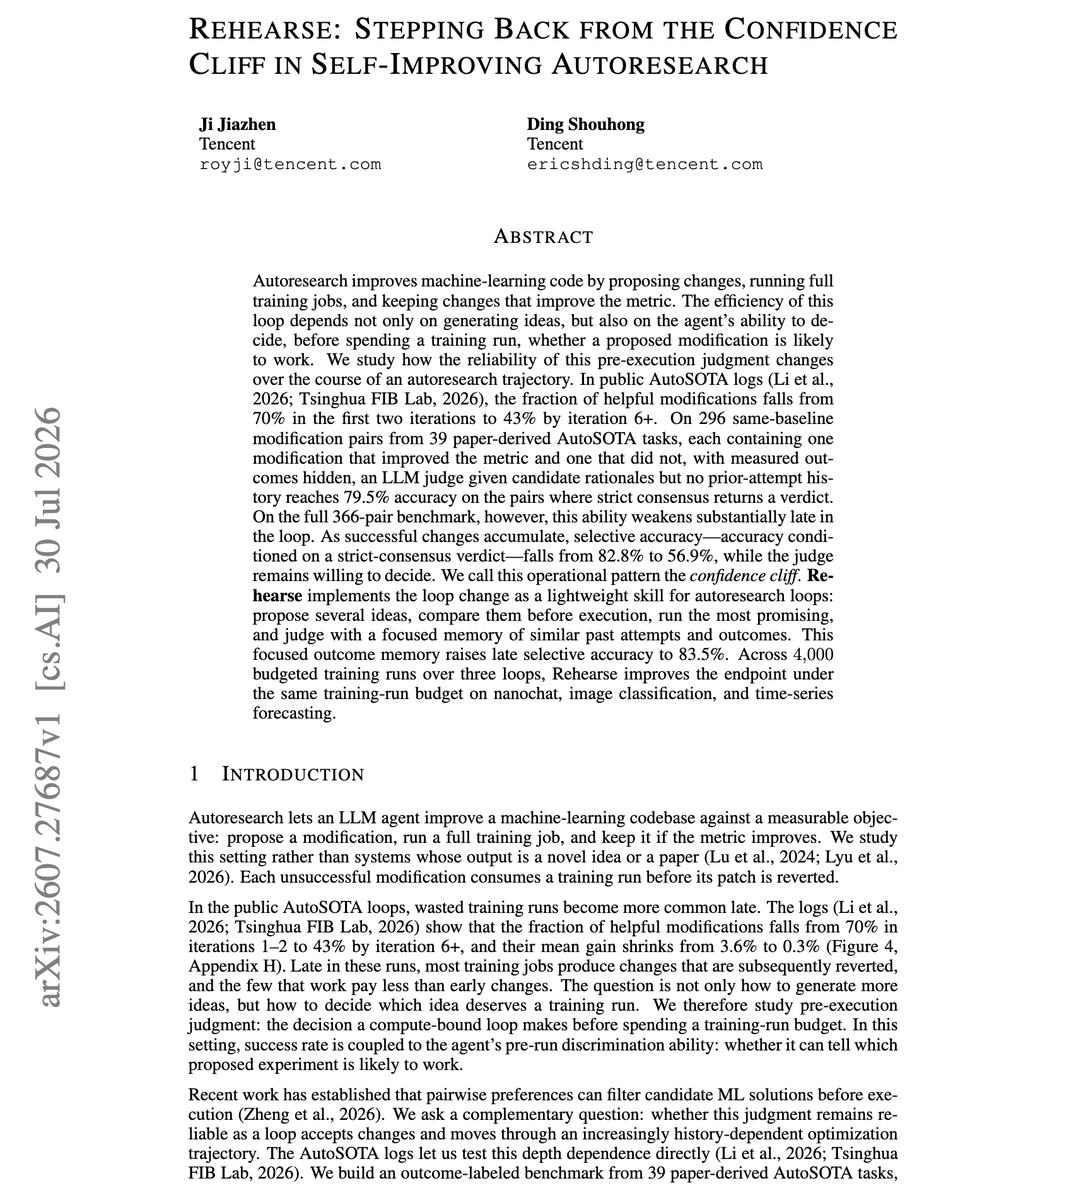
DAIR.AI 引用一篇论文指出,自改进式的 autoresearch(自动研究)循环仍然相当脆弱,并点出一种典型失效模式:这类循环会在自我评判早已停止有效之后,仍然持续评判自己的点子。论文将这种判断已不再有信息量但 loop 仍在跑的现象刻画为一条信心悬崖——即系统对自己判断的置信度与真实改进之间出现背离。这对当前让 agent 自动提出假设、验证、迭代的研究方向是重要警示:自评信号的可靠性才是瓶颈,而非迭代次数。理解这条曲线,有助于在设计 autoresearch 与自我改进系统时设定更诚实的停止准则。
来源:@dair_ai