
Product
1. Apple 开源 Core AI Models 工具包,赋能端侧 AI 开发
Apple 发布了 Core AI Models 开源工具包,旨在简化在 iPhone 和 Mac 上运行本地 AI 模型的过程。该工具包包含 Hugging Face 模型导出配方、用于 Apple Silicon 的 Python 原生模型编写原语,以及用于 iOS/macOS 应用集成的 Swift 包。值得注意的是,Apple 还为 Claude Code 等主流编码 Agent 提供了官方技能插件,使其能够自动处理模型压缩、量化及部署。此举标志着 Apple 正在将端侧推理能力深度嵌入开发者生态。

来源:GitHub
2. Anthropic 发布 Claude Fable 5 模型,集成至 GitHub Copilot
Anthropic 正式发布 Mythos 模型系列的首个成员 Claude Fable 5,现已在 GitHub Copilot 中全面可用。该模型专为长周期、自主编码及知识密集型任务设计,在处理复杂工作流时表现出比 Opus 系列更高的效率和更低的工具调用频率。Fable 5 引入了新的安全分类器,要求数据保留以进行合规性检查。目前该模型已向 Copilot Pro、Business 及 Enterprise 用户分阶段推送,支持 VS Code、CLI 及移动端等多种开发环境。
3. The Drive AI 推出文档智能 API,支持结构化数据提取
The Drive AI 开源了其内部文档智能 API,旨在从任何文件或 URL 中提取结构化数据。该 API 提供 Extract 和 Analyze 两种模式:Extract 专注于从发票、合同等文档中提取 typed JSON 数据,并提供置信度评分和原文引用;Analyze 则利用 Agent 逻辑进行跨页推理和计算,如计算财报中的 YoY 增长率。该系统支持 107 种以上格式,旨在解决非结构化数据转化为数据库可用数据的痛点。
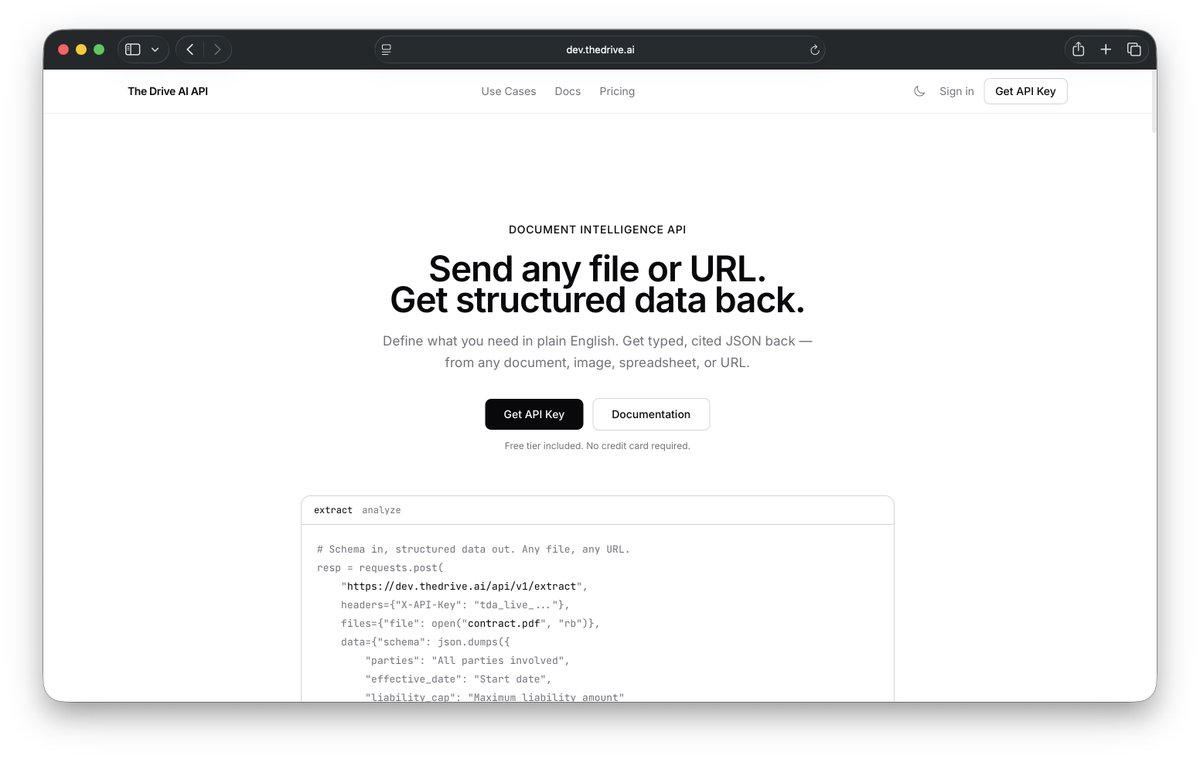
来源:The Drive AI — Structured data from any file or URL
4. Vercel CLI 新增域名搜索功能
Vercel CLI 现已支持直接通过命令行搜索域名。用户可以使用
vercel domains search命令查询域名可用性及价格,并支持按 TLD 过滤、排序及 JSON 格式输出。此功能与 Vercel 网页端使用相同的搜索后端,旨在为开发者提供更高效的域名管理体验,进一步完善了 Vercel 的开发者工具生态。
来源:Vercel
5. NotebookLM 核心聊天功能升级
NotebookLM 升级了其核心聊天系统,从传统的 RAG 转向类似 Agent 的架构,并为每个笔记本配备云端计算机,利用 Gemini 3.5 模型进行深度文件分析。
6. Spiral:面向人类与 Agent 的写作伙伴
Spiral 是一款专为人类和 AI Agent 设计的写作工具,支持文体风格定制、CLI、MCP/API 集成及团队协作功能。
7. ChatGPT 记忆系统升级:Dreaming v3
ChatGPT 的记忆系统更新至 Dreaming v3,具备更强的回溯能力,能更精准地遵循用户长期偏好并实现自我修正。
8. Google 降低 AI 订阅计划价格
Google 将其入门级 AI 订阅计划价格从每月 7.99 美元降至 4.99 美元,并提供双倍存储空间。
Tutorial
1. 记忆增强神经网络:检索与持续学习的未来
本文探讨了记忆增强神经网络(MANN)在现代 Agent 中的应用潜力。作者回顾了从 Memory Networks 到 Neural Turing Machines 的技术演进,并指出 DeepSeek 的 Engram 等现代模块正在实现知识的稀疏查找。文章强调,随着 Agent 任务周期从周扩展到月,如何将信息写入模型参数而不发生灾难性遗忘,以及如何实现测试时训练(Test-time training),将成为 Agent 架构设计的核心挑战。
来源:Memory Augmented Neural Networks for Retrieval and Continual Learning | Amplify Partners
2. Self-Harness:一种能够自我进化的 Agent 框架
研究人员提出了一种名为 Self-Harness 的新范式,旨在让 LLM Agent 能够自我优化其运行环境(Harness)。该框架通过三个阶段实现:弱点挖掘(识别执行轨迹中的失败模式)、Harness 提案(生成针对性的修改建议)以及提案验证(通过回归测试)。实验表明,Self-Harness 能够显著提升 Agent 在 Terminal-Bench 2.0 上的表现,将原本需要人工维护的脚手架转变为可随模型进化而自动改进的资产。

来源:arXiv.org
3. Codex 中 /goal 指令使用指南
一份关于如何在 Codex 中有效使用 /goal 指令的实用教程。
Opinions/Thoughts
1. Claude Fable 5 在销售评估基准测试中的表现
作者在 SalesEvals 基准测试中对 Claude Fable 5 进行了评估。该基准测试通过 50 个合成销售通话场景来衡量 AI 的教练能力。初步结果显示 Fable 5 在处理复杂销售对话时表现出极高的智能水平,但也伴随着高昂的 token 消耗。这引发了关于在实际业务场景中,如何平衡模型性能与运营成本的讨论。
2. Andrej Karpathy 对 Claude Fable 5 的评价:Major 版本升级
Andrej Karpathy 评价 Claude Fable 5 为一次重大版本升级,其能力提升幅度堪比 2025 年 11 月的 Claude 4.5。他指出,该模型在处理长周期、高难度问题时表现出色,能够理解复杂的任务意图并自主执行。尽管模型仍存在一些 quirks 且安全限制过于敏感,但其带来的生产力提升显著。Karpathy 强调,随着软件开发变得越来越“触手可及”,开发者对软件的需求将呈指数级增长。
来源:@karpathy
3. 对 Anthropic Fable/Mythos 基准测试的质疑
作者指出 Anthropic 在发布 Fable/Mythos 模型时,在基准测试中存在选择性偏差。Anthropic 似乎选择了两个版本中表现更好的结果进行合并,这可能导致结果被夸大 3%。此外,由于 Fable 5 在遇到安全拒绝时会自动回退至 Opus 4.8,这使得 Fable 5 的拒绝率在报告中显示为 0%,掩盖了模型在处理敏感任务时的实际局限性。

来源:@banteg
4. Agents’ Last Exam (ALE):衡量 Agent 真实工作能力的基准
研究人员推出了 Agents’ Last Exam (ALE),这是一个旨在衡量 AI Agent 是否具备真实工作能力的滚动基准测试。ALE 侧重于劳动力市场对齐的实际任务,而非简单的合成测试。测试结果显示,在最难的层级中,顶级 Agent 的通过率仅为 2.6%。该基准旨在揭示当前 Agent 在处理复杂、真实工作流时的实际局限性。
来源:@YiyouSun