
Product
1. 本周顶级 AI 研究论文精选(5月24日-5月31日)
本周 AI 研究论文精选涵盖了代理工作流优化、模型蒸馏、科学预测及上下文管理等前沿领域。重点论文包括:SkillOpt 提出将自然语言技能文档作为可训练参数;Compiling Agentic Workflows into Weights 探讨了将复杂代理逻辑蒸馏进模型权重以降低推理成本;AutoScientists 介绍了去中心化的多代理科学研究系统;以及关于 LLM “睡眠”机制以优化长上下文处理的研究。这些论文共同指向了一个趋势:AI 开发正从单纯的模型能力提升转向更高效的系统架构、接口适配及长效可靠性工程。
2. 效率前沿:LLM 上下文管理的统一优化框架
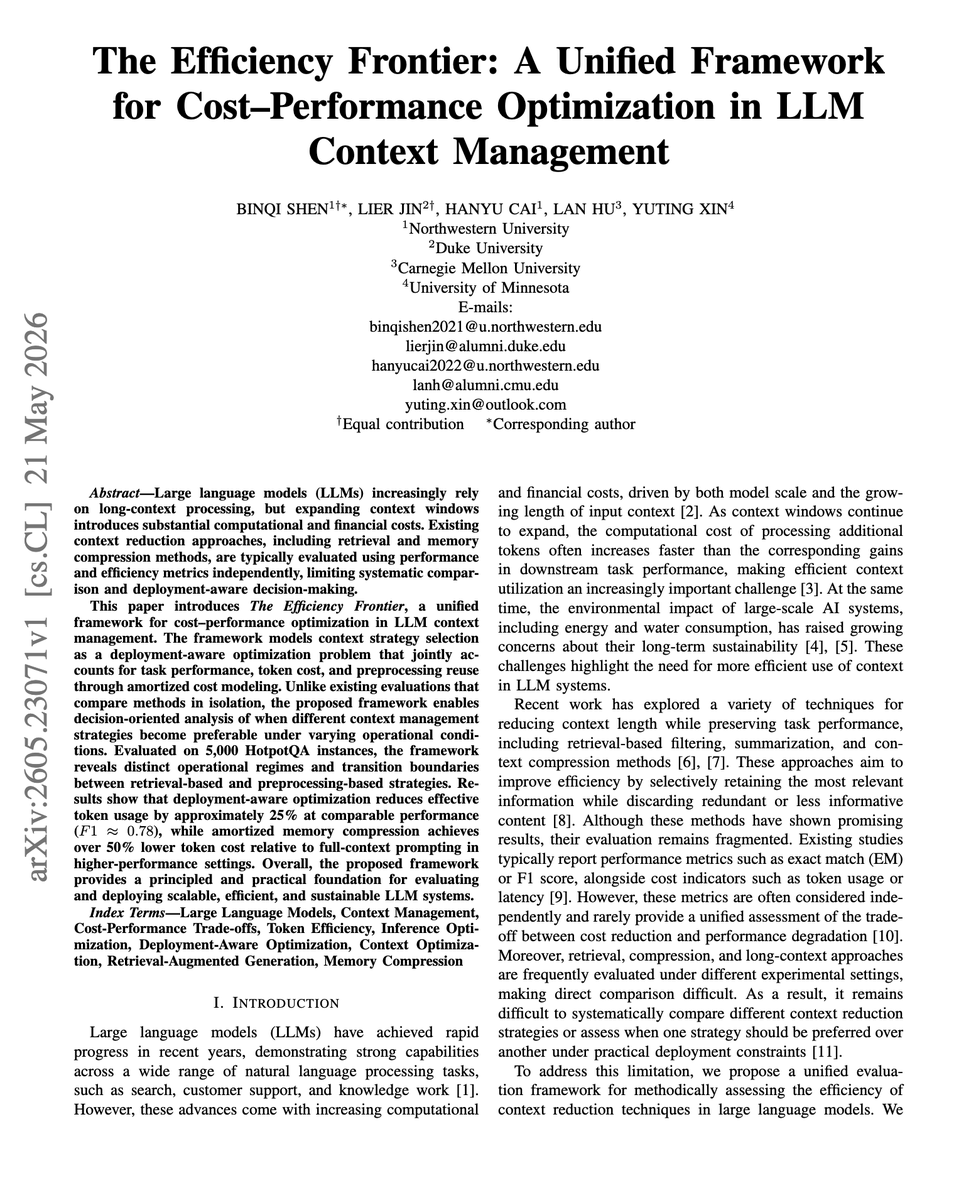
针对长上下文处理带来的高昂计算成本,本文提出了“效率前沿”(The Efficiency Frontier)框架。该框架将上下文策略选择建模为部署感知的优化问题,综合考虑任务性能、Token 成本和预处理复用率。研究发现,最优策略取决于任务的复用频率,而非单一的基准测试结果。在 HotpotQA 任务上的评估显示,通过部署感知的策略选择,可将有效 Token 使用量降低约 25%,且在高性能设置下,摊销内存压缩比全上下文提示节省超过 50% 的成本。该框架为企业级 AI 应用提供了量化的决策依据。
来源:arXiv.org
3. Hugging Face 呼吁公开编码与代理轨迹数据
Hugging Face 联合创始人 Clement Delangue 呼吁开发者公开分享编码与代理执行轨迹(Traces)数据。他指出,这些数据对于构建高质量数据集和训练更强大的开源模型至关重要。目前已有大量开发者开始贡献此类数据,Hugging Face 平台已上线相关数据集搜索功能。通过积累真实的代理交互轨迹,社区可以更好地理解 AI 在复杂任务中的决策过程,从而推动开源代理模型在推理能力和可靠性上的进步。
4. 微软 Copilot 超级应用泄露:集成编码与协作功能
微软即将推出的统一 Copilot 超级应用截图泄露,该应用预计将在 Build 2026 大会上发布。新应用包含“Copilot Code”和“Cowork”两个核心标签页,分别集成 GitHub Copilot 和协作工作流。此外,应用还内置了名为“Scout”的 24/7 始终在线 AI 代理。Copilot Code 界面类似于 Claude Code,支持本地与远程代码库切换、模型选择及自动化任务调度。这一举措标志着微软正致力于将分散的 AI 功能整合为统一的生产力平台,以应对日益激烈的 AI 代理竞争。

5. SkillSpector:NVIDIA 推出的 AI 代理技能安全扫描器
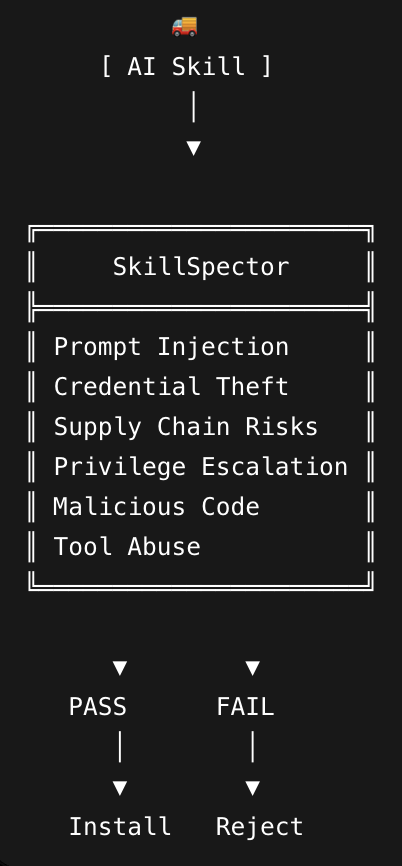
NVIDIA 发布了 SkillSpector,一款专门用于扫描 AI 代理技能(Skills)的安全工具。该工具包含 64 项安全检查,涵盖提示注入、凭据窃取、供应链漏洞及权限滥用等 16 个类别。SkillSpector 结合了快速静态分析与可选的 LLM 语义评估,能够生成 SARIF 格式的报告,便于集成到 CI/CD 流水线中。鉴于 AI 代理技能往往拥有隐式信任,该工具旨在为开发者提供“Semgrep + 防病毒”级别的安全保障,防止恶意技能对系统造成破坏。
来源:GitHub
Tutorial
1. 构建生产级 AI 代理团队的九个阶段路线图
针对多代理系统(Multi-Agent Systems)难以从 Demo 走向生产的问题,本文提出了九个阶段的构建路线图。核心在于从“单代理循环”出发,通过结构化的上下文管理、类型化工具模式、子代理隔离以及共享任务列表来实现协作。文章强调了“生产级”代理的关键要素:持久化记忆、操作的耐久性(Durability)、沙箱隔离以及严格的权限控制。通过引入评估(Evals)和轨迹检查(Trajectory Checks),开发者可以量化系统性能,避免在 Demo 阶段陷入“模型不够聪明”的误区,从而构建出真正可靠的自动化工作流。
来源:How to build a team of AI agents: 9 stages from first agent to production crew.
2. Claude Code + NotebookLM:构建可进化的研究系统
本文介绍了一种结合 Claude Code、NotebookLM 和 Obsidian 的高效研究工作流。通过 Claude Code 自动搜索 YouTube 资源,将其传递给 NotebookLM 进行深度分析,并将结果自动保存至 Obsidian 知识库。该系统不仅能自动生成分析报告、信息图表,还能通过 Obsidian 的笔记关联实现知识的长期积累。随着研究次数的增加,Claude Code 会通过读取 Obsidian 中的历史笔记,逐渐理解用户的思维模式和偏好,从而使输出结果越来越精准。这种模块化的流水线设计可轻松扩展至 PDF、网页等多种数据源。
来源:Claude Code + NotebookLM + Obsidian: Research Monster That Gets Smarter Every Time You Use It
3. 如何利用 Hermes 代理构建 AI 输出质量评估循环
针对 AI 生成内容中常见的“幻觉”和“平庸(Slop)”问题,本文提出了一种基于 Hermes 代理的评估循环(Eval Loop)系统。作者认为,单纯优化提示词无法解决质量问题,必须在输出端建立自动化的质量控制层。该系统通过定义测试用例、量化评估指标(0-1 分)和设定阈值,在内容发布或产品部署前自动拦截不合格的输出。通过将评估逻辑封装为 Hermes 的技能(Skills),系统能够实现自我进化,将失败的生成案例转化为新的测试用例,从而持续提升 AI 输出的质量底线。

来源:How To Fix AI Slop (Using Hermes)
Opinions/Thoughts
1. 从聊天机器人到工程系统:AI 开发范式的根本转变
文章指出,软件开发正经历从“AI 辅助编码”到“构建 AI 操作系统”的范式转移。开发者不再仅仅通过对话生成代码,而是通过构建包含记忆、上下文管理、代理编排和验证循环的系统来提升生产力。作者认为,模型能力的差距正在缩小,真正的竞争优势在于基础设施的构建——即如何管理上下文、实现会话持久化以及编排多代理协作。这种转变类似于云计算革命,早期采用者将获得难以逾越的竞争优势。未来的核心技能将从实现能力转向系统架构与智能编排。
来源:The Developers Building Systems Around AI Are About to Leave Everyone Else Behind..
2. 从 RAG 到 AI 记忆:代理持续学习的演进
文章探讨了 AI 代理从简单的 RAG(检索增强生成)向具备读写能力的“AI 记忆”系统的演进。RAG 仅限于一次性读取,而 AI 记忆系统能够通过读写外部知识库实现持续学习和个性化。作者介绍了 Graphiti 框架,它通过构建实时、具备时间感知能力的知识图谱,使代理能够跟踪事实的变化,并支持历史查询。文章强调,代理记忆的质量取决于自定义的 Pydantic 模式(Schema),良好的本体论定义是构建可靠、可进化的 AI 代理系统的基础。
来源:GitHub
3. 代理的“颅骨”:为何我们需要统一的记忆层
文章指出,当前 AI 代理生态存在严重的碎片化问题,每个代理都有自己独立的“大脑”和记忆,导致上下文无法在不同任务和工具间同步。作者认为,这种“知识被困在颅骨中”的现象是人类认知的局限,不应被复制到软件系统中。理想的架构是多个代理共享一个底层的记忆层,该层能够捕捉推理过程、失败路径和决策逻辑,而不仅仅是最终的产出物。通过 GBrain 等项目,开发者可以构建统一的知识图谱,使 AI 系统表现得像一个具备分布式能力的单一智能体。