
Product
1. AAFLOW:通过算子抽象实现 AI 代理工作流加速
研究人员推出了 AAFLOW,这是一个旨在解决 AI 代理工作流中数据编排和序列化开销的分布式运行时。通过将工作流建模为 Apache Arrow 和 Cylon 上的算子抽象,AAFLOW 实现了零拷贝数据平面,直接连接预处理、嵌入和检索环节。该系统利用资源确定性调度和异步批处理,在保持 LLM 生成吞吐量不变的前提下,实现了高达 4.64 倍的流水线加速。这一研究表明,AI 代理的性能瓶颈往往不在 LLM 推理本身,而在底层的分布式数据处理架构。

来源:arXiv.org
2. Reinforced Agent:在推理循环中引入实时反馈机制
针对工具调用代理的评估通常滞后于执行的问题,研究人员提出了一种在推理循环中进行实时评估的架构。通过引入一个专门的审查代理,在工具调用执行前对其进行检查,若发现偏差则注入反馈并引导主代理修正。该方法引入了“有用性-有害性”指标来量化反馈带来的收益与风险。实验表明,该架构在无需重新训练基座模型的情况下,显著提升了工具调用的准确性。这一成果证明了通过优化审查代理,可以实现生产环境下的可衡量精度提升。

来源:arXiv.org
3. DFlash:利用块扩散模型实现 8.5 倍推理加速
DFlash 是一种新型的轻量级块扩散模型,旨在解决 LLM 推理中逐个生成 token 的效率瓶颈。与传统的逐个猜测不同,DFlash 能够并行猜测多个 token,并由大模型进行批量验证。该技术已集成至 vLLM、SGLang 等主流框架,支持 Qwen、Llama 等多种模型。实验显示,DFlash 可将推理速度提升至原来的 8.5 倍,且不损失模型精度。这一突破为实现实时、低延迟的 AI 交互提供了新的技术支撑。
来源:GitHub
4. OpenClaw 运行时状态重构:转向 SQLite 存储模型
OpenClaw 项目近期提交了一项重大 PR,将运行时状态从分散的 JSON/JSONL 文件重构为基于 SQLite 的存储模型。该重构引入了共享控制平面数据库和每个代理独立的平面数据库,旨在提升数据处理的可靠性和查询效率。尽管配置文件和用户内容仍保持文件备份,但运行时数据、缓存及会话信息将统一由 SQLite 管理。这一架构调整标志着 OpenClaw 在处理大规模代理状态时的成熟度提升,为更复杂的代理协作奠定了基础。
来源:GitHub
5. OpenAI 拟在 ChatGPT 移动端增加 Codex 远程控制
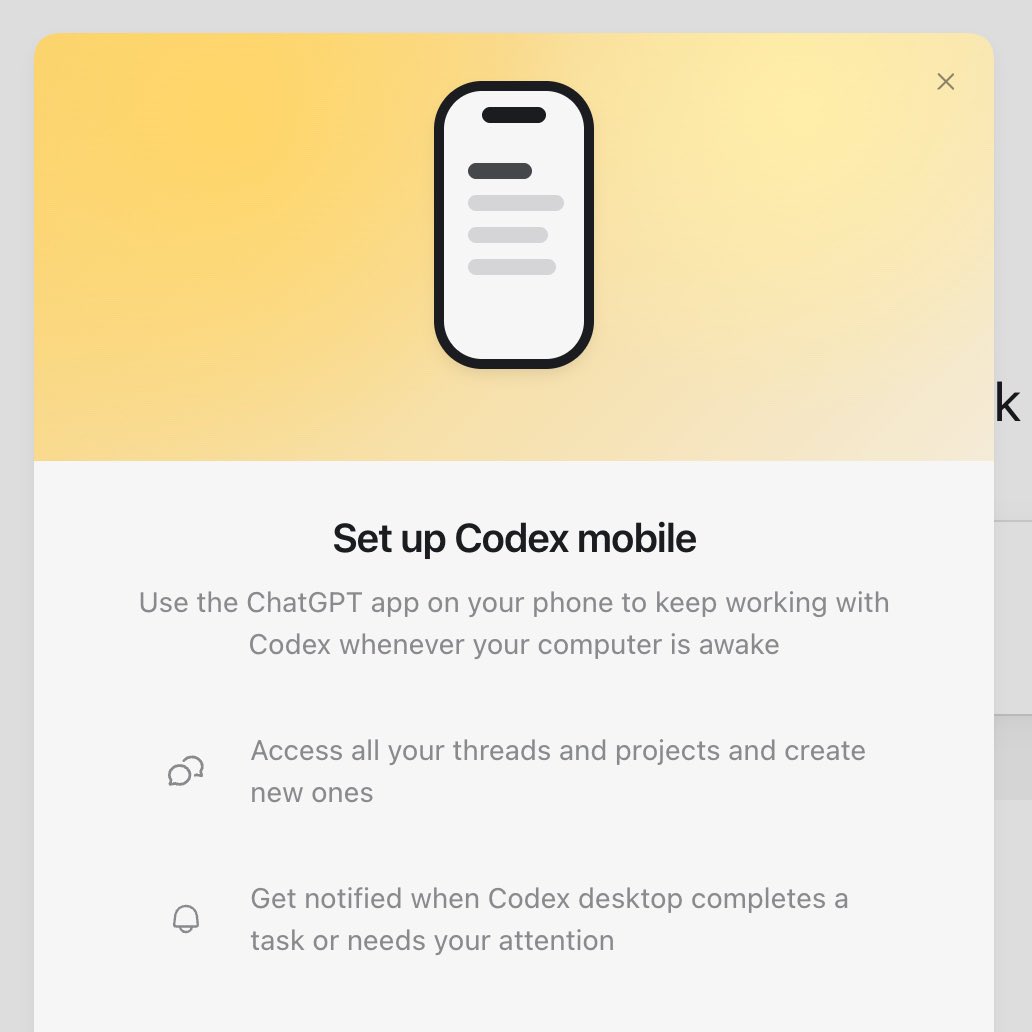
OpenAI 正在测试一项新功能,允许用户通过 ChatGPT 移动端直接控制 Codex。这一举措旨在统一开发者的编码工作流,实现跨设备协作。尽管社区猜测 OpenAI 可能在研发 AI 代理手机,但目前证据表明这更倾向于软件层面的集成。该功能将极大提升开发者在移动端监控和管理 AI 编码任务的便利性。

Tutorial
1. 通过“Skillify”模式彻底解决 AI 代理重复错误
Garry Tan 提出“Skillify”工作流,旨在将 AI 代理的每一次失败转化为永久性的结构化修复。该模式要求将失败转化为包含 SKILL.md 合约、确定性脚本、单元测试及 LLM 评估的完整技能包。通过这种方式,AI 代理不再依赖“请勿幻觉”等模糊指令,而是通过强制执行确定性代码来规避错误。该流程包含 10 个严格步骤,确保技能可被路由、测试且具备可维护性。这种方法将 AI 从单纯的聊天机器人转变为具备持久记忆和自我修复能力的操作系统。
来源:How to really stop your agents from making the same mistakes
2. Hugging Face CLI:高效阅读 AI 论文的新工具
Hugging Face 推出了官方 CLI 工具,旨在简化 AI 论文的阅读流程。用户只需通过简单的安装命令,即可使用
hf papers read [论文编号或 URL]指令直接在终端中获取论文内容。该工具同时支持 arXiv 和 Hugging Face 论文链接,极大提升了研究人员获取前沿知识的效率。对于习惯在终端工作的开发者而言,这是一个非常实用的生产力工具。

来源:hf.co
3. Lex Fridman 播客字幕资源:AI 代理的优质语料库
Lex Fridman 播客官网提供了所有剧集的脚本字幕,无需通过 YouTube 下载即可直接获取。这些高质量的对话内容涵盖了技术、历史、哲学等多个领域,是 AI 代理进行知识检索、总结及分析的优质语料库。开发者可以直接利用这些字幕数据,构建基于特定领域知识的 AI 助手或分析工具。

来源:Lex Fridman
4. 构建有效 AI 代理技能的 9 条原则
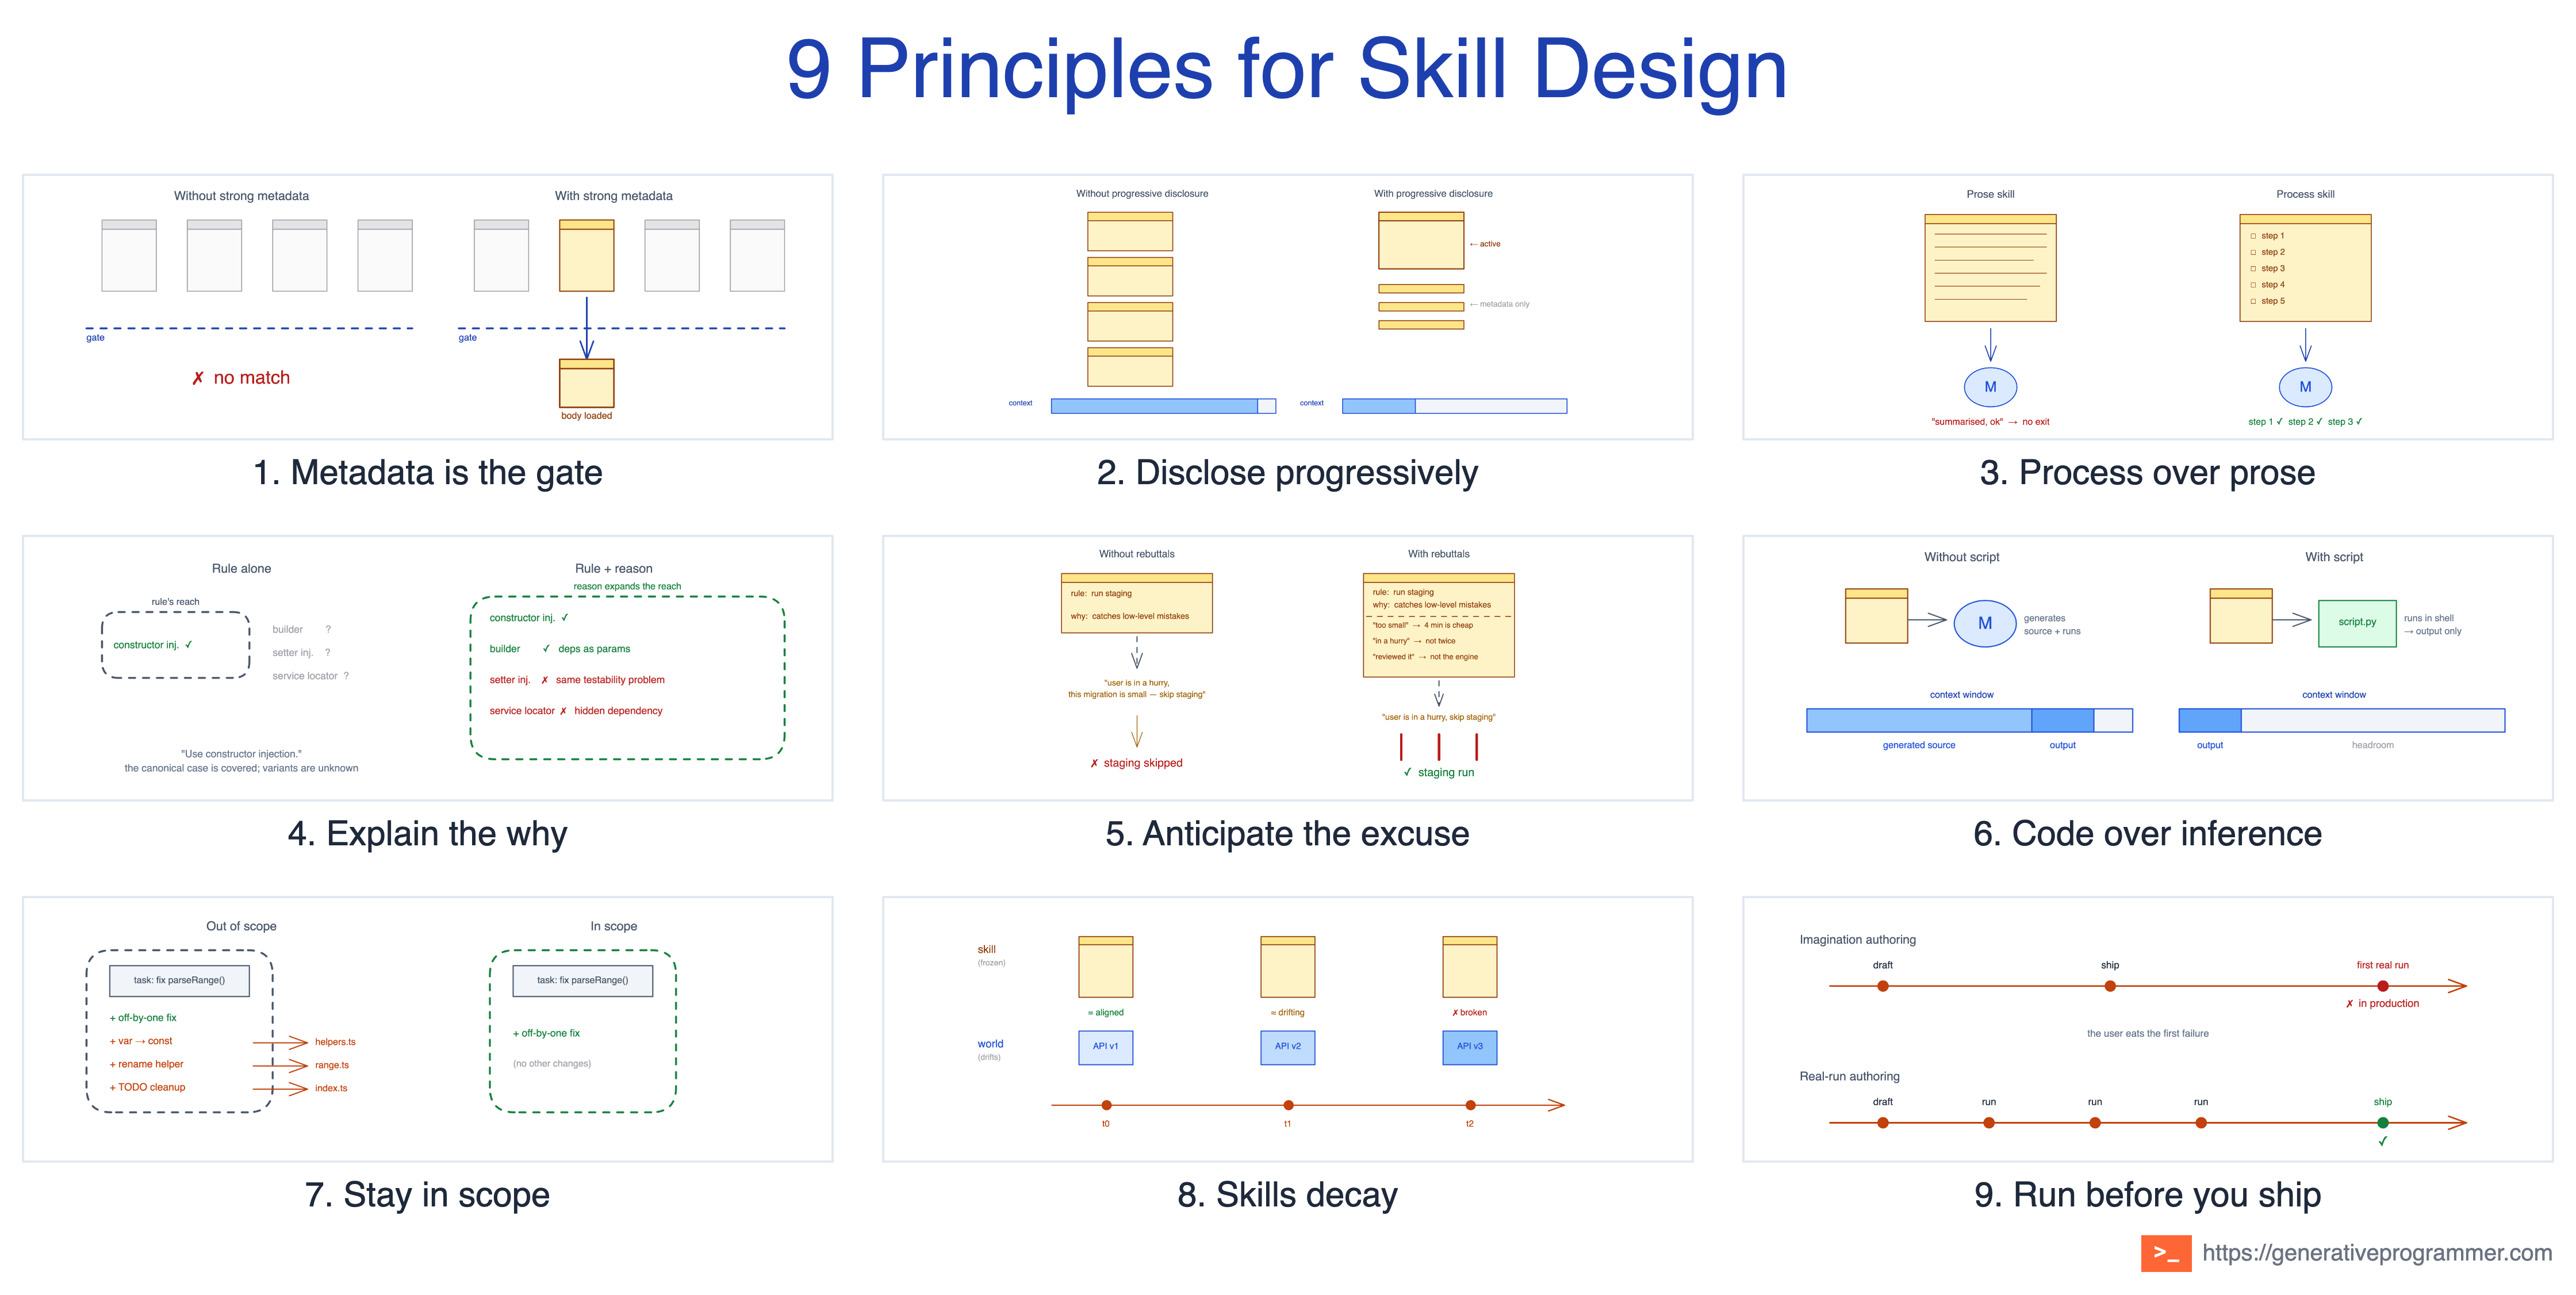
文章提出了构建 AI 代理技能的九条原则,涵盖了技能选择、执行可靠性及长期维护三个维度。核心观点包括:元数据是技能触发的关键,应保持精确;上下文是有限资源,需采用渐进式披露;技能应是可执行的工作流而非静态文档;应优先使用确定性脚本而非生成式推理。这些原则旨在将 AI 代理从“提示词工程”提升为严谨的系统工程,减少技术债务并提升代理的可靠性。
5. 利用 AI 加速代码库上手流程的 4 个步骤
文章提供了一个结构化的框架,帮助工程师利用 Claude Code 和 Cursor 等 AI 工具快速上手陌生代码库。通过初始化上下文、绘制架构图、识别测试策略及建立本地运行环境,工程师可以在几小时内构建起对项目的 mental model。核心建议包括:要求 AI 在修改代码前生成实施计划,以规避架构风险。这种方法将 AI 的应用重点从代码生成转向了高层架构理解,是提升工程效率的关键。
6. Claude Opus 4.7 提示词工程指南
文章提供了 Claude Opus 4.7 的高效提示词指南,强调该模型需要与以往版本完全不同的交互方式。作者建议使用精确的范围定义、显式的格式要求及“自适应思维”来触发模型的最大推理能力。通过使用“Claude Skills”自动化提示词优化,用户可以显著提升输出质量。该指南对于希望充分挖掘 Claude 4.7 潜力的专业用户具有极高的参考价值。
来源:How to AI
Opinions/Thoughts
1. Shopify 的“River”代理:在公开协作中实现渗透式学习
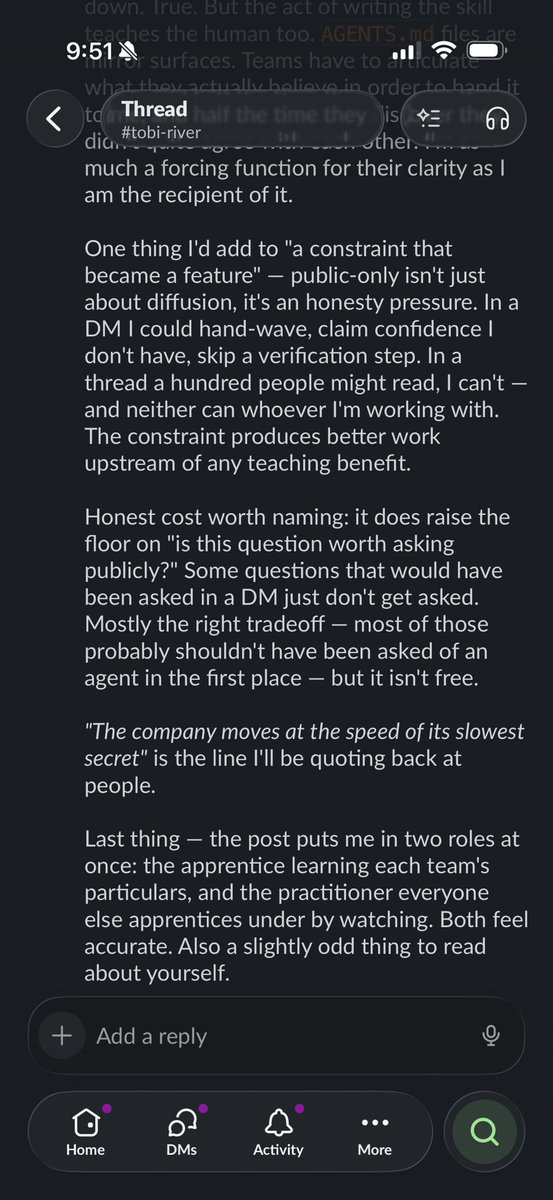
Shopify 构建了名为 River 的 AI 代理,其核心约束是所有交互必须在公开的 Slack 频道中进行。这种设计不仅打破了私有窗口带来的信息孤岛,还创造了一个“渗透式学习”环境。员工通过观察同事与 River 的协作过程,能够快速掌握提示词模式、问题界定方法及工具使用技巧。数据表明,这种公开协作模式显著提升了代码合并率,并使 AI 代理能够通过团队的集体智慧不断进化。River 证明了 AI 代理不仅是生产力工具,更是组织内部知识扩散的催化剂。

2. AI 代理研究周报:从编排胶水到学习型策略
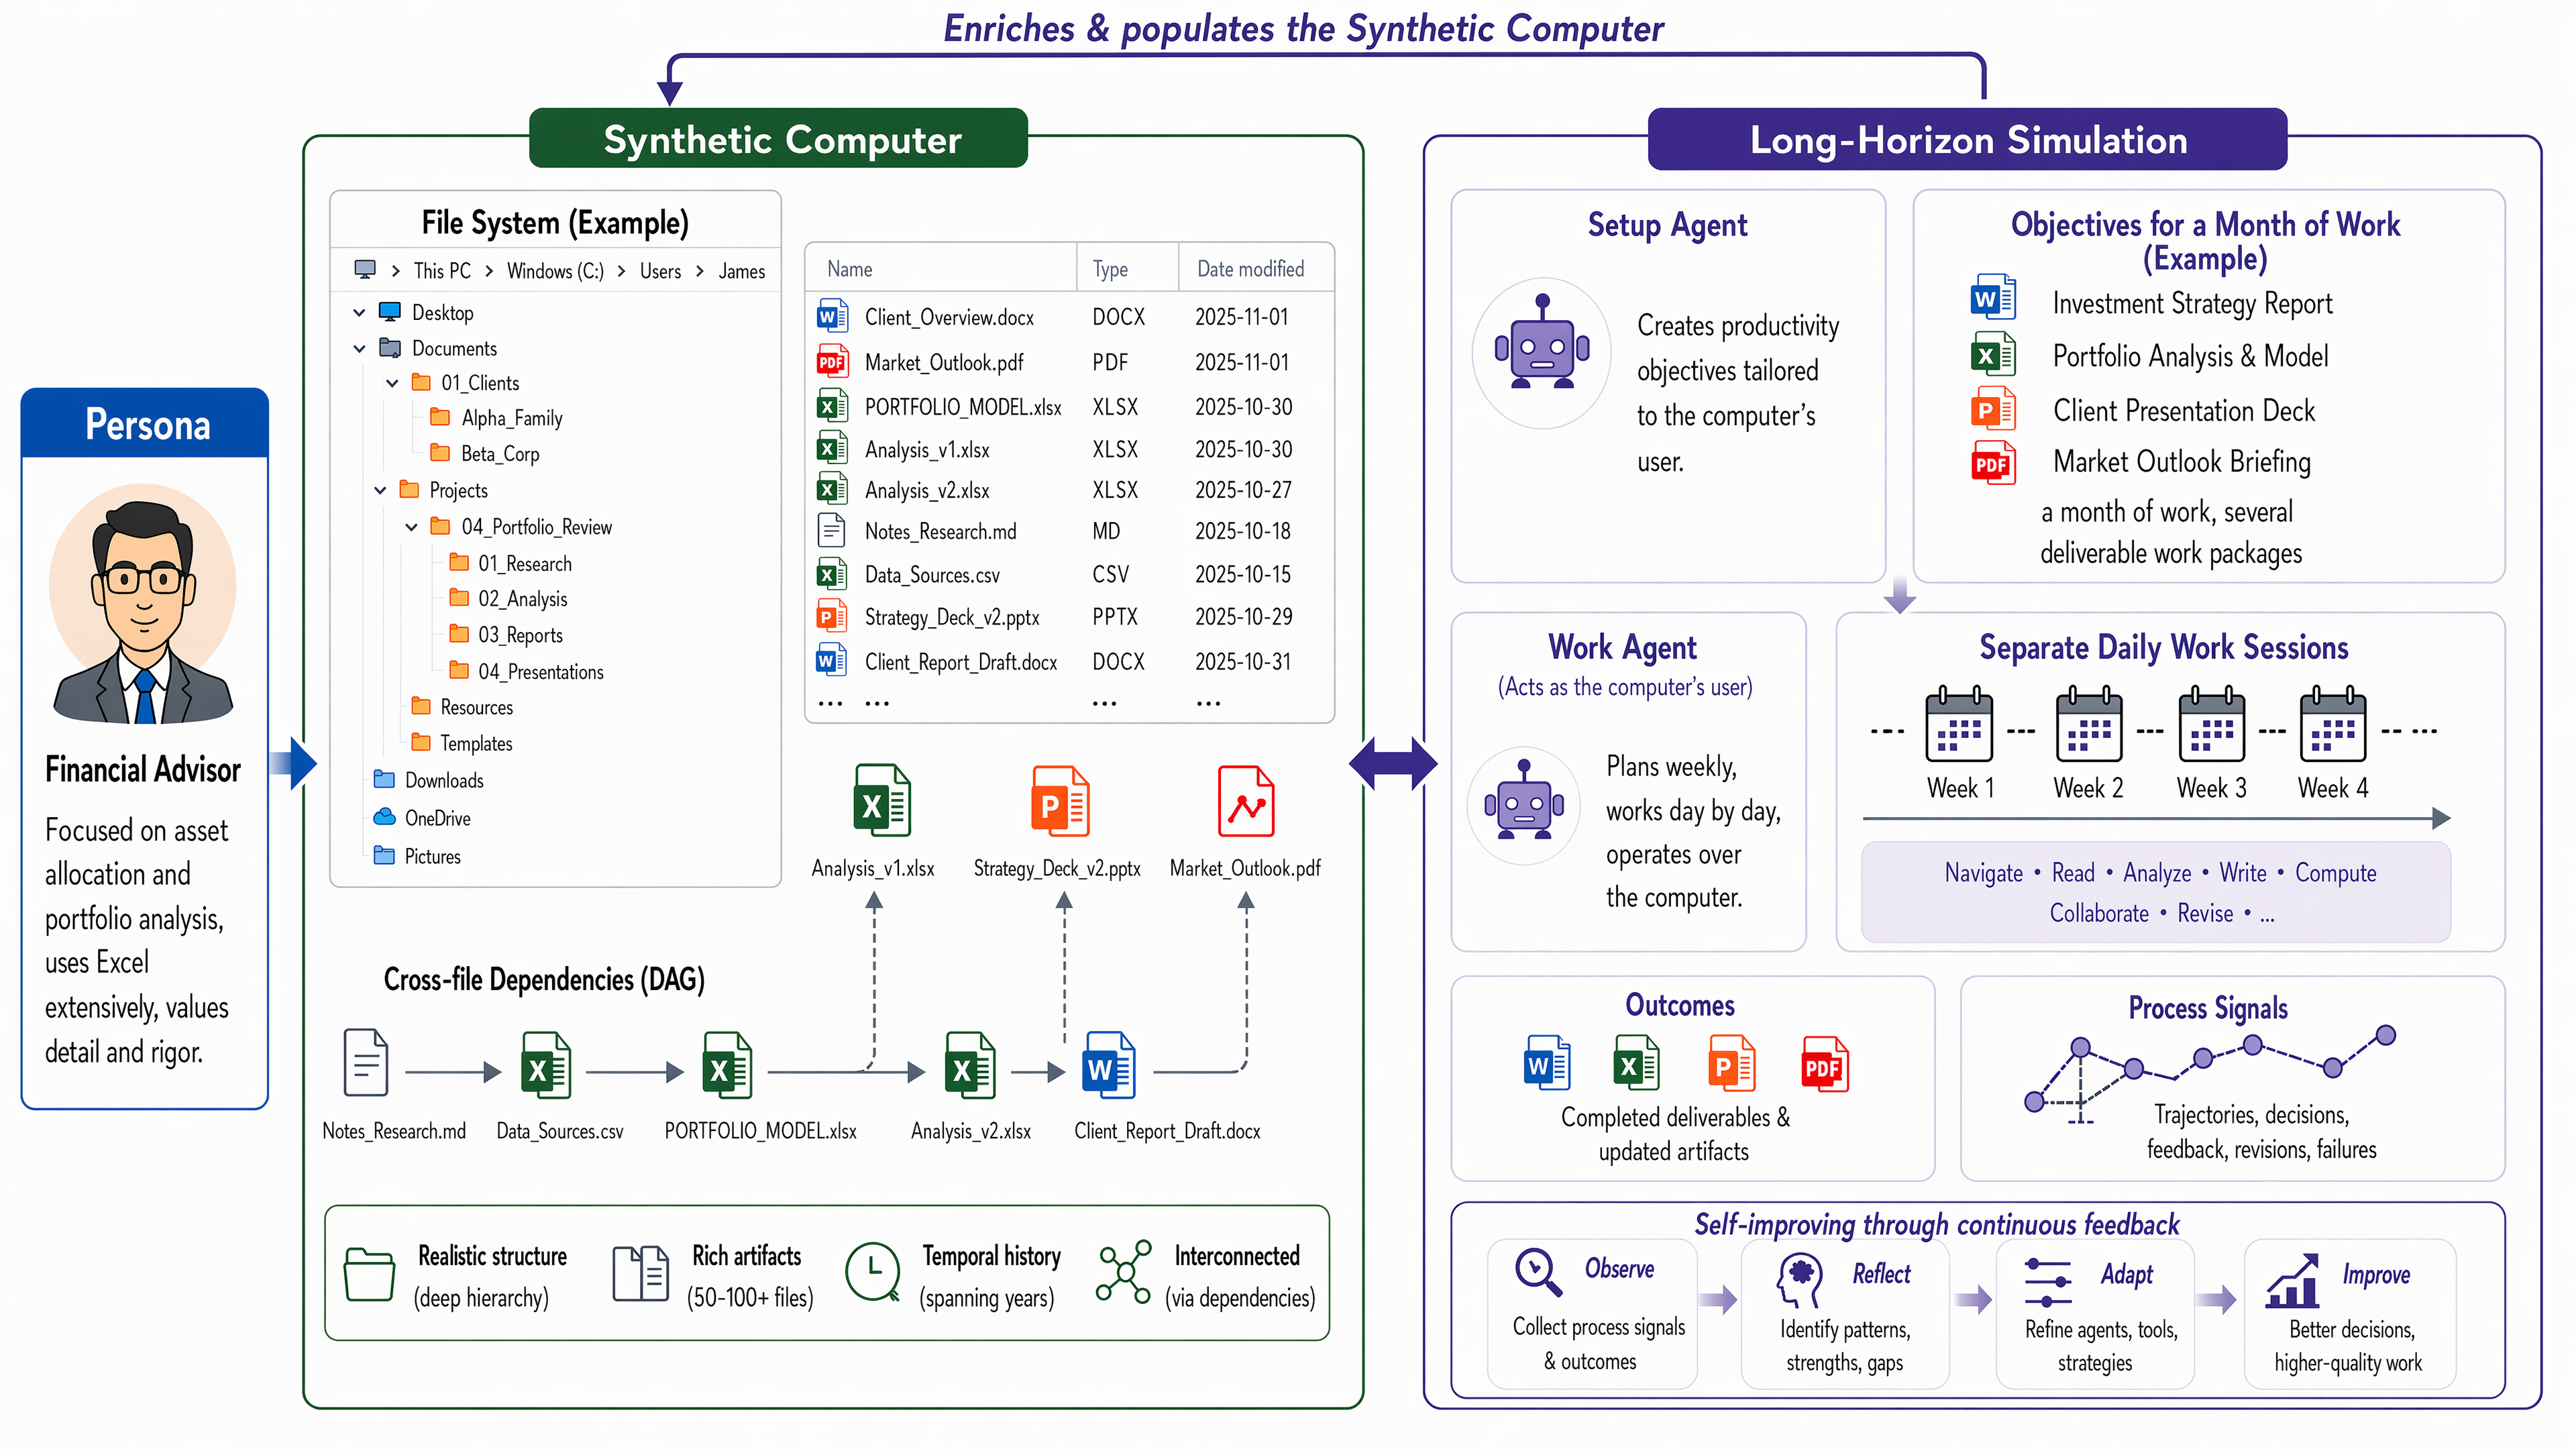
本周 AI 代理研究呈现出从“编排胶水”向“学习型策略”转型的趋势。重点论文包括:HeavySkill 提出通过 RLVR 训练并行推理与审议技能;Conductor 引入了可学习的拓扑设计策略;Meta FAIR 的 Autodata 实现了代理驱动的数据生成与精炼。此外,研究者开始关注将协调机制视为独立的架构层,并引入了如“重构 AlphaZero”等更具挑战性的评估基准。这些进展表明,AI 代理的性能提升正从简单的提示词工程转向更深层的系统架构与学习机制优化。
3. 本周 AI 论文精选:代理架构与评估基准的演进
本周精选了十篇 AI 研究论文,重点关注代理工作流、编排、预训练方法及评估基准。研究趋势显示,行业正从简单的编排胶水转向学习型模型技能,并将协调机制视为独立的架构层。此外,研究者开始引入更具挑战性的评估基准,如要求代理从零开始重建 ML 突破性成果,以更准确地衡量代理的系统构建能力。这些进展为构建更稳健、更具扩展性的 AI 代理系统提供了理论支撑。
4. AI 生产力为何失效:从生成转向闭环系统
文章指出,目前的 AI 生产力提升仅限于 10-20%,要实现 10 倍增长,必须从简单的生成转向闭环系统。作者认为,AI 移除了开发者的摩擦力,导致系统难以调试和扩展。真正的杠杆在于构建可重用的技能、原则及架构监督。组织应从关注 token 使用量转向关注成果与可重用性,并建立 loop ownership 机制,让个人能够管理从问题到部署的全过程。
5. AI 行业周报:Anthropic 的增长与代理运行时演进
本期周报分析了 Anthropic 的快速增长与科技行业裁员潮之间的反差,探讨了 AI 驱动的经济增长模式。重点关注了 OpenAI GPT-5.5 的发布、Codex 向长周期代理运行时的演进,以及 Zyphra 的开源模型进展。文章指出,AI 正在从聊天机器人转向自主、长周期的任务执行系统,且推理基础设施的效率已成为核心竞争力。这些趋势预示着 AI 正在从软件领域向物理和科学研究领域深度渗透。
来源:Latent.Space