
Product
1. Anthropic 发布 Claude Code Auto Mode,引入分类器自动审批
Anthropic 针对 Claude Code 推出 Auto Mode,旨在解决用户在频繁审批中的“审批疲劳”问题。该模式通过内置分类器对操作进行风险评估,而非完全依赖手动确认或完全跳过权限。官方数据显示,用户此前手动接受了 93% 的请求,Auto Mode 试图在安全性与操作效率之间找到平衡。该系统通过两阶段分类器处理,第一阶段进行快速判断,第二阶段针对可疑操作启动 CoT 推理。尽管该模式显著降低了维护成本,但 Anthropic 明确指出其在安全性上仍无法完全替代人工审核,目前主要服务于追求高自主性且对风险有一定容忍度的开发者。
来源:Claude Code auto mode: a safer way to skip permissions
2. MemCollab 研究:解决多模型 Agent 协作中的记忆孤岛问题
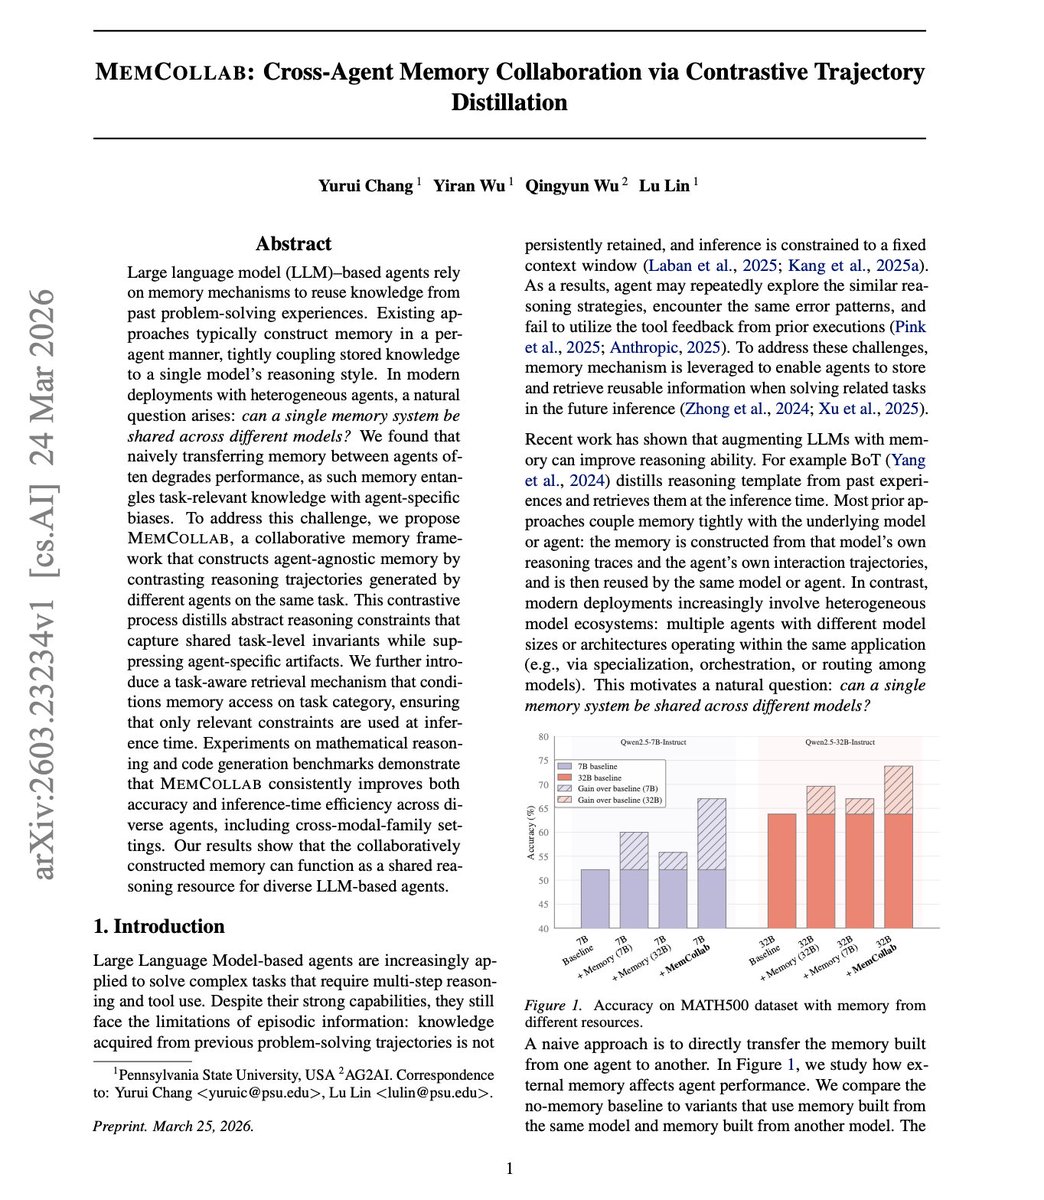
针对 AI Agent 在任务中产生的记忆难以跨模型共享的问题,MemCollab 提出了一种新的解决方案。研究指出,直接迁移记忆往往导致性能下降,因此该系统利用对比轨迹蒸馏技术,将通用任务知识与特定 Agent 的偏好分离开来。通过对比不同 Agent 的推理轨迹,系统能够提取出抽象的推理约束,将其转化为共享的推理资源。这种方法在数学推理和代码生成任务中显著提升了准确率和效率,为构建异构 Agent 团队提供了可行的记忆共享架构。
来源:@dair_ai
3. /investigate 指令,自动化深度调查工作流
Idiom 开发了一款名为
/investigate的 Claude Code 指令,旨在自动化处理复杂的政府合同、游说关系及企业背景调查。该工具通过并行启动三个研究 Agent,分别负责核心事实、游说注册信息及冲突/媒体报道的抓取,最终生成交互式 HTML 仪表盘和结构化的 CONTEXT.md 文档。这一工具将原本耗时数小时的 OSINT(开源情报)工作缩短至分钟级,展示了 Agent 在特定垂直领域进行复杂信息整合的强大潜力。
来源:@idiom_bytes
4. Stripe 工程师揭秘:如何通过 Slack 驱动 1300 个 AI PR
Stripe 工程师 Steve Kaliski 在播客中分享了内部“Minions”系统的运作机制。该系统允许工程师通过 Slack 交互触发 AI Agent,每周自动提交超过 1300 个 Pull Request。其核心架构依赖于云端开发环境,支持并行、多线程的 AI 工程任务,并集成了“Goose”Agent 框架进行任务编排。此外,该系统还实现了机器对机器的支付功能,使 Agent 能够自主完成财务交易。这一案例表明,优化开发者体验(DevX)是提升 AI Agent 生产力的关键。
来源:@clairevo
5. Claude Code 2.1.84 更新:引入 Windows 支持与优化
Claude Code 发布 2.1.84 版本,带来多项重大更新。最显著的变化是增加了对 Windows PowerShell 的支持,允许在 Windows 环境下进行自动化操作。此外,系统优化了空闲处理逻辑,对空闲超过 75 分钟的会话进行自动清理,以减少不必要的 Token 缓存。在系统提示词层面,移除了“避免过度工程”的顶层约束,转而采用更具体的工程实践指导。此次更新还清理了多个实验性功能门控,进一步精简了 CLI 交互界面,提升了整体运行效率。
6. Expect CLI:让 Agent 在真实浏览器中进行自动化 QA
Expect 是一款开源的 CLI 工具,旨在让 AI Agent 在真实浏览器环境中对代码进行质量保证(QA)测试。开发者可以通过 Claude Code 或 Codex 运行该工具,Agent 会自动执行测试、录制 Bug 发现过程的视频,并进行修复迭代。Expect 的核心价值在于将“测试-反馈-修复”的闭环完全自动化,减少了人工介入的必要性。该工具支持作为 CLI 或 Agent 技能运行,为前端开发提供了高效的自动化测试方案。
来源:@aidenybai
7. Google TurboQuant 论文解析:KV Cache 无损压缩至 3-bit
Google 发布 TurboQuant 论文,提出了一种将 KV Cache 无损压缩至 3-bit 的新技术。该技术结合了 PolarQuant 和 QJL 算法,在不显著损失模型性能的前提下,将显存占用和数据搬运量降低至原来的 1/4 到 1/5。由于大模型推理速度主要受限于显存带宽,TurboQuant 通过减少数据搬运时间,实现了推理速度的成倍提升。这一突破对于在有限显存资源下运行长上下文模型具有重要意义,是当前大模型推理优化领域的前沿进展。

来源:@karminski3
8. Cursor Cloud Agents 支持私有化部署
Cursor 宣布其 Cloud Agents 现在支持在用户自己的基础设施上运行。这意味着企业可以在保持代码和工具执行完全在内部网络的前提下,获得与 Cursor 云端 Agent 相同的 harness 和体验。这一举措旨在解决企业对数据隐私和安全性的顾虑,允许团队在受控环境中利用 AI Agent 的自动化能力。对于高度关注合规性的金融、医疗等行业,这一功能极大地降低了采用 AI 辅助编程的门槛。
来源:@cursor_ai
9. Google Gemini 推出 Lyria 3 Pro,支持 3 分钟长音频生成
Google Gemini 宣布推出 Lyria 3 Pro 模型,支持生成长达 3 分钟的完整歌曲,包括前奏、主歌和副歌。该模型增强了定制化能力,允许用户在 Gemini 中添加更多细节以实现复杂的音乐创作愿景。此外,所有生成的音频均带有 SynthID 水印,Google 同时提供了检测工具以识别 AI 生成内容。这一更新标志着 AI 音乐生成从短片段向完整结构化作品的跨越,进一步提升了创作工具的实用性。
来源:@GeminiApp
10. Anthropic 发布官方 iMessage 插件,实现 Claude Code 双向交互
Anthropic 发布了官方 Claude Code iMessage 插件,允许用户通过 iMessage 与 Claude Code 助手进行交互。该插件直接读取本地
chat.db文件以获取历史记录,并利用 AppleScript 发送消息。它支持文字和图片双向通信,用户可以在手机上远程指挥 Claude 查阅文件、修改代码或读取图片。出于安全考虑,默认仅响应用户本人,其他联系人需手动授权。这一设计为开发者提供了极具灵活性的远程 Agent 控制方案。
来源:GitHub
Tutorial
1. Claude Skills 构建心法:如何打造高质量的 Agent 资产
构建高质量 Claude Skills 的关键在于上下文的厚度和迭代逻辑。建议采用“反向提问”策略,让 Claude 引导用户明确需求;通过“疯狂喂上下文”确保模型拥有充足的背景信息;并始终保持至少三版的迭代。一个好的输出范例往往胜过十条规则。此外,在 Skill 中加入自检清单,让 Claude 在输出前进行自我审查,是提升质量的有效手段。Skill 应被视为“一次投入、持续复利”的资产,而非一次性指令。大多数 Skill 不好用,往往是因为上下文不足或缺乏范例。
2. 本地模型工具调用能力评测:小模型幻觉与大模型信任危机
针对本地模型处理工具调用的能力,一项包含 15 个场景、12 个工具的评测显示,模型规模与性能并非简单的线性关系。评测发现,小模型容易产生数据幻觉,而大模型(如 397B)则倾向于忽略工具返回的精确数据,转而使用记忆中的近似值。只有 27B 左右的模型在处理简单逻辑(如搜索后计算)时表现出最佳的信任度与准确性。这一结果表明,在 Agent 开发中,盲目追求参数规模可能适得其反,选择适合特定任务规模的模型至关重要。
来源:@stevibe
Opinions/Thoughts
1. ARC-AGI-3 评测:大模型与人类智能的巨大鸿沟
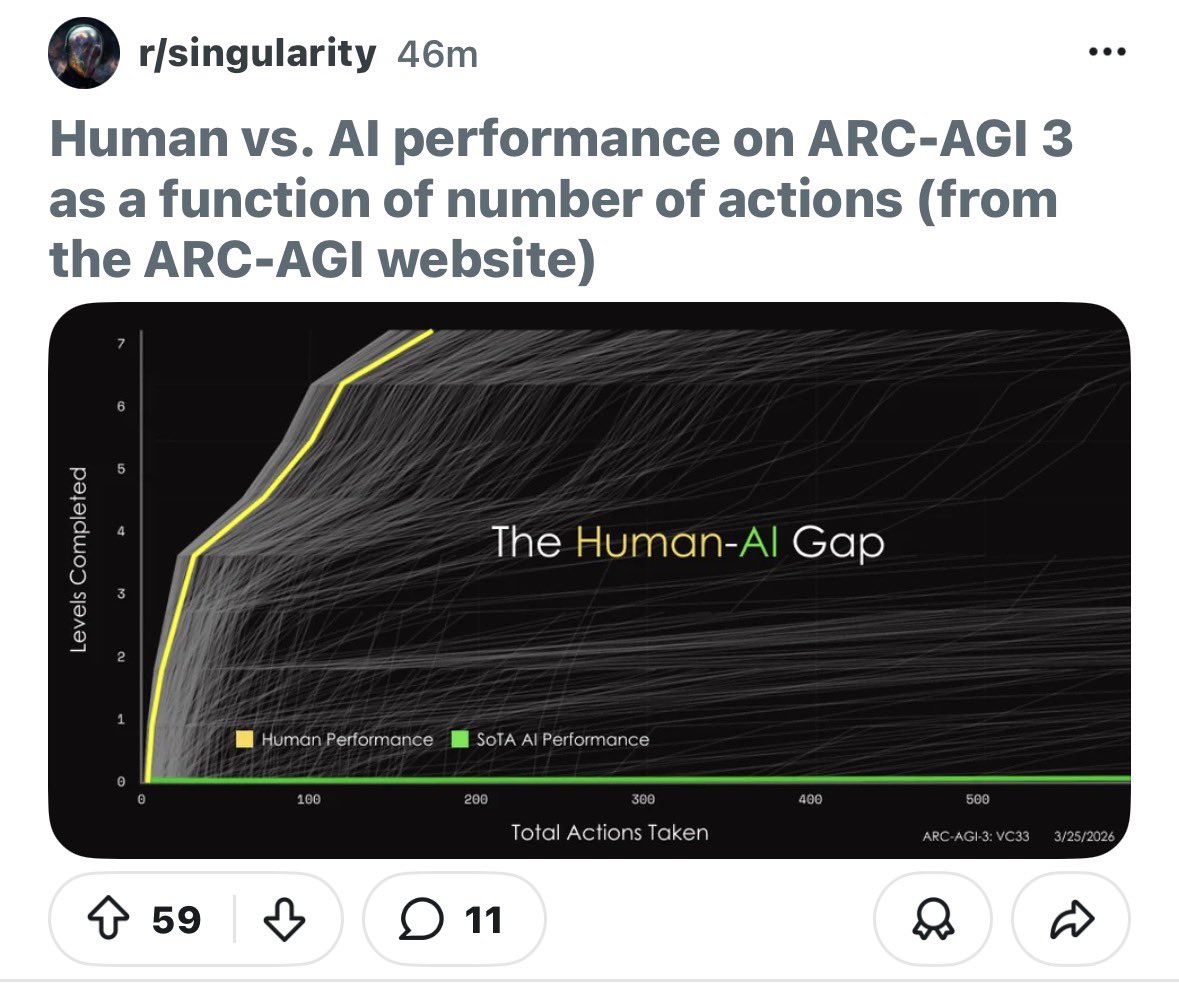
ARC-AGI-3 基准测试显示,当前前沿大模型在处理该任务时的表现依然远低于人类水平,得分普遍在 1% 以下。这一结果揭示了两个真相:一是我们距离通用人工智能(AGI)仍有很长的路要走;二是现有的基准测试正在逐渐饱和,且往往无法真实反映模型的推理能力。专家指出,当前的安全对齐本质上是在做模式匹配,而非真正的意图理解。这一鸿沟提醒开发者,不要盲目信任现有的 AI 性能指标,真正的智能仍需在更具挑战性的任务中验证。
来源:@Hesamation
2. Latent.Space:AI 时代的“反垃圾”战争与基础设施重构
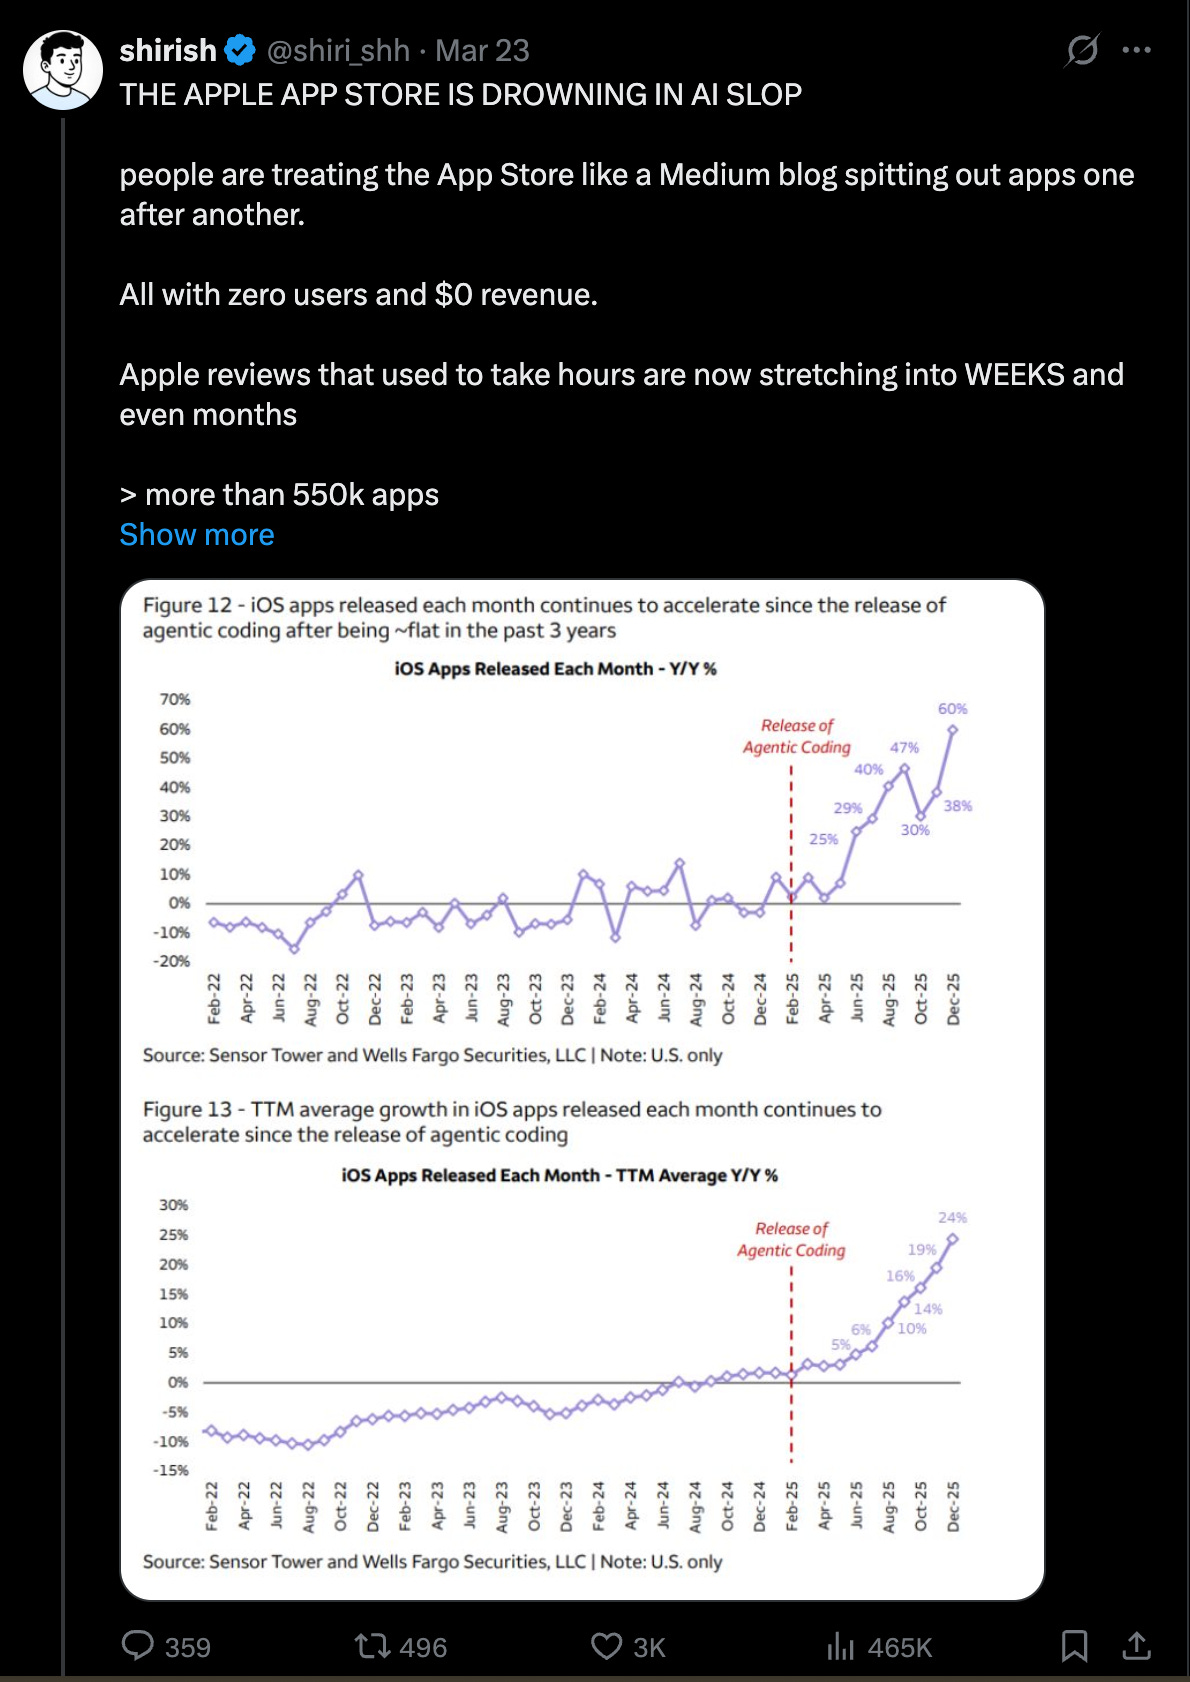
Latent.Space 的最新分析指出,AI 行业正处于从“Demo 阶段”向“Agent 基础设施阶段”转型的关键期。随着 Agent 深入文件系统、浏览器和 API,传统的应用商店分发模式正面临挑战。行业焦点已从简单的 Chat Wrapper 转向复杂的 Agent 编排与权限管理。同时,LiteLLM 的供应链安全事件凸显了 AI 软件依赖的脆弱性。OpenAI 重新聚焦核心模型与基础设施,砍掉 Sora 等边缘项目,反映了行业对资源配置的重新审视。这一阶段的特征是追求最小化、可审计的依赖,以应对 Agent 带来的安全风险。
来源:Latent.Space
3. 深度解析:Claude Code Auto Mode 的安全设计逻辑
Claude Code 的 Auto Mode 并非简单的自动化,而是一套精密的权限治理系统。其核心在于将审批权从用户转移至模型分类器,通过两层架构实现安全防护:输入层扫描提示注入,输出层进行两阶段分类。最关键的设计是“推理盲区”原则,分类器故意不看 Agent 的推理过程,以防止 Agent 说服分类器放行危险操作。尽管存在 17% 的漏报率,但对于本来就无脑点击“同意”的用户而言,这依然是巨大的安全提升。该设计展示了在 Agent 时代,安全治理必须从“人”转向“系统”。
4. 文言文越狱:大模型安全护栏的模式匹配软肋
研究发现,大模型的安全护栏对文言文越狱攻击几乎完全失效。这是因为当前的安全对齐机制主要基于现代语言训练,本质上是在做“模式匹配”而非“意图理解”。文言文因其言简意深、比喻密集的特性,天然适合隐藏危险意图。论文提出的 CC-BOS 框架利用果蝇觅食算法在策略空间搜索,在六个主流大模型上实现了 100% 的攻击成功率。这一发现深刻揭示了当前 AI 安全对齐的局限性:护栏保护的是“表达方式”,而非“含义本身”。

来源:@lijigang
5. 记忆的复杂性:Agent 记忆系统的设计挑战
记忆系统是 Agent 设计中的核心难点。挑战不仅在于“记住什么”或“忘记什么”,更在于“如何记住”以及“何时需要更努力地记住”。有效的记忆系统需要具备动态调整能力,能够根据任务需求自动优化记忆存储与检索策略。这一观点强调了 Agent 记忆系统不应是静态的数据库,而应是具备主动学习与遗忘机制的智能组件,是构建长期记忆 Agent 的关键。