
Product
1. Dreamer 平台发布:构建个人 Agent 操作系统
由前 Stripe CTO David Singleton 和 Hugo Barra 创立的 Dreamer 正式走出隐身模式,定位为面向消费者的“Agent 操作系统”。该平台不仅提供 Sidekick 个人助理以辅助用户通过自然语言构建应用,还为开发者提供包含 SDK、数据库和托管服务的全栈环境。Dreamer 试图解决当前 Agent 开发中碎片化的问题,通过“Agent OS”内核管理权限与交互,确保安全性。其生态系统策略包括“Builders in Residence”计划和高额奖金,旨在吸引开发者构建可货币化的工具。这一举措标志着 AI 应用从简单的 LLM 封装向具备持久状态、内存和全栈基础设施的 Agent 平台转型。
来源:Latent.Space
2. Cursor Composer 2 基座模型争议与透明度反思
Cursor 近期发布的 Composer 2 被开发者扒出底层基座为月之暗面(Moonshot AI)的 Kimi K2.5 模型。尽管 Cursor 随后承认通过推理合作伙伴 Fireworks AI 获得了合法授权,但因未在发布中明确标注模型来源,引发了关于 AI 产品透明度与开源协议合规性的广泛讨论。月之暗面官方确认了授权关系,将此定性为“沟通事故”。此事件揭示了当前 AI 行业在快速迭代中,产品包装与开源模型来源披露之间的张力,同时也凸显了顶级开源模型在商业化应用中的竞争力与合规挑战。
3. OpenAI 收购 Astral:开发者工具的战略整合
OpenAI 正式收购了 Python 生态中关键工具(如 uv、ruff、ty)的开发团队 Astral。此举被视为 AI 实验室争夺软件工程栈控制权的战略动作,旨在通过整合底层开发基础设施来巩固其在编码 Agent 领域的护城河。此前 Anthropic 收购 Bun 运行时也体现了相似的逻辑。尽管 OpenAI 承诺继续支持这些开源工具,但社区对于核心基础设施被大厂垄断后的独立性与维护前景表示担忧。这一收购进一步印证了编码 Agent 已从“辅助工具”演变为 AI 竞争的核心战场。
来源:Simon Willison’s Newsletter
4. Claude Code 2.1.81 更新:CLI 与系统提示词优化
Claude Code 发布 2.1.81 版本,重点优化了 CLI 交互与系统提示词策略。新增
--bare标志以跳过钩子、LSP 和插件同步,实现更快的确定性自动化。在内存管理方面,Claude 现在更严格地遵循“无内存”请求,并优化了 Read 工具的使用逻辑,优先读取已知文件片段而非全量读取,从而提升响应速度与相关性。这些更新显示出 Claude Code 在生产环境部署中对性能、隐私控制和上下文精准度的持续打磨。
5. OpenSWE:大规模 Python SWE Agent 训练框架
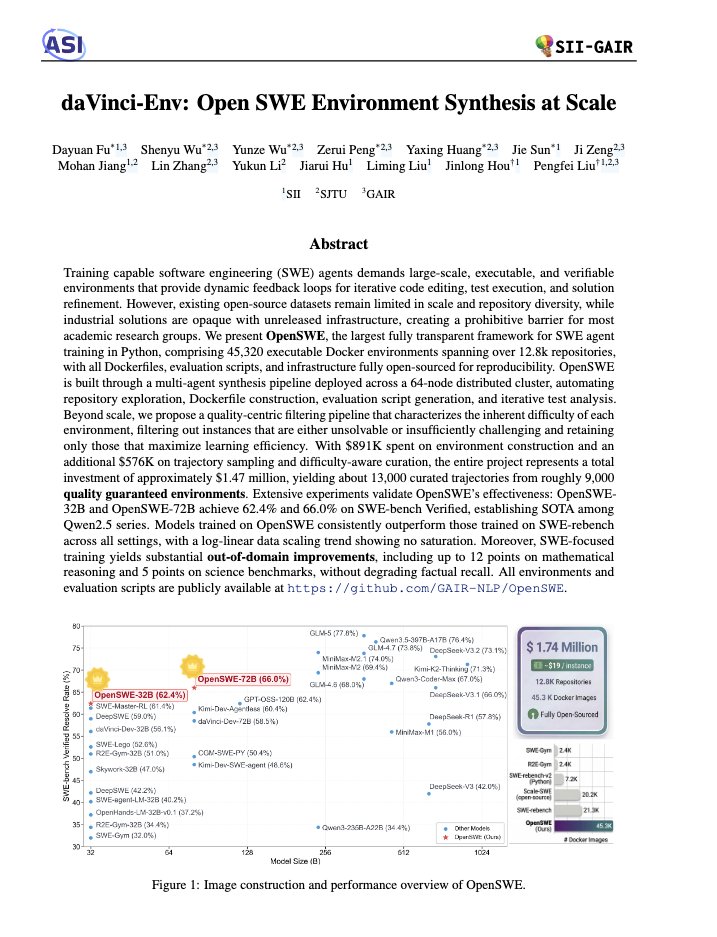
OpenSWE 是 daVinci 系列的最新成果,旨在提供迄今为止最大的完全透明的 Python 软件工程(SWE)Agent 训练框架。该框架包含 45,320 个可执行的 Docker 环境,覆盖超过 12.8 万个代码库,且所有 Dockerfile、评估脚本和基础设施均完全开源。OpenSWE 的推出为 Agent 的基准测试与训练提供了标准化的基础设施,有助于解决当前 Agent 评估中环境不一致和数据不透明的问题,推动 SWE Agent 的标准化发展。
来源:@dongxi_nlp
6. ClawRouter:基于请求的智能路由与成本优化
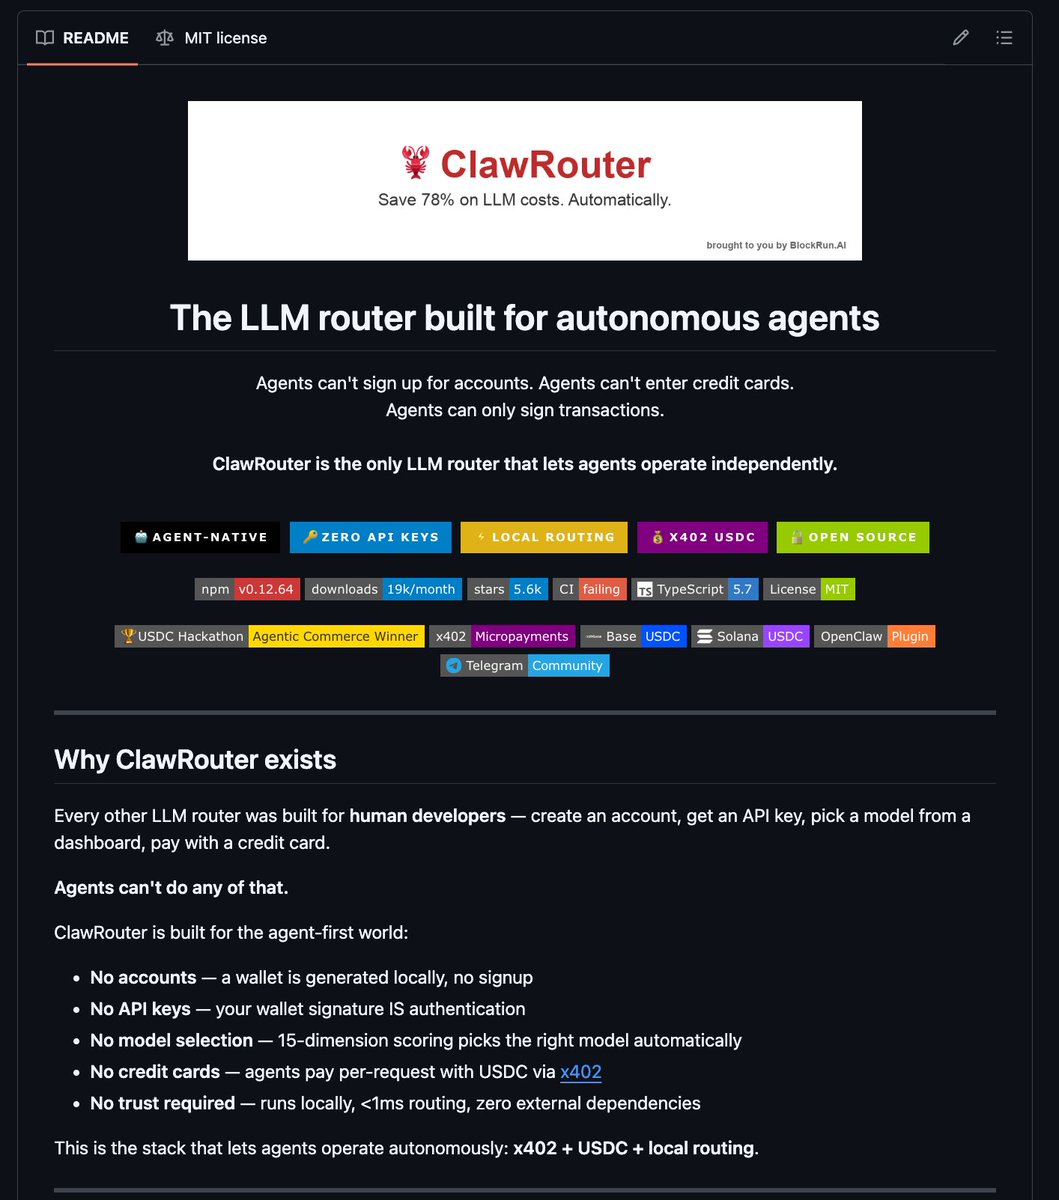
ClawRouter 是一款开源的 AI 请求路由工具,旨在通过自动路由请求至最经济且能胜任的模型来降低成本。该工具在 1 毫秒内对请求进行 14 个维度的评分,根据任务复杂度(如简单查询、复杂编码、数学推理)自动匹配 OpenAI、Anthropic、Google、DeepSeek 等模型。ClawRouter 采用本地运行模式,无需 API 密钥或订阅,支持 USDC 支付,为用户提供了一种无需绑定单一供应商的成本控制方案。
来源:@hasantoxr
7. Pi 遥测数据收集实验:平衡隐私与性能优化
Pi 的开发者 Mario Zechner 提议引入一项可选的遥测功能,旨在收集 Agent 在编辑代码时的工具调用数据,以优化编辑工具的性能。该方案强调完全手动、 opt-in 的原则,且明确不收集 PII(个人身份信息)或实际代码内容,仅聚合模型调用成功率与失败模式。此举旨在解决 Pi 在缺乏大规模用户反馈数据情况下的“盲飞”问题,并希望通过公开聚合数据,为整个编码 Agent 社区提供可参考的性能基准,对抗闭源生态的垄断。
8. Memory Sparse Attention (MSA):解决 Agent 长期记忆问题
针对当前 Agent 普遍存在的“不记事”短板,MSA(Memory Sparse Attention)论文提出了一种将记忆直接嵌入注意力机制的方案。该方法采用端到端训练,具备线性复杂度,在 4B 模型规模下表现优于 235B 级别的 RAG 系统。MSA 允许模型在推理时按需多轮采纳记忆内容,而非依赖 KV cache 或系统提示词。这一研究为 Agent 从“工具”向“同事”的演进提供了关键的技术路径,解决了长期记忆与计算效率之间的矛盾。
来源:@yanhua1010
9. Claude Code 自动化任务调度
Claude Code 新增了云端定时任务调度功能。用户可以指定代码库、执行频率和提示词,Claude Code 将通过云端基础设施在预定时间自动运行任务,无需本地机器保持运行。这一功能将 Claude Code 的应用场景从交互式开发扩展到了后台自动化运维,如定期代码审查、自动化测试或数据同步。这种从“按需触发”到“定时执行”的转变,进一步增强了 Agent 在生产环境中的实用性。
来源:@noahzweben
10. Factory Enterprise:企业级 Agent 策略管理
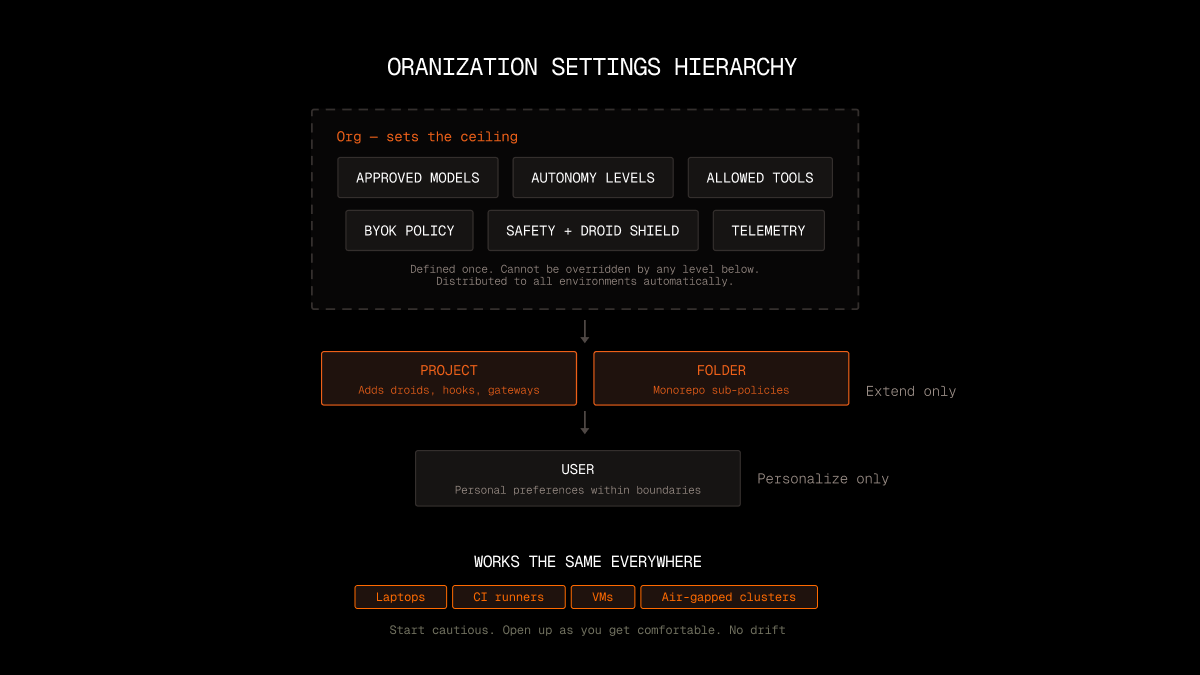
Factory Enterprise 平台为企业提供了统一的设置层级,允许管理员定义一次策略并自动分发至所有运行的 Droids(Agent)。该平台解决了企业在部署大规模 Agent 时面临的配置一致性与合规性问题。通过集中化的策略管理,企业能够确保所有 Agent 在执行任务时遵循相同的安全与操作规范。这是 Agent 平台向企业级市场迈进的重要基础设施,强调了可控性与可扩展性。
来源:@FactoryAI
11. Pi 编码 Agent 默认集成
Pi 平台宣布将编码 Agent 纳入默认功能,并与订阅中包含的 LLM 网关直接挂钩。这一举措降低了用户使用 Agent 的门槛,将编码能力作为平台的基础设施而非可选插件。通过与网关的深度集成,Pi 能够提供更一致的推理体验和更优的成本控制。此举反映了 Agent 平台正在将核心编码能力“原生化”,以提升用户留存与产品粘性。

12. Claude Code DOM 元素直接选择功能
Claude Code 桌面版新增了直接选择 DOM 元素的功能,用户无需详细描述组件,Claude 即可获取标签、类名、关键样式、周围 HTML 及截图。对于 React 应用,Claude 还能自动获取源文件、组件名称和 Props。这一功能极大地简化了前端开发中的交互流程,使 Agent 能够更精准地理解 UI 结构并进行修改。这种视觉与代码上下文的深度结合,是提升编码 Agent 在前端开发中效率的关键。
来源:@lydiahallie
13. Nvidia Nemotron-Cascade-2 开源发布
英伟达开源了 Nemotron-Cascade-2 模型,总参数 30B,激活参数 3B。该模型在国际数学奥林匹克竞赛、智力竞赛及计算机竞赛中表现优异,展现了小参数模型在复杂推理任务上的潜力。尽管在某些通用能力上弱于 Qwen3.5-35B-A3B,但在特定竞赛任务中表现出极高的效率。该模型的发布为开发者提供了高性能、低资源消耗的推理选择,进一步推动了小参数模型在专业领域的应用。

来源:@Gorden_Sun
14. Pi 技能搜索功能上线
Pi 平台上线了技能搜索功能,用户现在可以直接在技能标签页中搜索并安装来自社区的技能。这一更新增强了 Pi 的可扩展性,使用户能够更方便地发现和集成各种功能插件。通过社区驱动的技能生态,Pi 正在构建一个类似于应用商店的 Agent 扩展体系,降低了用户定制化 Agent 的难度。该功能是 Pi 平台生态建设的重要一步,旨在通过社区力量丰富 Agent 的能力边界。
15. Pi 自动研究工具:优化代码包大小
开发者分享了使用 pi-autoresearch 优化内部工具包大小的案例,通过 Agent 自动分析与重构,在约 1 小时内将包大小从 414kb 缩减至 55kb(7.5 倍优化)。该案例展示了 Agent 在工程优化任务中的实际效能,不仅限于代码生成,还包括性能调优。通过自动化执行重复性的优化工作,Agent 显著提升了开发者的生产力。这一实践证明了 Agent 在处理具体工程问题时的落地价值。

来源:@davebcn87
16. Pi 技能扩展:子 Agent 委托与上下文分叉
Pi 平台更新了斜杠命令(Prompt 模板),支持将任务直接委托给子 Agent,并可选择从主聊天中分叉上下文。该功能基于此前贡献的事件总线特性,实现了扩展间的直接通信。通过这种模块化设计,Pi 允许用户构建更复杂的 Agent 工作流,将大任务拆解为多个子任务由专门的 Agent 处理。这种架构提升了 Agent 处理复杂逻辑的能力,是构建多 Agent 协作系统的基础。
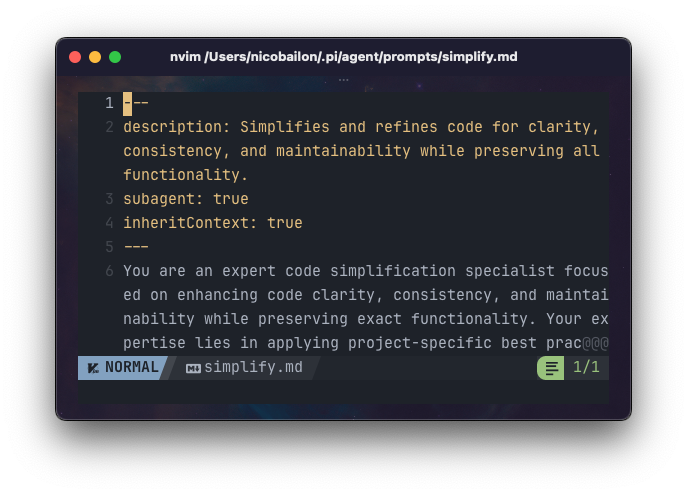
来源:@nicopreme
17. Cowork Projects:任务与上下文的持久化管理
Cowork 平台推出了 Projects 功能,支持在任务间构建持久化内存,并提供共享文件夹与连接设置。该功能解决了 Agent 在处理多任务时上下文丢失的问题,允许用户将相关文件与指令保持在本地,同时在任务间共享上下文。通过这种持久化管理,Cowork 提升了 Agent 处理长期、复杂项目的能力。这一更新反映了 Agent 平台正在从“单次对话”向“长期项目管理”演进,强调了上下文的连续性与一致性。

Tutorial
1. Grok CLI Agent:集成 X 搜索与 Telegram 控制
本教程演示了如何构建一个集成 X 搜索功能并支持 Telegram 远程控制的 Grok CLI Agent。通过将 Grok 的推理能力与外部搜索工具及即时通讯平台结合,用户可以实现远程自动化任务执行。教程详细说明了如何配置 API 接口、设置搜索工具以及实现 Telegram 机器人的控制逻辑。这种集成方案为构建个人自动化助手提供了参考,展示了如何将 AI 模型能力扩展至外部交互平台。
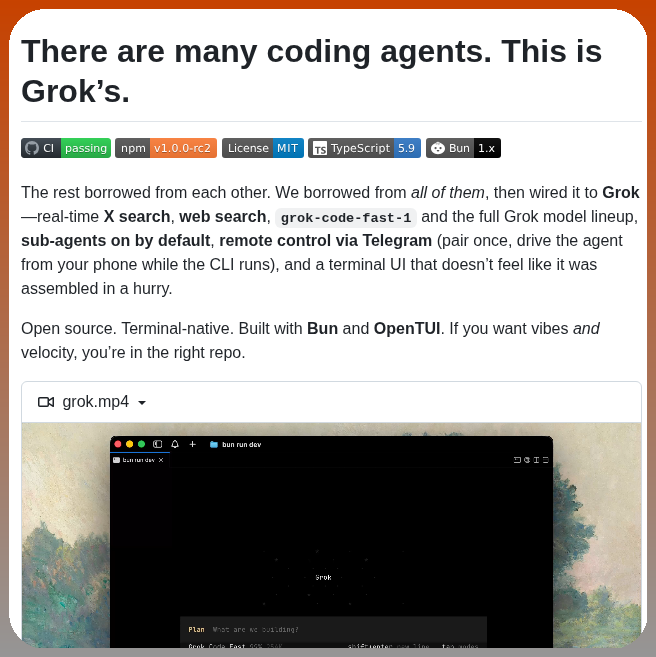
来源:@tom_doerr
2. 生成式游戏开发:AI 驱动的 JSON 渲染引擎
本教程展示了一个基于 AI 生成 JSON 并渲染为游戏的示例。通过 AI 生成游戏逻辑与数据,结合 Rapier 物理引擎实现重力与碰撞检测,并支持模型导入、音效及第一人称控制。该项目演示了“AI → JSON → Render → Game”的完整工作流,证明了生成式 AI 在游戏开发中的潜力。教程详细解析了如何利用 AI 驱动游戏资产生成与逻辑构建,为生成式游戏开发提供了可复现的路径。
来源:@ctatedev
3. Claude Code 资源库精选
本教程汇总了多个高质量的 Claude Code 资源库,涵盖了从超级工具、Awesome 列表到特定领域(如 UI/UX、Obsidian 技能、n8n 集成)的实用资源。这些资源库为开发者提供了丰富的插件、工作流与最佳实践,能够显著提升使用 Claude Code 的效率。教程通过分类整理,帮助用户快速找到适合自己需求的工具与配置,是 Claude Code 用户不可或缺的参考指南。
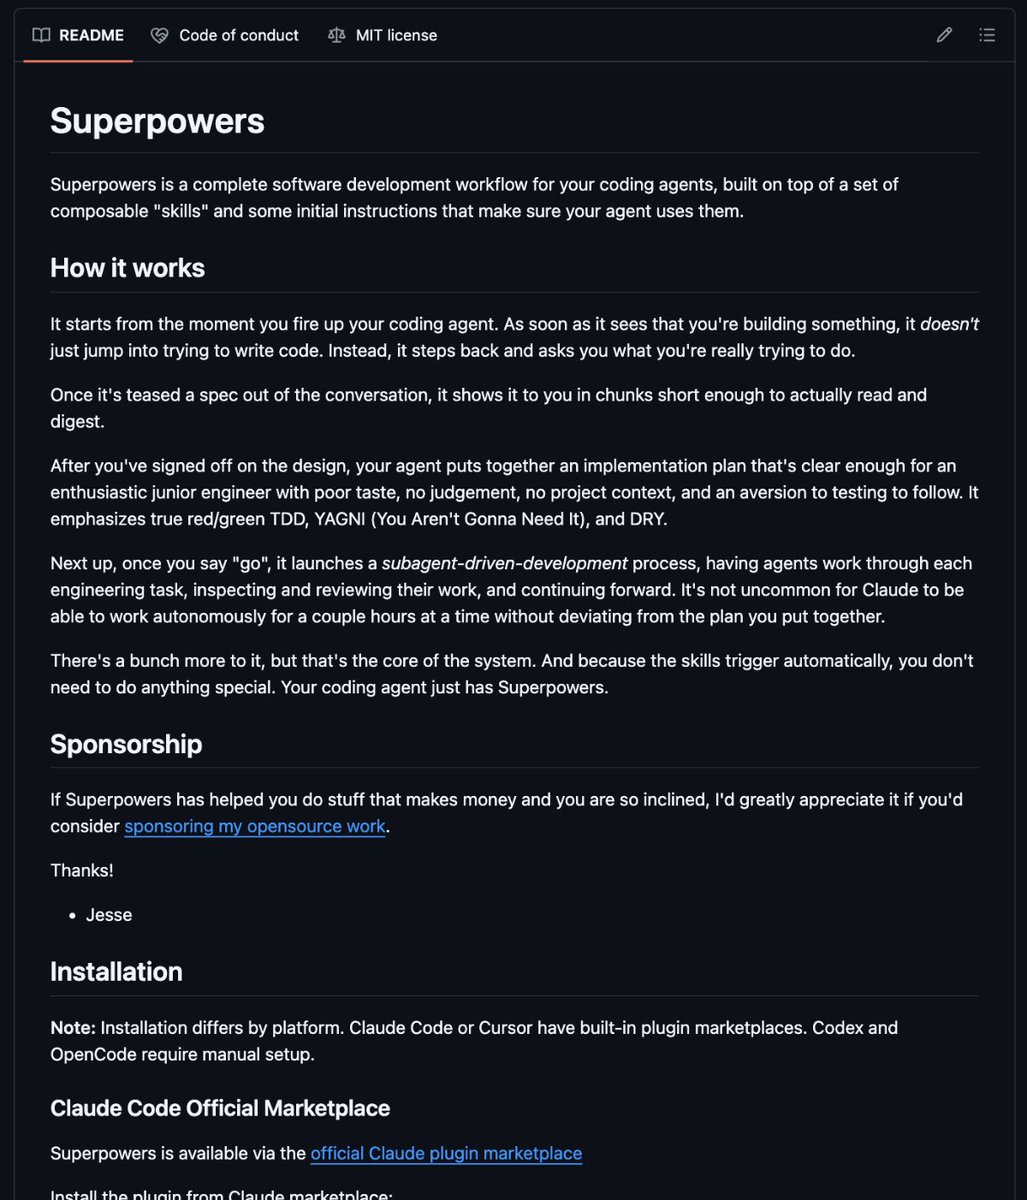
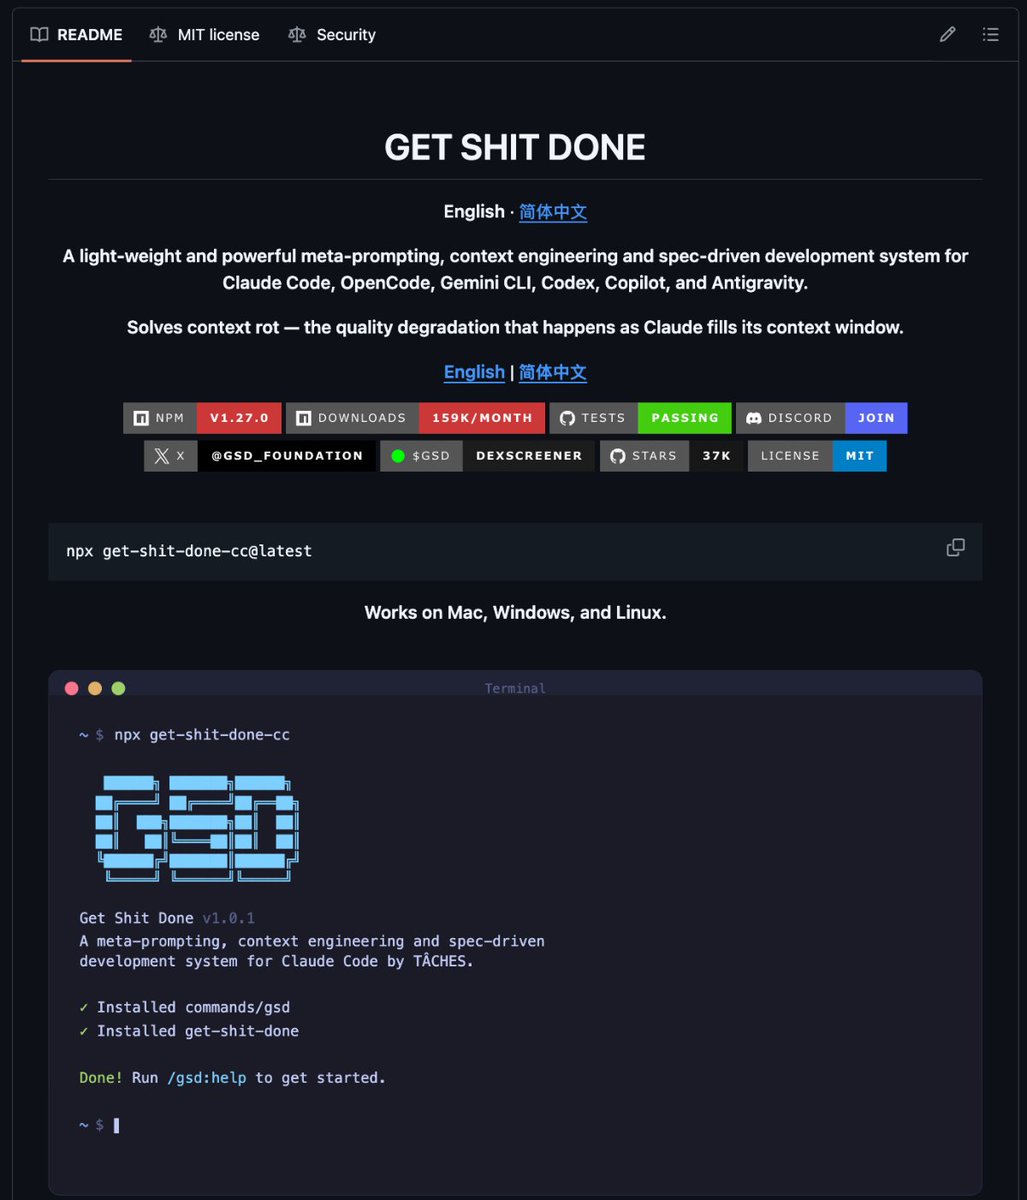
来源:@hasantoxr
4. GStack:利用 AI 优化设计评审
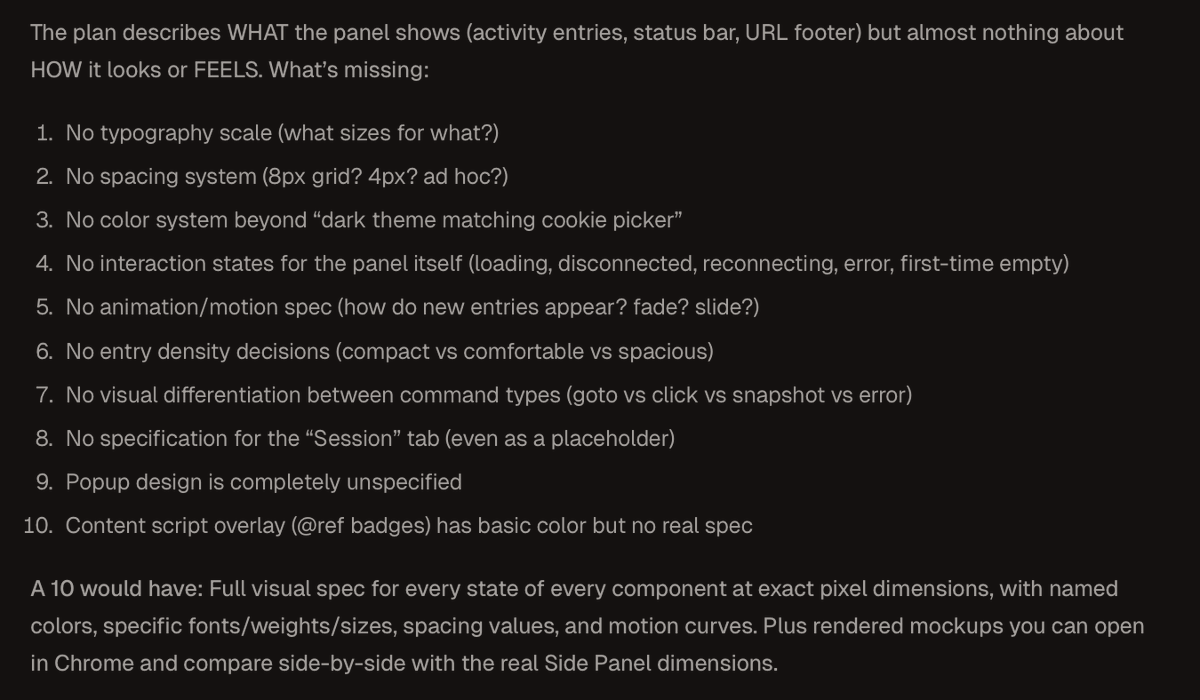
本教程演示了如何利用 GStack 的
/plan-design-review功能将普通设计稿提升至高水平。通过向 LLM 询问评分标准及改进建议,Agent 能够提供具体的优化路径。教程展示了如何将 AI 引入设计评审流程,利用 AI 的分析能力弥补人类在设计细节上的疏漏。这种方法不仅提升了设计质量,还为非专业人士提供了专业级的设计反馈,是 AI 辅助创意工作的典型应用。
来源:@garrytan
5. 费曼学习法与 Agent 对话实践
本教程介绍了如何利用 Agent 实践费曼学习法。通过将 Agent 设置为对话伙伴,用户可以在阅读文章后尝试向 Agent 解释核心概念,Agent 则通过提问与反馈帮助用户查漏补缺。这种交互式学习方式能够显著提升对复杂知识的理解深度。教程详细说明了如何配置 Agent 的角色设定与对话逻辑,为个人知识管理与深度学习提供了高效的实践路径。

Opinions/Thoughts
1. Andrej Karpathy:AI 时代的工程范式转移
Andrej Karpathy 在访谈中深入探讨了 AI 时代的工程范式转移。他分析了编码 Agent 的能力边界、自动研究(AutoResearch)的潜力以及 AI 时代的技能需求。Karpathy 强调了“第二顺序效应”的重要性,即 AI 不仅改变了编码方式,还重塑了协作表面与工作市场。他提出了关于开源与闭源模型、自主机器人以及 Agent 教育的深刻见解,认为 AI 正在将人类从繁琐的执行中解放出来,转向更高层次的策略与设计。
来源:@saranormous
2. Terence Tao:数学发现的本质与 AI 的革命
数学家 Terence Tao 与 Dwarkesh Patel 探讨了科学发现的历史与 AI 在数学领域的革命。Tao 指出,Kepler 的发现并非纯粹的理论洞察,而是基于高质量数据的试错过程。他认为 AI 将科学研究从“人类中心深度”转向“AI 赋能广度”,降低了想法生成的成本,但增加了验证的难度。未来数学研究将是人类与 AI 的混合模式,AI 处理辅助任务与低垂果实,人类专注于概念策略。这一分析为理解 AI 如何重塑科学方法论提供了深刻视角。
3. 科学发现的演进:从哥白尼到 AI 时代
文章通过哥白尼日心说与开普勒椭圆轨道的历史案例,类比了当前 AI 科学研究的范式。指出科学需要“高温度设置”,即在初期阶段容忍看似不准确或复杂的理论,以避免过早陷入局部最优。Terence Tao 的观点强调,如果仅资助最前沿的领域,可能会扼杀那些需要数十年积累才能超越现有平台的想法。这一分析提醒我们在 AI 驱动的科研中,应保持对非主流、长期性研究的关注,避免被短期优化指标所误导。
来源:@dwarkesh_sp
4. AI 推理锁定:比云锁定更隐蔽的风险
文章指出,AI 推理锁定(Inference Lock-in)比传统的云锁定更隐蔽。用户不仅是被数据中心锁定,更是被针对特定模型行为构建的提示词架构、评估逻辑和机构知识所锁定。这种锁定使得迁移模型变得极其困难,因为整个工作流都深度依赖于特定模型的表现。文章提醒开发者在构建 AI 应用时,应意识到这种深层依赖,并考虑如何通过模块化设计降低模型切换的成本,以应对快速变化的 AI 模型生态。
来源:@cline
5. AI 时代的 PM 角色演进
文章分析了产品经理(PM)角色的演进。传统的 PM 手册建立在底层技术相对稳定的假设之上,但在 AI 快速迭代的背景下,这一假设已不再成立。PM 需要从关注功能实现转向关注模型能力边界、提示词工程与用户体验的动态平衡。这种演进要求 PM 具备更强的技术敏感度与快速适应能力,能够处理 AI 模型带来的不确定性,并将 AI 能力转化为实际的产品价值。
来源:@_catwu
6. AI 编码中的“理解债务”
文章指出,AI 编码在提升效率的同时,也带来了“理解债务”(Comprehension Debt)。开发者虽然能够快速生成代码,但往往缺乏对代码逻辑的深入理解,导致在后续维护中面临巨大的认知负担。这种现象类似于技术债务,但更隐蔽且难以量化。文章呼吁开发者在享受 AI 带来的便利时,仍需保持对代码质量与逻辑的掌控,避免陷入“只管生成,不管理解”的陷阱。
来源:@Hesamation
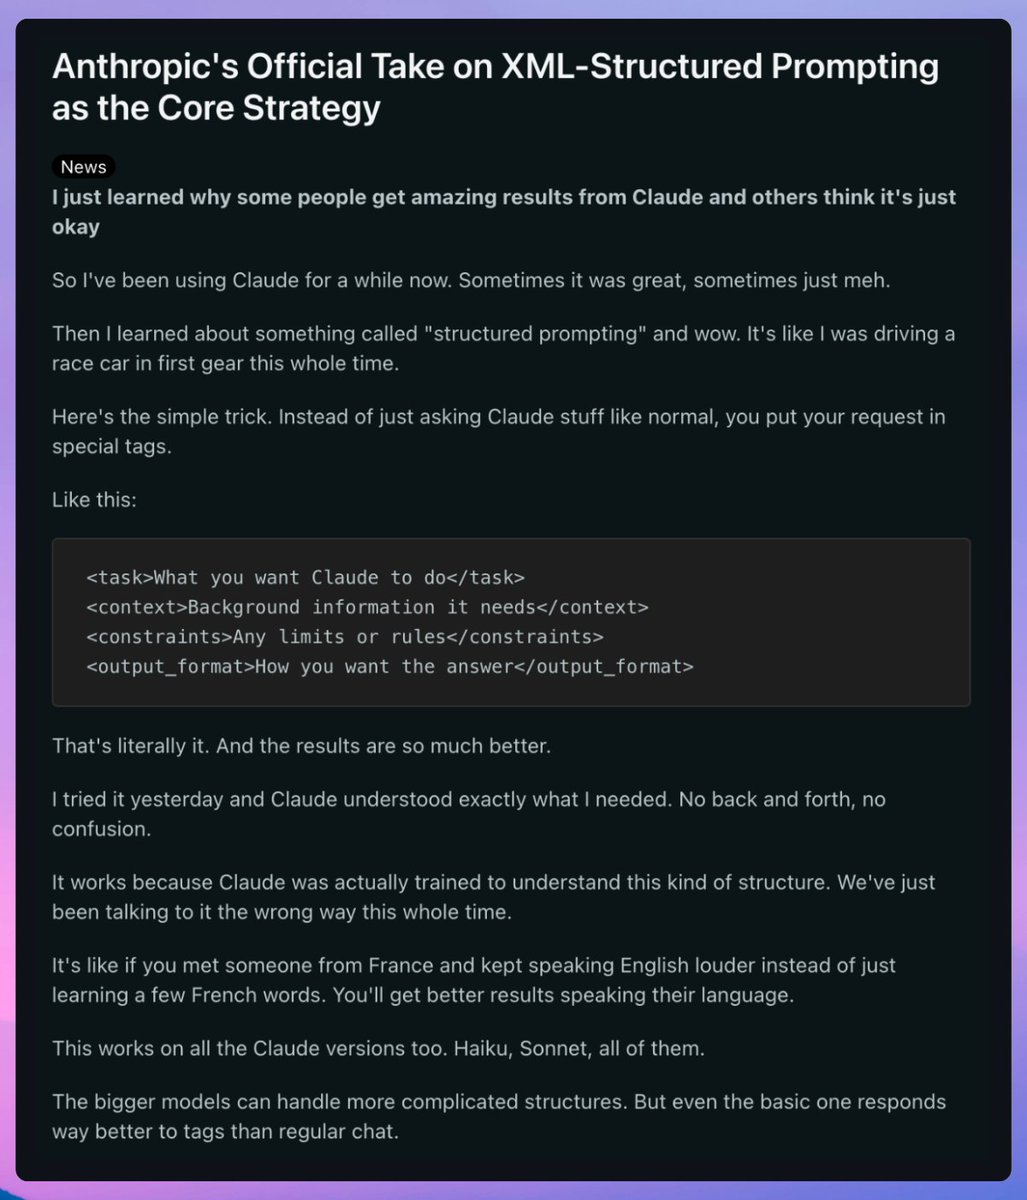
7. 提示词工程的范式转移:XML 结构化提示
文章认为传统的提示词工程正在失效,Anthropic 发布的一份内部手册揭示了 XML 结构化提示词的重要性。这种方法通过 XML 标签明确界定上下文、指令与数据,显著提升了模型对复杂任务的理解与执行能力。文章指出,只有极少数用户掌握了这一技巧。这一范式转移标志着提示词工程正从“自然语言描述”向“结构化编程”演进,是提升 Agent 稳定性的关键。
来源:@heyrimsha
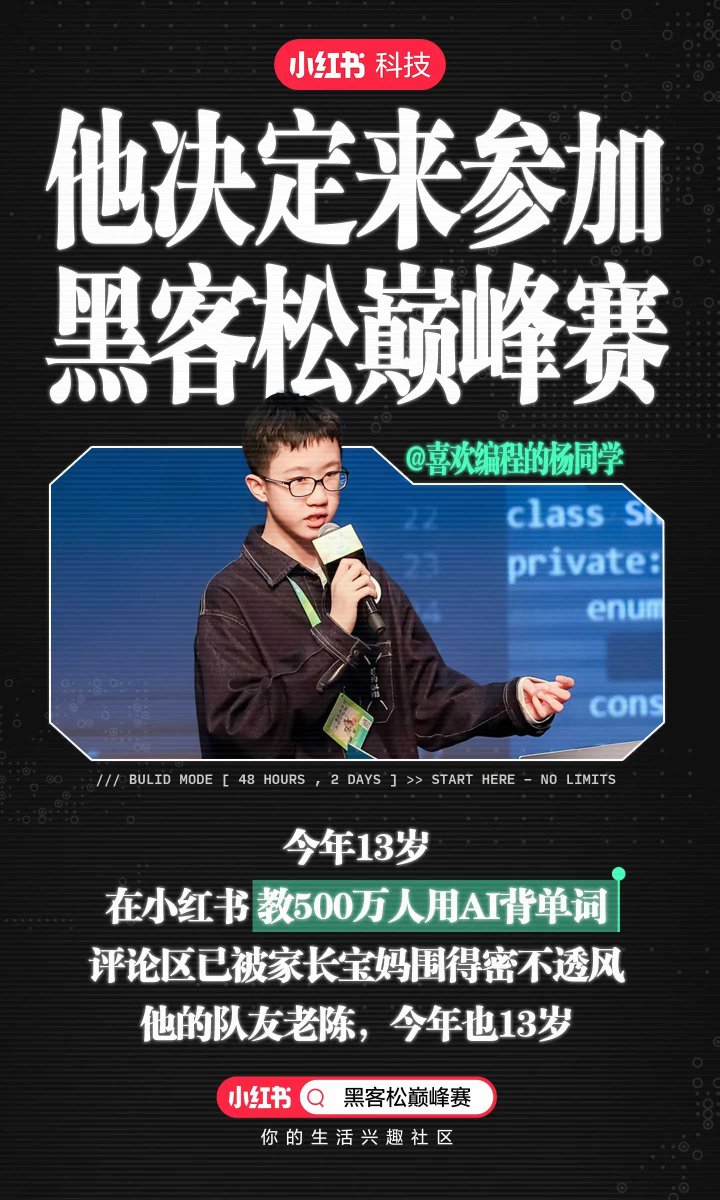
8. 黑客松与新生代开发者的想象力
文章通过小红书黑客松的案例,探讨了新生代开发者在 AI 时代所展现的独特想象力。在行业共识尚未定型时,年轻人选择了一条偏门但充满想象力的路径,将二维码与生图结合。文章认为,真正新的机会往往诞生在还没人完全看懂、还没被充分命名的地方。鼓励开发者不要等到 AI 时代被定义完成才参与,而应在一切还没定型时就参与进去,因为成熟的方向往往属于旧世界。

9. 项目记忆结构:AI 编码问题的本质
文章分析认为,AI 编码模型不稳定、上下文不足等问题,本质上是因为项目本身缺乏记忆结构。许多所谓的 AI 问题,其实是工程问题在 AI 场景下被放大了。真相源漂移、职责混写、控制面失效等问题以前就有,只是现在变成了显性问题。文章建议将此分析作为 Checklist 对照自己的项目,强调了在 AI 时代,构建良好的项目记忆结构对于提升 Agent 性能至关重要。


来源:@frxiaobei